Kronos: een foundationmodel dat candlestickcharts de taal van transformers leert spreken
Review van Kronos, een foundationmodel voor het voorspellen van OHLCV-candles. BSQ-tokenizer, hiërarchische decoder, tweetraps sampling, Qlib-trainingspipeline. Hoe een model de 'taal' van de beurs leert.
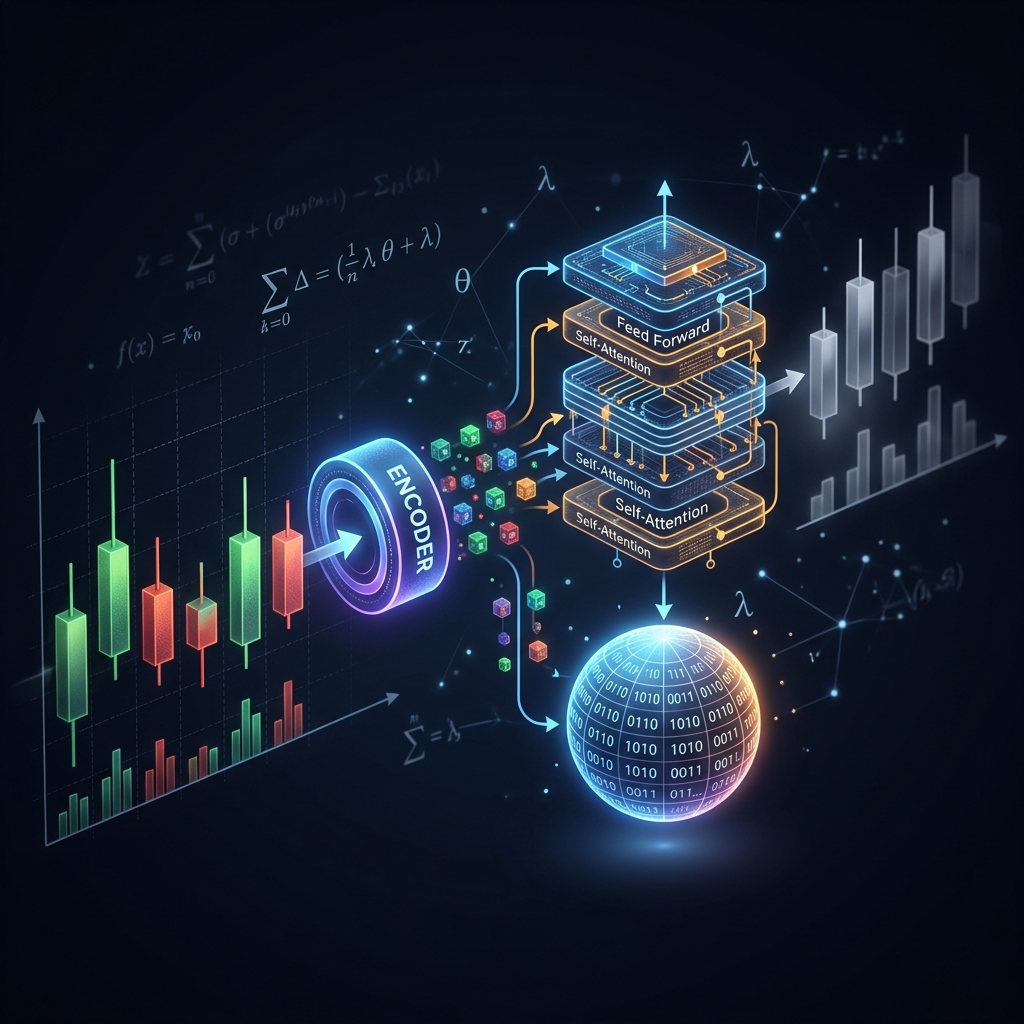

Als de markt ruis is, dan lijkt elke poging om de volgende candle te voorspellen op het decoderen van radiostatica. De auteurs van Kronos stellen een radicale aanpak voor: beurscandles omzetten in discrete tokens (zoals woorden in een taal) en een transformer trainen om het "volgende woord" te voorspellen — dus de volgende candle.
Dit is geen universele tijdreeks-transformer "voor alle gelegenheden", maar een gespecialiseerd model voor multidimensionale K-lines (OHLCV) met kalenderkenmerken. De repository shiyu-coder/Kronos is open onder MIT-licentie, de gewichten staan op Hugging Face, en het paper is geaccepteerd op AAAI 2026.
Kernidee: candles = taal
Net zoals ChatGPT leert het volgende woord in een tekst te voorspellen, leert Kronos de volgende candle in een prijsreeks te voorspellen. Maar eerst moet een belangrijk probleem worden opgelost: een candle is een continue vector (open, high, low, close, volume), terwijl transformers werken met discrete tokens.
De oplossing — een architectuur met twee niveaus:
- Tokenizer (BSQ) — comprimeert de continue candle tot een discrete code
- Decoder (transformer) — voorspelt de volgende code autoregressief
BSQ-tokenizer: hoe comprimeer je een candle tot twee getallen

De sleutelmodule — Binary Spherical Quantizer (BSQ):
- De continue candle-vector wordt geprojecteerd op een bol (
F.normalize) - Vervolgens gekwantiseerd tot een binaire code
- De code wordt gesplitst in twee niveaus: grof (S1) en gedetailleerd (S2)
Dit is vocabulairefactorisatie: in plaats van één enorm woordenboek ter grootte van S1 × S2 gebruikt het model twee kleine embedding-tabellen — veel efficiënter.
Hiërarchische decoder: eerst het scenario, dan de details
De dubbele kop (DualHead) werkt achtereenvolgens:
- Eerst voorspelt het model S1 — het "ruwe scenario" (gaat het omhoog? omlaag? ongeveer hoeveel?)
- Vervolgens, met S1 vastgezet, verfijnt het S2 — details (exacte prijzen, volume)
Links
- 💻 GitHub: shiyu-coder/Kronos
- 📄 Paper: arXiv:2508.02739
- 📄 License: MIT
Conclusie
Kronos is niet "nog een transformer voor tijdreeksen", maar een coherente pipeline: BSQ-tokenizer met codebook-controle, hiërarchisch taalmodel met twee discretisatieniveaus, autoregressie met tweetraps sampling, lokale vensternormalisatie. Het is een open implementatie van het idee "candles = taal".