Kronos: Ein Foundation-Modell, das Candlestick-Charts das Sprechen in Transformer-Sprache beibringt
Review zu Kronos - einem Foundation-Modell für OHLCV-Candle-Prognosen. BSQ-Tokenizer, hierarchischer Decoder, zweistufiges Sampling, Qlib-Trainingspipeline. Wie ein Modell die 'Sprache' der Börse lernt.
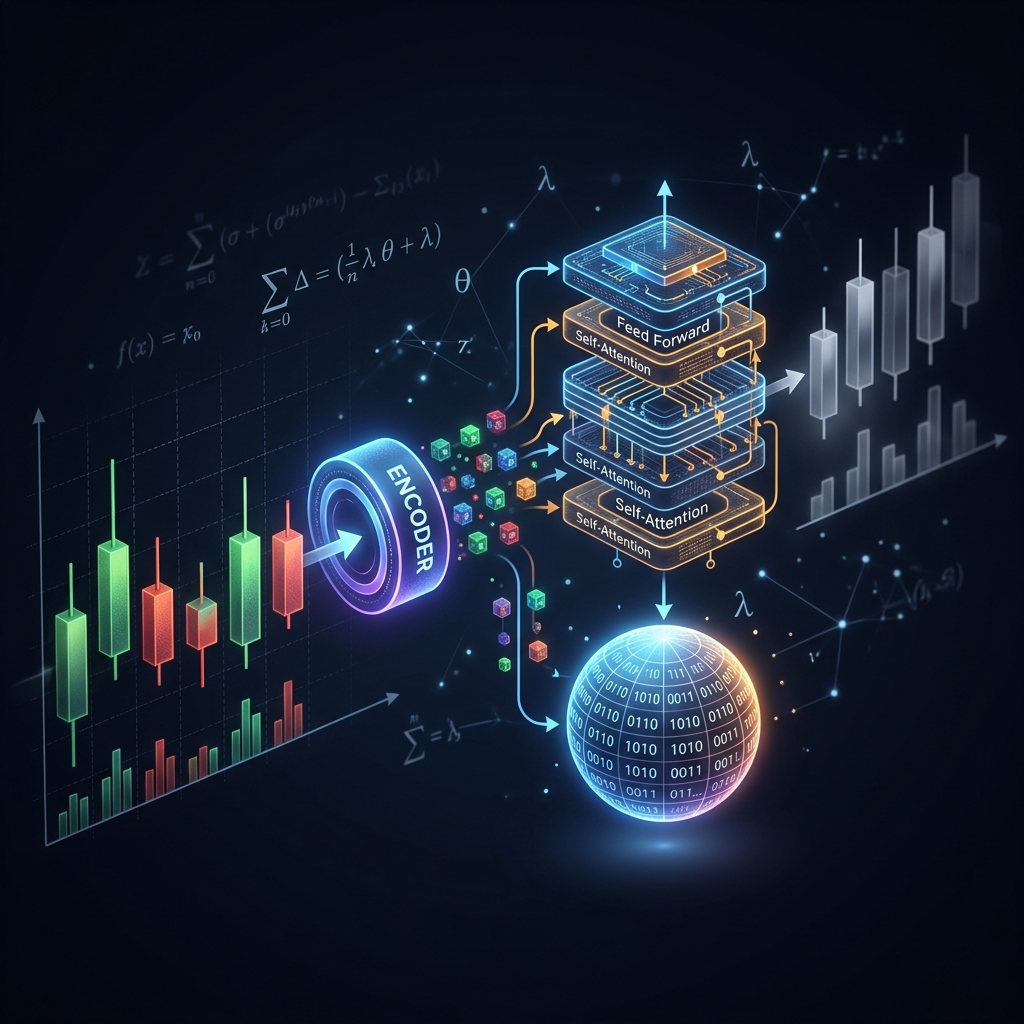

Wenn der Markt Rauschen ist, dann gleicht jeder Versuch, die nächste Kerze vorherzusagen, dem Dekodieren von Radiostatik. Die Autoren von Kronos schlagen einen radikalen Ansatz vor: Börsenkerzen in diskrete Tokens umwandeln (wie Wörter einer Sprache) und einen Transformer darauf trainieren, das "nächste Wort" vorherzusagen — also die nächste Kerze.
Das ist kein universeller Zeitreihen-Transformer "für alle Fälle", sondern ein spezialisiertes Modell für mehrdimensionale K-Linien (OHLCV) mit Kalendermerkmalen. Das Repository shiyu-coder/Kronos ist unter MIT offen, die Gewichte liegen auf Hugging Face, das Paper wurde bei AAAI 2026 angenommen.
Kernidee: Kerzen = Sprache
So wie ChatGPT lernt, das nächste Wort in einem Text vorherzusagen, lernt Kronos, die nächste Kerze in einer Preisreihe vorherzusagen. Zuerst muss jedoch ein zentrales Problem gelöst werden: Eine Kerze ist ein kontinuierlicher Vektor (Open, High, Low, Close, Volume), während Transformer mit diskreten Tokens arbeiten.
Die Lösung — eine zweistufige Architektur:
- Tokenizer (BSQ) — komprimiert die kontinuierliche Kerze zu einem diskreten Code
- Decoder (Transformer) — sagt den nächsten Code autoregressiv voraus
BSQ-Tokenizer: Wie man eine Kerze in zwei Zahlen komprimiert

Das Schlüsselmodul — Binary Spherical Quantizer (BSQ):
- Der kontinuierliche Kerzenvektor wird auf eine Kugel projiziert (
F.normalize) - Anschließend wird er in einen binären Code quantisiert
- Der Code wird in zwei Ebenen aufgeteilt: grob (S1) und detailliert (S2)
Das ist Vokabular-Faktorisierung: Statt eines riesigen Wörterbuchs der Größe S1 × S2 verwendet das Modell zwei kleine Embedding-Tabellen — deutlich effizienter.
Hierarchischer Decoder: Erst das Szenario, dann die Details
Der Doppelkopf (DualHead) arbeitet nacheinander:
- Zuerst sagt das Modell S1 voraus — das "grobe Szenario" (steigt es? fällt es? um wie viel etwa?)
- Dann, mit fixiertem S1, verfeinert es S2 — Details (exakte Preise, Volumen)
Links
- 💻 GitHub: shiyu-coder/Kronos
- 📄 Paper: arXiv:2508.02739
- 📄 License: MIT
Fazit
Kronos ist nicht "noch ein weiterer Transformer für Zeitreihen", sondern eine kohärente Pipeline: BSQ-Tokenizer mit Codebook-Kontrolle, hierarchisches Sprachmodell mit zwei Diskretisierungsebenen, Autoregression mit zweistufigem Sampling, lokale Fenster-Normalisierung. Es ist eine offene Implementierung der Idee "Kerzen = Sprache".