Kronos: Un Modello Fondamentale che Insegna ai Grafici Candlestick a Parlare il Linguaggio dei Transformer
Recensione di Kronos - un modello fondamentale per la previsione di candele OHLCV. Tokenizer BSQ, decoder gerarchico, campionamento a due fasi, pipeline di addestramento Qlib. Come un modello apprende il 'linguaggio' del mercato.
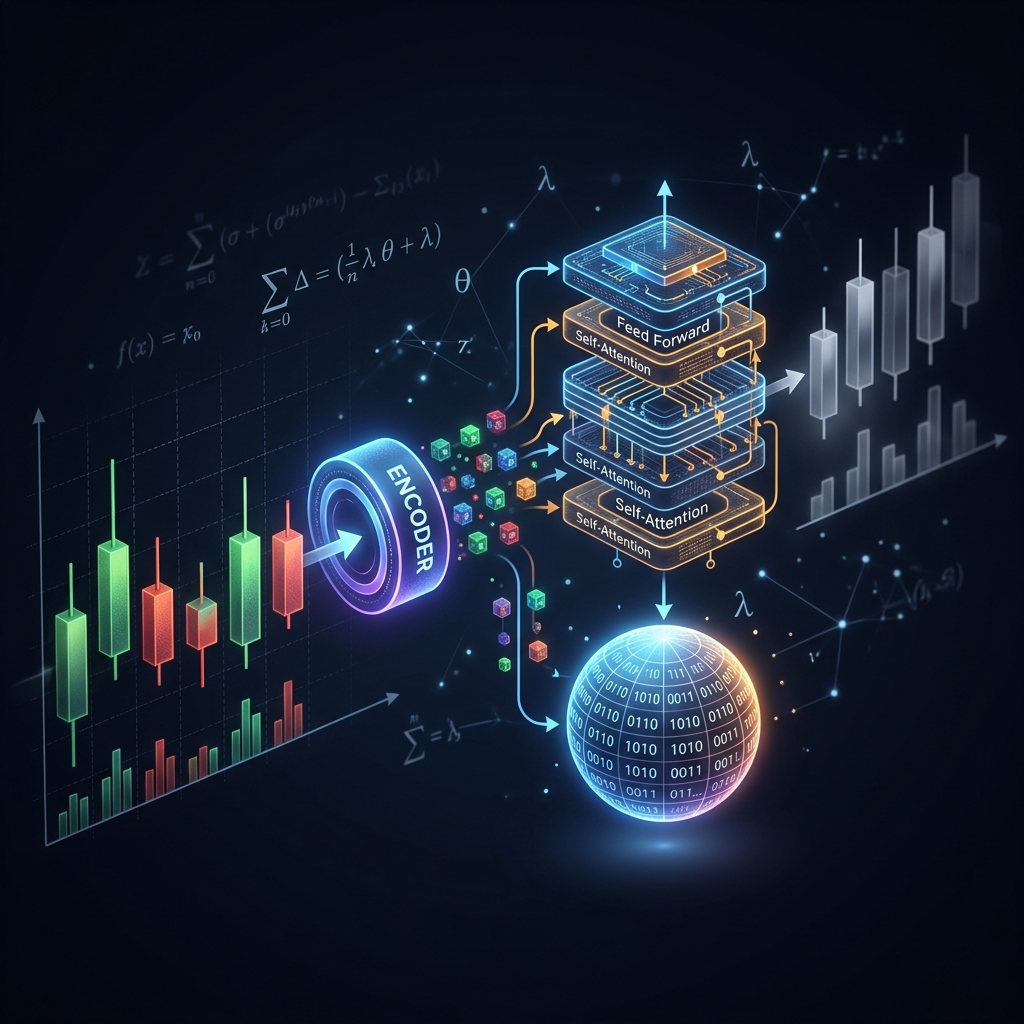

Se il mercato è rumore, allora qualsiasi tentativo di prevedere la prossima candela è come decodificare la statica radio. Gli autori di Kronos propongono un approccio radicale: convertire le candele di borsa in token discreti (come le parole in una lingua) e addestrare un transformer a prevedere la "parola successiva" — ovvero la prossima candela.
Non si tratta di un transformer universale per serie temporali "per tutte le occasioni", ma di un modello specializzato per K-line multidimensionali (OHLCV) con caratteristiche del calendario. Il repository shiyu-coder/Kronos è aperto con licenza MIT, i pesi su Hugging Face, l'articolo accettato a AAAI 2026.
Idea Centrale: Candele = Linguaggio
Proprio come ChatGPT impara a prevedere la parola successiva nel testo, Kronos impara a prevedere la prossima candela in una serie di prezzi. Ma prima occorre risolvere un problema chiave: una candela è un vettore continuo (apertura, massimo, minimo, chiusura, volume), mentre i transformer lavorano con token discreti.
La soluzione — un'architettura a due livelli:
- Tokenizer (BSQ) — comprime la candela continua in un codice discreto
- Decoder (transformer) — predice il codice successivo in modo autoregressivo
Tokenizer BSQ: Come Comprimere una Candela in Due Numeri

Il modulo chiave — Binary Spherical Quantizer (BSQ):
- Il vettore continuo della candela viene proiettato su una sfera (
F.normalize) - Poi quantizzato in un codice binario
- Il codice viene suddiviso in due livelli: grossolano (S1) e dettagliato (S2)
Questa è la fattorizzazione del vocabolario: invece di un unico dizionario massiccio di dimensione S1 × S2, il modello utilizza due piccole tabelle di embedding — molto più efficienti.
Decoder Gerarchico: Prima lo Scenario, Poi i Dettagli
La testa duale (DualHead) lavora in sequenza:
- Prima il modello predice S1 — lo "scenario grezzo" (salita? discesa? all'incirca quanto?)
- Poi con S1 fissato, affina S2 — i dettagli (prezzi esatti, volume)
Link
- 💻 GitHub: shiyu-coder/Kronos
- 📄 Articolo: arXiv:2508.02739
- 📄 Licenza: MIT
Conclusione
Kronos non è "l'ennesimo transformer per serie temporali" ma una pipeline coerente: tokenizer BSQ con controllo del codebook, modello linguistico gerarchico con due livelli di discretizzazione, autoregressione con campionamento a due fasi, normalizzazione su finestra locale. È un'implementazione aperta dell'idea "candele = linguaggio".