Kronos: um modelo de fundação que ensina os gráficos de candles a falar a linguagem dos transformers
Análise do Kronos, um modelo de fundação para previsão de candles OHLCV. Tokenizador BSQ, decodificador hierárquico, amostragem em duas etapas, pipeline de treinamento Qlib. Como um modelo aprende a 'linguagem' da bolsa.
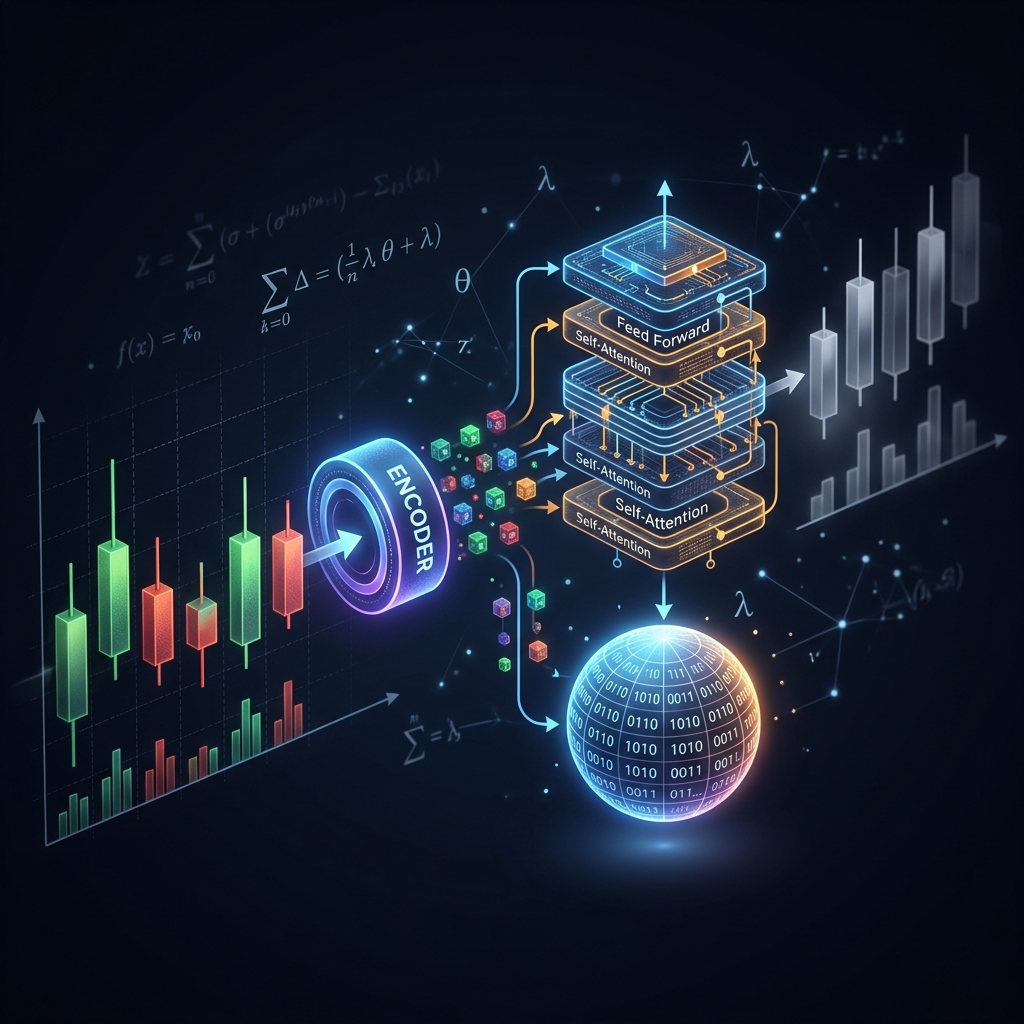

Se o mercado é ruído, então qualquer tentativa de prever o próximo candle é como decodificar estática de rádio. Os autores do Kronos propõem uma abordagem radical: converter candles de bolsa em tokens discretos (como palavras de um idioma) e treinar um transformer para prever a "próxima palavra" — ou seja, o próximo candle.
Não se trata de um transformer universal de séries temporais "para todas as ocasiões", mas de um modelo especializado em K-lines multidimensionais (OHLCV) com características de calendário. O repositório shiyu-coder/Kronos é aberto sob a licença MIT, os pesos estão no Hugging Face, e o artigo foi aceito na AAAI 2026.
Ideia central: candles = linguagem
Assim como o ChatGPT aprende a prever a próxima palavra em um texto, o Kronos aprende a prever o próximo candle em uma série de preços. Mas primeiro é preciso resolver um problema fundamental: um candle é um vetor contínuo (abertura, máxima, mínima, fechamento, volume), enquanto os transformers trabalham com tokens discretos.
A solução é uma arquitetura de dois níveis:
- Tokenizador (BSQ) — comprime o candle contínuo em um código discreto
- Decodificador (transformer) — prevê o próximo código de forma autorregressiva
Tokenizador BSQ: como comprimir um candle em dois números

O módulo-chave — Binary Spherical Quantizer (BSQ):
- O vetor contínuo do candle é projetado sobre uma esfera (
F.normalize) - Em seguida, é quantizado em um código binário
- O código é dividido em dois níveis: grosseiro (S1) e detalhado (S2)
Isso é fatoração de vocabulário: em vez de um dicionário enorme de tamanho S1 × S2, o modelo usa duas tabelas de embeddings pequenas — muito mais eficiente.
Decodificador hierárquico: primeiro o cenário, depois os detalhes
A cabeça dupla (DualHead) trabalha em sequência:
- Primeiro o modelo prevê S1 — o "cenário aproximado" (vai subir? vai cair? aproximadamente quanto?)
- Depois, com S1 fixado, refina S2 — detalhes (preços exatos, volume)
Links
- 💻 GitHub: shiyu-coder/Kronos
- 📄 Paper: arXiv:2508.02739
- 📄 License: MIT
Conclusão
O Kronos não é "mais um transformer para séries temporais", mas um pipeline coerente: tokenizador BSQ com controle de codebook, modelo de linguagem hierárquico com dois níveis de discretização, autorregressão com amostragem em duas etapas, normalização local por janela. É uma implementação aberta da ideia "candles = linguagem".