Kronos : un modèle de fondation qui apprend aux chandeliers japonais à parler le langage des transformers
Revue de Kronos, un modèle de fondation pour la prévision de chandeliers OHLCV. Tokenizer BSQ, décodeur hiérarchique, échantillonnage en deux étapes, pipeline d'entraînement Qlib. Comment un modèle apprend le « langage » de la bourse.
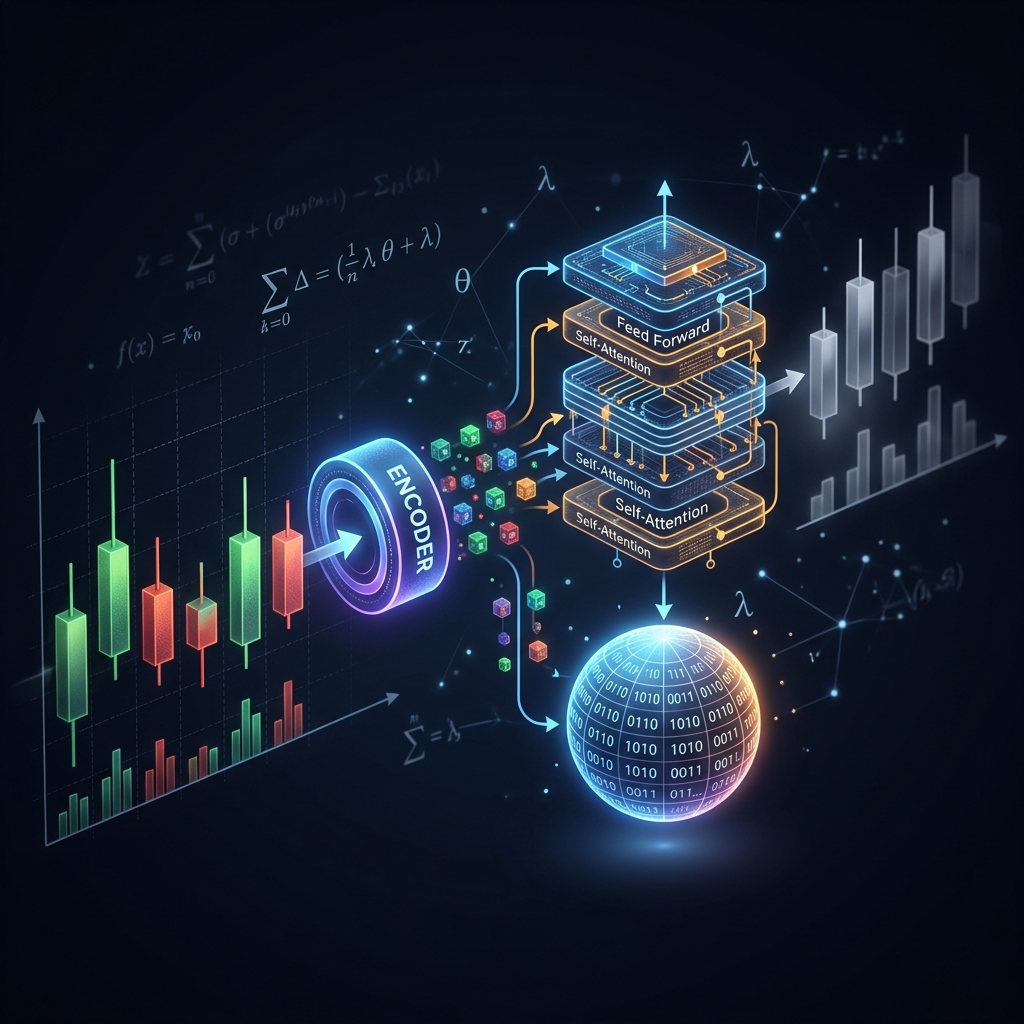

Si le marché n'est que du bruit, alors toute tentative de prédire le prochain chandelier revient à décoder de la friture radio. Les auteurs de Kronos proposent une approche radicale : convertir les chandeliers boursiers en tokens discrets (comme des mots d'une langue) et entraîner un transformer à prédire le « mot suivant » — c'est-à-dire le prochain chandelier.
Il ne s'agit pas d'un transformer universel de séries temporelles « à tout faire », mais d'un modèle spécialisé pour les chandeliers multidimensionnels (OHLCV) avec caractéristiques calendaires. Le dépôt shiyu-coder/Kronos est ouvert sous licence MIT, les poids sont sur Hugging Face, et l'article a été accepté à AAAI 2026.
Idée centrale : les chandeliers comme langage
Tout comme ChatGPT apprend à prédire le mot suivant dans un texte, Kronos apprend à prédire le prochain chandelier dans une série de prix. Mais il faut d'abord résoudre un problème clé : un chandelier est un vecteur continu (ouverture, haut, bas, clôture, volume), alors que les transformers travaillent avec des tokens discrets.
La solution : une architecture à deux niveaux :
- Tokenizer (BSQ) — compresse le chandelier continu en un code discret
- Décodeur (transformer) — prédit le code suivant de manière autorégressive
Tokenizer BSQ : comment compresser un chandelier en deux nombres

Le module clé — Binary Spherical Quantizer (BSQ) :
- Le vecteur continu du chandelier est projeté sur une sphère (
F.normalize) - Il est ensuite quantifié en un code binaire
- Le code est divisé en deux niveaux : grossier (S1) et détaillé (S2)
C'est une factorisation du vocabulaire : au lieu d'un dictionnaire massif de taille S1 × S2, le modèle utilise deux petites tables d'embeddings — bien plus efficace.
Décodeur hiérarchique : d'abord le scénario, puis les détails
La double tête (DualHead) fonctionne en séquence :
- Le modèle prédit d'abord S1 — le « scénario grossier » (ça monte ? ça baisse ? de combien approximativement ?)
- Puis, S1 étant fixé, il affine S2 — les détails (prix exacts, volume)
Liens
- 💻 GitHub : shiyu-coder/Kronos
- 📄 Paper : arXiv:2508.02739
- 📄 License : MIT
Conclusion
Kronos n'est pas « encore un transformer pour séries temporelles », mais un pipeline cohérent : tokenizer BSQ avec contrôle du codebook, modèle de langage hiérarchique à deux niveaux de discrétisation, autorégression avec échantillonnage en deux étapes, normalisation locale par fenêtre. C'est une implémentation ouverte de l'idée « les chandeliers sont un langage ».