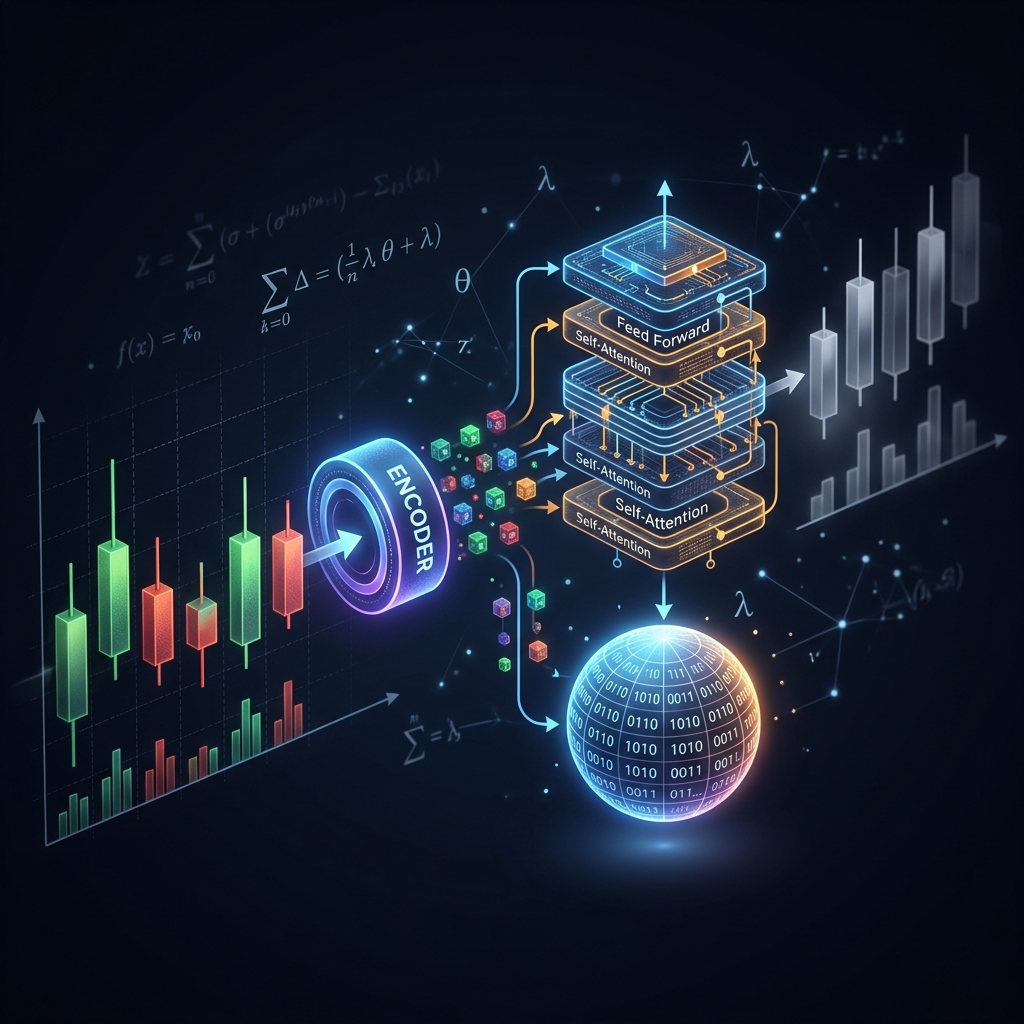

หากตลาดคือเสียงรบกวน การพยายามทำนายแท่งเทียนถัดไปก็เหมือนกับการถอดรหัสคลื่นสัญญาณวิทยุ ผู้เขียน Kronos เสนอแนวทางสุดล้ำ: แปลงแท่งเทียนของตลาดให้เป็น discrete token (เหมือนคำศัพท์ในภาษา) แล้วฝึก transformer ให้ทำนาย "คำถัดไป" — นั่นคือแท่งเทียนถัดไป
นี่ไม่ใช่ transformer สำหรับ time series แบบ "ใช้ได้กับทุกอย่าง" แต่เป็น โมเดลเฉพาะทาง สำหรับ K-line หลายมิติ (OHLCV) พร้อมฟีเจอร์ปฏิทิน repository shiyu-coder/Kronos เปิดภายใต้สัญญาอนุญาต MIT, weights อยู่บน Hugging Face, paper ได้รับการตอบรับที่ AAAI 2026
แนวคิดหลัก: แท่งเทียน = ภาษา
เช่นเดียวกับที่ ChatGPT เรียนรู้การทำนายคำถัดไปในข้อความ Kronos เรียนรู้การทำนายแท่งเทียนถัดไปในกราฟราคา แต่ก่อนอื่นต้องแก้ปัญหาสำคัญ: แท่งเทียนคือ continuous vector (open, high, low, close, volume) ในขณะที่ transformer ทำงานกับ discrete token
วิธีแก้ปัญหา — สถาปัตยกรรมสองชั้น:
- Tokenizer (BSQ) — บีบอัด continuous candle ให้เป็น discrete code
- Decoder (transformer) — ทำนาย code ถัดไปแบบ autoregressive
BSQ Tokenizer: วิธีบีบอัดแท่งเทียนให้เป็นตัวเลขสองตัว

โมดูลหลัก — Binary Spherical Quantizer (BSQ):
- continuous candle vector ถูก project ลงบน sphere (
F.normalize) - จากนั้น quantize เป็น binary code
- code ถูกแบ่งออกเป็น สองระดับ: หยาบ (S1) และละเอียด (S2)
นี่คือ vocabulary factorization: แทนที่จะใช้พจนานุกรมขนาดใหญ่ตัวเดียวที่มีขนาด S1 × S2 โมเดลใช้ embedding table เล็กสองตัว — มีประสิทธิภาพมากกว่ามาก
Hierarchical Decoder: ก่อนเขียนภาพรวม แล้วจึงเติมรายละเอียด
dual head (DualHead) ทำงานตามลำดับ:
- ก่อนอื่นโมเดลทำนาย S1 — "สถานการณ์คร่าวๆ" (ขึ้นหรือลง? ประมาณเท่าไหร่?)
- จากนั้นเมื่อ S1 คงที่แล้ว จะปรับ S2 — รายละเอียด (ราคาที่แน่นอน, volume)
ลิงก์
- 💻 GitHub: shiyu-coder/Kronos
- 📄 Paper: arXiv:2508.02739
- 📄 License: MIT
สรุป
Kronos ไม่ใช่ "transformer สำหรับ time series อีกตัวหนึ่ง" แต่เป็น pipeline ที่สอดคล้องกัน: BSQ tokenizer พร้อมการควบคุม codebook, hierarchical language model สองระดับ discretization, autoregression แบบ two-stage sampling, local window normalization นี่คือ การ implement แนวคิด "candles = language" แบบ open-source