Modelli di Diffusione vs Anarchia delle Criptovalute: Perché DDPM Può Prevedere i Crash di Bitcoin Meglio del Tuo Astrologo
Come i modelli di diffusione stanno rivoluzionando le previsioni sulle criptovalute, superando il caos della volatilità e creando nuove opportunità per il trading algoritmico.
Al Posto di una Prefazione: Quando il Machine Learning Classico Si Arrende
I mercati delle criptovalute sono il posto dove i metodi di previsione tradizionali vengono a morire. I modelli LSTM iniziano a innervosirsi per la volatilità di Bitcoin, i modelli ARIMA vanno in crisi per i bruschi salti di Ethereum, e le reti neurali classiche si arrendono semplicemente quando vedono il grafico di Dogecoin. Ed è allora che entrano in scena i modelli di diffusione — una tecnologia che originariamente ha insegnato ai computer a disegnare gatti, e ora cerca di prevedere quando Bitcoin deciderà di avere un altro "Lunedì Nero".
È curioso che l'architettura che ha dato vita a Stable Diffusion e DALL-E venga ora applicata attivamente all'analisi delle serie temporali finanziarie. E sai cosa? Funziona abbastanza bene. Soprattutto quando gli approcci classici iniziano ad avere allucinazioni a causa dell'estrema volatilità delle criptovalute.
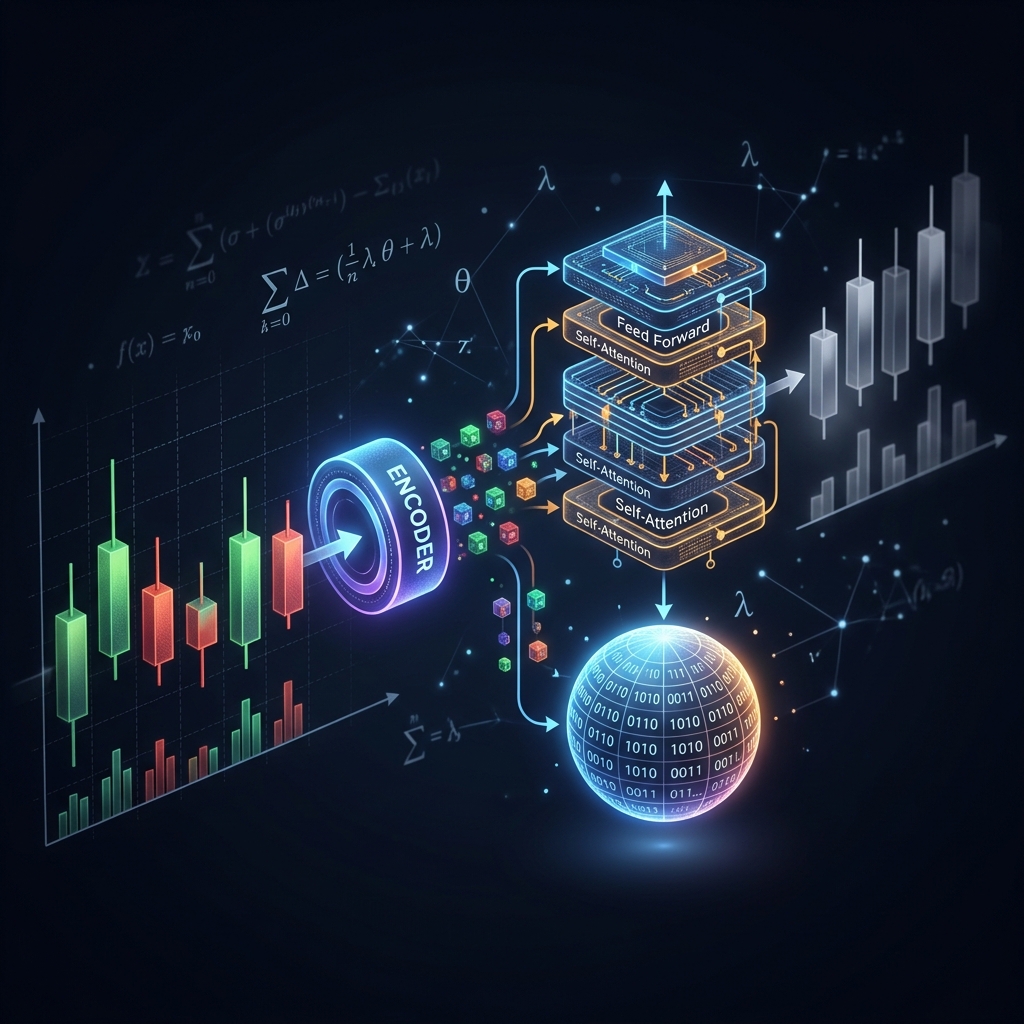
 Dal Caos alla Chiarezza: Come i modelli di diffusione estraggono segnali strutturati dall'ambiente ad alto rumore dei mercati delle criptovalute
Perché i Modelli di Diffusione Funzionano con le Serie Temporali?
I modelli di diffusione sono una classe di modelli generativi che imparano a ripristinare i dati originali dal rumore attraverso un processo di "de-noising" sequenziale. L'idea di base è semplice: prendiamo dati reali, aggiungiamo gradualmente rumore gaussiano fino a ottenere rumore puro, e poi insegniamo a una rete neurale a invertire questo processo.
Nel contesto delle serie temporali finanziarie, ciò significa che il modello impara a separare il segnale dal rumore in senso letterale. I mercati delle criptovalute sono noti per la loro estrema rumorosità — i tweet casuali di Elon Musk, le vendite in preda al panico, gli acquisti dettati da FOMO. Un modello di diffusione può imparare a "vedere" i pattern strutturali attraverso tutto questo caos.
Dal punto di vista matematico, il processo è così:
- Processo forward:
- Processo reverse:
dove è lo schedule del rumore, e sono i parametri della rete neurale.
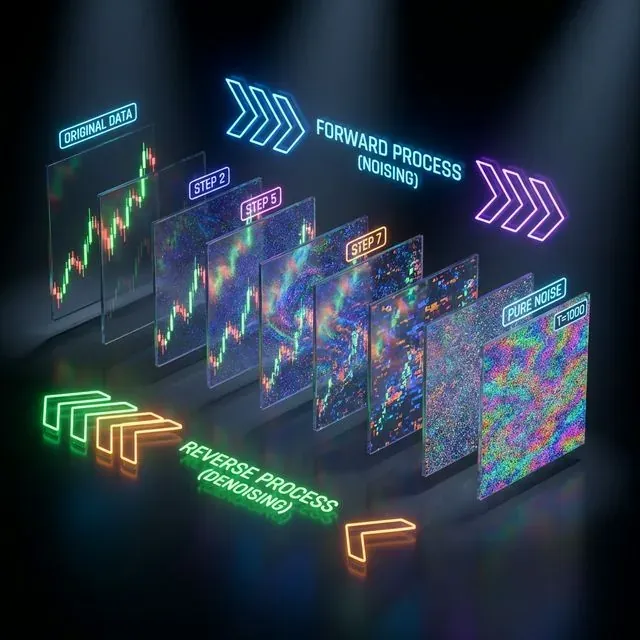 De-noising Sequenziale: Il processo forward (aggiunta di rumore) e il processo reverse (de-noising) per ricostruire serie temporali finanziarie
Librerie Specifiche e Soluzioni Pronte
1. Diffusion-TS: Il Soldato Universale per le Serie Temporali
GitHub: Y-debug-sys/Diffusion-TS
Questa è la libreria di punta per lavorare con i modelli di diffusione per le serie temporali, pubblicata all'ICLR 2024. Il vantaggio principale è che funziona sia in modo condizionale (previsione) che incondizionale (generazione).
import torch
from diffusion_ts import DiffusionTS
import pandas as pd

# Carica i dati di Bitcoin
btc_data = pd.read_csv('btc_prices.csv')
prices = torch.tensor(btc_data['close'].values).float()

# Inizializza il modello
model = DiffusionTS(
    input_dim=1,
    hidden_dim=64,
    num_layers=4,
    max_sequence_length=100,
    num_diffusion_steps=1000
)

# Addestramento
model.fit(prices, epochs=100)

# Previsione delle prossime 24 ore
forecast = model.predict(prices[-100:], forecast_horizon=24)
Il modello utilizza un encoder-decoder transformer con rappresentazioni temporali separate, dove la decomposizione aiuta a catturare il significato semantico delle serie temporali.
2. TSDiff: L'Approccio di Amazon al Caos delle Criptovalute
GitHub: amazon-science/unconditional-time-series-diffusion
Amazon Research ha proposto TSDiff — un modello di diffusione incondizionale che può lavorare con le previsioni attraverso un meccanismo di self-guidance. La peculiarità è che il modello non richiede reti aggiuntive per il condizionamento.
from tsdiff import TSDiff
import numpy as np

# Preparazione dei dati
crypto_data = load_cryptocurrency_data(['BTC', 'ETH', 'LTC'])

# Inizializzazione di TSDiff
tsdiff = TSDiff(
    input_size=crypto_data.shape[-1],
    hidden_size=128,
    num_layers=6,
    diffusion_steps=1000,
    beta_schedule='cosine'
)

# Addestramento del modello incondizionale
tsdiff.train(crypto_data, num_epochs=200)

# Generazione di dati sintetici
synthetic_crypto = tsdiff.sample(num_samples=1000, length=365)

# Previsione condizionale con self-guidance
forecast = tsdiff.forecast_with_guidance(
    context=crypto_data[-30:],  # ultimi 30 giorni
    forecast_length=7,          # previsione settimanale
    guidance_scale=2.0
)
3. FinDiff: Dati Finanziari Tabellari Incontrano la Diffusione
Paper: FinDiff è progettato specificamente per generare dati finanziari tabellari sintetici. Adatto per creare scenari di mercato diversificati.
import torch
from findiff import FinancialDiffusion

# Carica i dati storici delle criptovalute
market_data = pd.read_csv('crypto_market_features.csv')

# FinDiff lavora con dati tabellari
financial_features = [
    'price', 'volume', 'market_cap', 'volatility',
    'rsi', 'macd', 'bollinger_bands'
]

findiff = FinancialDiffusion(
    categorical_columns=['exchange', 'crypto_type'],
    numerical_columns=financial_features,
    embedding_dim=32,
    hidden_dim=256
)

# Addestramento sui dati storici
findiff.fit(market_data[financial_features])

# Generazione di scenari di mercato sintetici
synthetic_scenarios = findiff.generate(n_samples=10000)

# Può essere utilizzato per stress testing
stress_test_data = findiff.generate_conditional(
    conditions={'volatility': '>0.8'}  # alta volatilità
)
4. Implementazione Rapida con pytorch-forecasting
Per chi vuole provare rapidamente i modelli di diffusione in combinazione con architetture consolidate:
import lightning.pytorch as pl
from pytorch_forecasting import TimeSeriesDataSet, TemporalFusionTransformer
from diffusion_wrapper import DiffusionTFT  # wrapper ipotetico

# Preparazione dei dati
crypto_df = pd.read_csv('hourly_crypto_data.csv')

training = TimeSeriesDataSet(
    crypto_df,
    time_idx="hour",
    target="btc_price",
    group_ids=["crypto_pair"],
    max_encoder_length=168,  # una settimana indietro
    max_prediction_length=24,  # un giorno avanti
    time_varying_unknown_reals=["price", "volume", "volatility"],
    time_varying_known_reals=["hour_of_day", "day_of_week"],
)

# Modello ibrido: TFT + diffusione per l'elaborazione del rumore
diffusion_tft = DiffusionTFT.from_dataset(
    training,
    hidden_size=64,
    attention_head_size=4,
    diffusion_steps=100,
    noise_schedule='linear'
)

trainer = pl.Trainer(max_epochs=50, accelerator="gpu")
trainer.fit(diffusion_tft, train_dataloaders=training.to_dataloader(train=True))
Risultati Pratici: Diffusione vs Metodi Classici
La ricerca mostra risultati curiosi. Nel paper "Prediction of Cryptocurrency Prices through a Path Dependent Monte Carlo Simulation", gli autori utilizzano il modello di diffusione a salto di Merton — un ibrido di processi stocastici e machine learning. Il risultato? Il modello è riuscito a catturare sia i cambiamenti graduali dei prezzi che i bruschi salti caratteristici dei mercati delle criptovalute.
Un altro studio ha dimostrato che ADE-TFT (Advanced Deep Learning-Enhanced Temporal Fusion Transformer) con componenti di diffusione supera significativamente gli approcci classici nelle metriche MAPE, MSE e RMSE. I risultati sulla configurazione a 8 livelli nascosti sono particolarmente impressionanti.
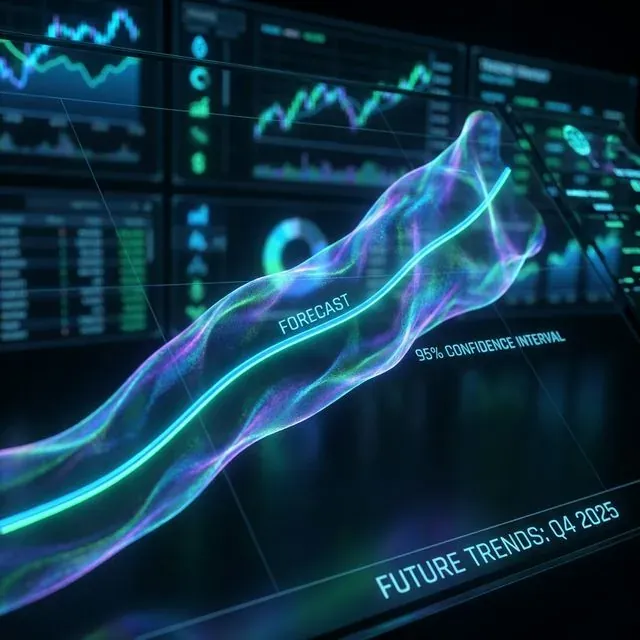 Previsione Probabilistica: Utilizzo dei modelli di diffusione per generare percorsi futuri dei prezzi con gli intervalli di confidenza associati
Il Lato Oscuro dei Modelli di Diffusione in Finanza
Ma siamo onesti. I modelli di diffusione non sono una pallottola d'argento. Hanno problemi seri:
1. Voracità Computazionale
Addestrare un modello di diffusione sui dati delle criptovalute richiede risorse computazionali significative. Se il tuo modello esegue 1000 passi di diffusione, per ottenere una previsione sono necessari 1000 passaggi attraverso la rete neurale. Questo non è molto adatto per il trading ad alta frequenza.
2. Il Problema del Cigno Nero
I mercati delle criptovalute sono noti per gli eventi estremi — crash del 50% in un giorno, divieto delle criptovalute in Cina, hack di un grande exchange. I modelli di diffusione addestrati su dati storici prevedono male tali eventi.
3. Dipendenza dal Regime
I mercati delle criptovalute hanno vari regimi comportamentali — mercato toro, mercato orso, movimento laterale. Un modello di diffusione può funzionare egregiamente in un regime e fallire completamente in un altro.
Ottimizzazione e Accelerazione: Come Non Fallire sulle GPU
Token Merging per la Diffusione
GitHub: dbolya/tomesd
La libreria Token Merging consente di accelerare i modelli di diffusione di 1,24x senza perdita di qualità, unendo i token ridondanti:
import tomesd
from diffusion_model import CryptoDiffusion

model = CryptoDiffusion(...)

# Applica Token Merging
tomesd.apply_patch(model, ratio=0.7)  # rimuovi il 30% dei token

# L'addestramento e l'inferenza accelerano senza perdita di accuratezza
forecast = model.predict(btc_data)
Cached Adaptive Token Merging
GitHub: omidiu/ca_tome
CA-ToMe combina ottimizzazione spaziale e temporale, particolarmente importante per le serie temporali:
from ca_tome import apply_ca_tome

# Applica il token merging con cache
apply_ca_tome(
    model,
    threshold=0.7,
    caching_steps=[0, 10, 20, 30, 40]  # cache ogni 10 passi
)
Esempio Pratico: Pipeline Completa per Bitcoin
Ecco un esempio realistico di come utilizzare i modelli di diffusione per la previsione di Bitcoin:
import torch
import pandas as pd
import numpy as np
from sklearn.preprocessing import MinMaxScaler
from diffusion_ts import DiffusionTS

class CryptoDiffusionPipeline:
    def __init__(self, sequence_length=100, forecast_horizon=24):
        self.sequence_length = sequence_length
        self.forecast_horizon = forecast_horizon
        self.scaler = MinMaxScaler()
        self.model = None

    def prepare_data(self, crypto_data):
        """Preparazione dei dati considerando le caratteristiche delle criptovalute"""
        # Calcola gli indicatori tecnici
        crypto_data['returns'] = crypto_data['close'].pct_change()
        crypto_data['volatility'] = crypto_data['returns'].rolling(24).std()
        crypto_data['rsi'] = self.compute_rsi(crypto_data['close'])

        # Normalizzazione
        features = ['close', 'volume', 'volatility', 'rsi']
        scaled_data = self.scaler.fit_transform(crypto_data[features])

        return scaled_data

    def train_model(self, data):
        """Addestramento del modello di diffusione"""
        self.model = DiffusionTS(
            input_dim=data.shape[1],
            hidden_dim=128,
            num_layers=6,
            diffusion_steps=1000,
            noise_schedule='cosine',
            loss_type='l2'
        )

        # Crea sequenze per l'addestramento
        X, y = self.create_sequences(data)

        self.model.fit(
            X, y,
            epochs=200,
            batch_size=32,
            learning_rate=1e-4,
            validation_split=0.2
        )

    def forecast(self, recent_data):
        """Previsione con intervalli di confidenza"""
        # Genera diversi campioni per la stima dell'incertezza
        predictions = []

        for _ in range(100):  # campionamento Monte Carlo
            pred = self.model.sample_forecast(
                context=recent_data[-self.sequence_length:],
                horizon=self.forecast_horizon
            )
            predictions.append(pred)

        predictions = np.array(predictions)

        # Calcola le statistiche
        mean_pred = np.mean(predictions, axis=0)
        std_pred = np.std(predictions, axis=0)

        return {
            'forecast': mean_pred,
            'confidence_95': mean_pred + 1.96 * std_pred,
            'confidence_5': mean_pred - 1.96 * std_pred
        }

# Utilizzo
pipeline = CryptoDiffusionPipeline()
btc_data = pd.read_csv('btc_hourly.csv')

# Preparazione e addestramento
prepared_data = pipeline.prepare_data(btc_data)
pipeline.train_model(prepared_data)

# Previsione
forecast_result = pipeline.forecast(prepared_data)
print(f"Previsione Bitcoin per le prossime 24h: {forecast_result['forecast'][-1]:.2f}")
Quando Dovresti Usare i Modelli di Diffusione?
Vale la pena usarli se:
- Hai molti dati storici (minimo un anno di dati orari)
- Puoi permetterti un addestramento lungo (giorni-settimane su GPU)
- Hai bisogno di generazione di scenari sintetici per il backtesting
- Lavori con serie temporali multivariate
- L'estimazione dell'incertezza delle previsioni è importante
Non vale la pena usarli se:
- Hai bisogno di previsioni rapide in tempo reale
- Lavori con serie temporali brevi
- Hai risorse computazionali limitate
- L'interpretabilità del modello è critica
Il Futuro dei Modelli di Diffusione nell'Analisi delle Crypto
I modelli di diffusione in finanza sono come le criptovalute nel 2010. La tecnologia è grezza, ad alto consumo di risorse, ma il potenziale è enorme. Stiamo già vedendo approcci ibridi: DDPM + Transformer, diffusione + reinforcement learning, diffusione condizionale per i regimi di mercato.
La prossima svolta è attesa nella diffusione multimodale — modelli che terranno conto non solo dei prezzi ma anche delle notizie, dei segnali social, delle metriche on-chain. Immagina un modello di diffusione che "vede" la correlazione tra il tweet di Elon Musk e il movimento di Dogecoin.
Conclusione: La Diffusione come Evoluzione, Non Rivoluzione
I modelli di diffusione non sostituiranno gli approcci classici alla previsione delle criptovalute. Li complementeranno. LSTM rimarrà per le previsioni rapide, ARIMA — per le sezioni stazionarie, e la diffusione si occuperà della generazione di scenari e del lavoro con l'estrema volatilità.
La lezione principale: nel mondo delle criptovalute, non esistono pallottole d'argento. C'è solo la combinazione intelligente degli strumenti, una profonda comprensione del mercato e uno scetticismo sano verso qualsiasi soluzione "rivoluzionaria". I modelli di diffusione sono uno strumento potente, ma ricorda: stanno solo cercando di trovare pattern nel caos. E il caos, come sappiamo, non ama molto essere previsto.
P.S.: Se il tuo modello di diffusione mostra un'accuratezza del 95% nelle previsioni di Bitcoin — controlla il codice due volte. Molto probabilmente c'è una perdita di dati (data leakage) da qualche parte 😉