Diffusionsmodelle vs. Kryptowährungs-Anarchie: Warum DDPM Bitcoin-Crashs besser vorhersagen kann als Ihr Astrologe
Wie Diffusionsmodelle die Kryptowährungsprognose revolutionieren, das Chaos der Volatilität überwinden und neue Möglichkeiten für den algorithmischen Handel schaffen.
Statt eines Vorworts: Wenn klassisches Machine Learning kapituliert
Kryptowährungsmärkte sind der Ort, an dem traditionelle Prognosemethoden sterben. LSTM-Modelle werden angesichts der Volatilität von Bitcoin nervös, ARIMA-Modelle bekommen bei den scharfen Sprüngen von Ethereum Hysterie, und klassische neuronale Netze geben schlicht auf, sobald sie den Chart von Dogecoin sehen. Und dann betreten Diffusionsmodelle die Bühne — eine Technologie, die Computern ursprünglich beibrachte, Katzen zu zeichnen, und die nun versucht vorherzusagen, wann Bitcoin sich für den nächsten "Schwarzen Montag" entscheidet.
Amüsanterweise wird die Architektur, die Stable Diffusion und DALL-E hervorgebracht hat, inzwischen aktiv für die Analyse finanzieller Zeitreihen eingesetzt. Und wissen Sie was? Sie funktioniert erstaunlich gut. Besonders dann, wenn klassische Ansätze angesichts extremer Kryptowährungsvolatilität zu halluzinieren beginnen.
 Vom Chaos zur Klarheit: Wie Diffusionsmodelle strukturierte Signale aus dem stark verrauschten Umfeld der Kryptowährungsmärkte extrahieren
Warum funktionieren Diffusionsmodelle überhaupt mit Zeitreihen?
Diffusionsmodelle sind eine Klasse generativer Modelle, die lernen, Originaldaten aus Rauschen durch einen Prozess des sequentiellen "Entrauschens" wiederherzustellen. Die Grundidee ist einfach: Man nimmt reale Daten, fügt ihnen schrittweise Gaußsches Rauschen hinzu, bis nur noch reines Rauschen übrig bleibt, und trainiert dann ein neuronales Netz darauf, diesen Prozess umzukehren.
Im Kontext finanzieller Zeitreihen bedeutet das, dass das Modell lernt, Signal von Rauschen im buchstäblichen Sinne zu trennen. Kryptowährungsmärkte sind für ihre extreme Verrauschtheit bekannt — zufällige Tweets von Elon Musk, panische Verkäufe, FOMO-Käufe. Ein Diffusionsmodell kann lernen, strukturelle Muster durch dieses ganze Chaos hindurch zu "erkennen".
Mathematisch sieht der Prozess folgendermaßen aus:
- Vorwärtsprozess:
- Rückwärtsprozess:
wobei der Rauschplan (Noise Schedule) ist und die Parameter des neuronalen Netzes sind.
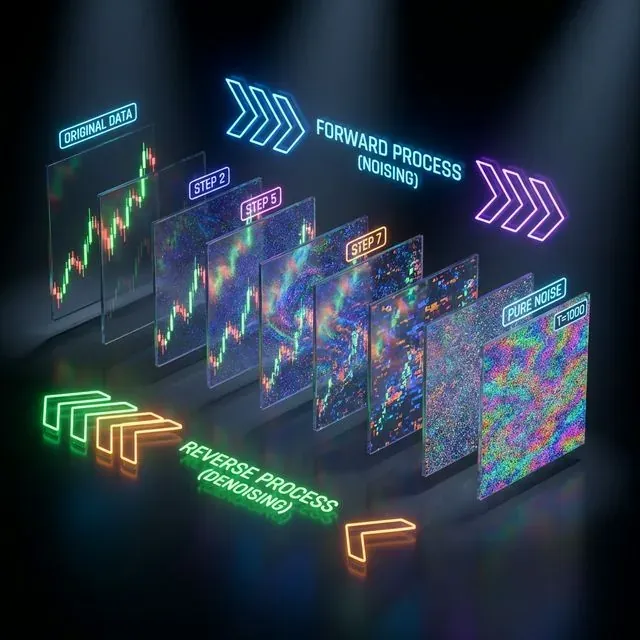 Sequentielles Entrauschen: Der Vorwärtsprozess (Hinzufügen von Rauschen) und der Rückwärtsprozess (Entrauschen) zur Rekonstruktion finanzieller Zeitreihen
Konkrete Bibliotheken und fertige Lösungen
1. Diffusion-TS: Der Allrounder für Zeitreihen
GitHub: Y-debug-sys/Diffusion-TS
Dies ist die Flaggschiff-Bibliothek für die Arbeit mit Diffusionsmodellen für Zeitreihen, veröffentlicht auf der ICLR 2024. Der Hauptvorteil ist, dass sie sowohl bedingt (Prognose) als auch unbedingt (Generierung) arbeitet.
import torch
from diffusion_ts import DiffusionTS
import pandas as pd

# Load Bitcoin data
btc_data = pd.read_csv('btc_prices.csv')
prices = torch.tensor(btc_data['close'].values).float()

# Initialize model
model = DiffusionTS(
    input_dim=1,
    hidden_dim=64,
    num_layers=4,
    max_sequence_length=100,
    num_diffusion_steps=1000
)

# Training
model.fit(prices, epochs=100)

# Forecasting next 24 hours
forecast = model.predict(prices[-100:], forecast_horizon=24)
Das Modell verwendet einen Encoder-Decoder-Transformer mit getrennten zeitlichen Repräsentationen, wobei die Zerlegung hilft, die semantische Bedeutung der Zeitreihe zu erfassen.
2. TSDiff: Amazons Ansatz für das Kryptowährungs-Chaos
GitHub: amazon-science/unconditional-time-series-diffusion
Amazon Research hat TSDiff vorgeschlagen — ein unbedingtes Diffusionsmodell, das über einen Self-Guidance-Mechanismus auch für Prognosen eingesetzt werden kann. Die Besonderheit besteht darin, dass das Modell keine zusätzlichen Netzwerke für die Konditionierung benötigt.
from tsdiff import TSDiff
import numpy as np

# Data preparation
crypto_data = load_cryptocurrency_data(['BTC', 'ETH', 'LTC'])

# TSDiff initialization
tsdiff = TSDiff(
    input_size=crypto_data.shape[-1],
    hidden_size=128,
    num_layers=6,
    diffusion_steps=1000,
    beta_schedule='cosine'
)

# Training unconditional model
tsdiff.train(crypto_data, num_epochs=200)

# Generating synthetic data
synthetic_crypto = tsdiff.sample(num_samples=1000, length=365)

# Conditional forecasting with self-guidance
forecast = tsdiff.forecast_with_guidance(
    context=crypto_data[-30:],  # last 30 days
    forecast_length=7,          # week forecast
    guidance_scale=2.0
)
3. FinDiff: Tabellarische Finanzdaten treffen auf Diffusion
Paper: FinDiff wurde speziell für die Generierung synthetischer tabellarischer Finanzdaten entwickelt. Geeignet für die Erstellung vielfältiger Marktszenarien.
import torch
from findiff import FinancialDiffusion

# Load historical cryptocurrency data
market_data = pd.read_csv('crypto_market_features.csv')

# FinDiff works with tabular data
financial_features = [
    'price', 'volume', 'market_cap', 'volatility',
    'rsi', 'macd', 'bollinger_bands'
]

findiff = FinancialDiffusion(
    categorical_columns=['exchange', 'crypto_type'],
    numerical_columns=financial_features,
    embedding_dim=32,
    hidden_dim=256
)

# Training on historical data
findiff.fit(market_data[financial_features])

# Generating synthetic market scenarios
synthetic_scenarios = findiff.generate(n_samples=10000)

# Can be used for stress testing
stress_test_data = findiff.generate_conditional(
    conditions={'volatility': '>0.8'}  # high volatility
)
4. Schnelle Implementierung mit pytorch-forecasting
Für alle, die Diffusionsmodelle schnell in Kombination mit bewährten Architekturen ausprobieren möchten:
import lightning.pytorch as pl
from pytorch_forecasting import TimeSeriesDataSet, TemporalFusionTransformer
from diffusion_wrapper import DiffusionTFT  # hypothetical wrapper

# Data preparation
crypto_df = pd.read_csv('hourly_crypto_data.csv')

training = TimeSeriesDataSet(
    crypto_df,
    time_idx="hour",
    target="btc_price",
    group_ids=["crypto_pair"],
    max_encoder_length=168,  # week back
    max_prediction_length=24,  # day forward
    time_varying_unknown_reals=["price", "volume", "volatility"],
    time_varying_known_reals=["hour_of_day", "day_of_week"],
)

# Hybrid model: TFT + diffusion for noise processing
diffusion_tft = DiffusionTFT.from_dataset(
    training,
    hidden_size=64,
    attention_head_size=4,
    diffusion_steps=100,
    noise_schedule='linear'
)

trainer = pl.Trainer(max_epochs=50, accelerator="gpu")
trainer.fit(diffusion_tft, train_dataloaders=training.to_dataloader(train=True))
Praktische Ergebnisse: Diffusion vs. Klassiker
Studien zeigen bemerkenswerte Ergebnisse. Im Paper "Prediction of Cryptocurrency Prices through a Path Dependent Monte Carlo Simulation" verwenden die Autoren Mertons Sprungdiffusionsmodell — eine Hybridlösung aus stochastischen Prozessen und Machine Learning. Das Ergebnis? Das Modell konnte sowohl allmähliche Preisänderungen als auch die für Kryptowährungsmärkte typischen scharfen Sprünge erfassen.
Eine weitere Studie zeigte, dass ADE-TFT (Advanced Deep Learning-Enhanced Temporal Fusion Transformer) mit Diffusionskomponenten klassische Ansätze bei den Metriken MAPE, MSE und RMSE deutlich übertrifft. Besonders beeindruckend sind die Ergebnisse bei der Konfiguration mit 8 versteckten Schichten.
 Probabilistische Prognose: Verwendung von Diffusionsmodellen zur Generierung zukünftiger Preispfade mit zugehörigen Konfidenzintervallen
Die Schattenseite von Diffusionsmodellen im Finanzbereich
Aber seien wir ehrlich. Diffusionsmodelle sind kein Allheilmittel. Sie haben ernsthafte Probleme:
1. Rechenhunger
Das Training eines Diffusionsmodells auf Kryptowährungsdaten erfordert erhebliche Rechenressourcen. Wenn Ihr Modell 1000 Diffusionsschritte durchführt, benötigen Sie für eine einzige Prognose 1000 Durchläufe durch das neuronale Netz. Das eignet sich nicht besonders für Hochfrequenzhandel.
2. Das Problem der Schwarzen Schwäne
Kryptowährungsmärkte sind bekannt für extreme Ereignisse — ein 50-prozentiger Absturz an einem Tag, ein Kryptowährungsverbot in China, der Hack einer großen Börse. Diffusionsmodelle, die auf historischen Daten trainiert wurden, sagen solche Ereignisse nur schlecht voraus.
3. Regimeabhängigkeit
Kryptowährungsmärkte weisen verschiedene Verhaltensregime auf — Bullenmarkt, Bärenmarkt, Seitwärtsbewegung. Ein Diffusionsmodell kann in einem Regime hervorragend funktionieren und in einem anderen völlig versagen.
Optimierung und Beschleunigung: Wie man auf der GPU nicht bankrottgeht
Token Merging für Diffusion
GitHub: dbolya/tomesd
Die Token-Merging-Bibliothek ermöglicht es, Diffusionsmodelle um das 1,24-Fache zu beschleunigen, ohne Qualitätseinbußen, indem redundante Tokens zusammengeführt werden:
import tomesd
from diffusion_model import CryptoDiffusion

model = CryptoDiffusion(...)

# Apply Token Merging
tomesd.apply_patch(model, ratio=0.7)  # remove 30% of tokens

# Training and inference accelerate without accuracy loss
forecast = model.predict(btc_data)
Cached Adaptive Token Merging
GitHub: omidiu/ca_tome
CA-ToMe kombiniert räumliche und zeitliche Optimierung, was für Zeitreihen besonders wichtig ist:
from ca_tome import apply_ca_tome

# Apply cached token merging
apply_ca_tome(
    model,
    threshold=0.7,
    caching_steps=[0, 10, 20, 30, 40]  # cache every 10 steps
)
Praktisches Beispiel: Vollständige Pipeline für Bitcoin
Hier ist ein realistisches Beispiel für die Verwendung von Diffusionsmodellen zur Bitcoin-Prognose:
import torch
import pandas as pd
import numpy as np
from sklearn.preprocessing import MinMaxScaler
from diffusion_ts import DiffusionTS

class CryptoDiffusionPipeline:
    def __init__(self, sequence_length=100, forecast_horizon=24):
        self.sequence_length = sequence_length
        self.forecast_horizon = forecast_horizon
        self.scaler = MinMaxScaler()
        self.model = None

    def prepare_data(self, crypto_data):
        """Data preparation considering cryptocurrency features"""
        # Calculate technical indicators
        crypto_data['returns'] = crypto_data['close'].pct_change()
        crypto_data['volatility'] = crypto_data['returns'].rolling(24).std()
        crypto_data['rsi'] = self.compute_rsi(crypto_data['close'])

        # Normalization
        features = ['close', 'volume', 'volatility', 'rsi']
        scaled_data = self.scaler.fit_transform(crypto_data[features])

        return scaled_data

    def train_model(self, data):
        """Training diffusion model"""
        self.model = DiffusionTS(
            input_dim=data.shape[1],
            hidden_dim=128,
            num_layers=6,
            diffusion_steps=1000,
            noise_schedule='cosine',
            loss_type='l2'
        )

        # Create sequences for training
        X, y = self.create_sequences(data)

        self.model.fit(
            X, y,
            epochs=200,
            batch_size=32,
            learning_rate=1e-4,
            validation_split=0.2
        )

    def forecast(self, recent_data):
        """Forecasting with confidence intervals"""
        # Generate several samples for uncertainty estimation
        predictions = []

        for _ in range(100):  # Monte Carlo sampling
            pred = self.model.sample_forecast(
                context=recent_data[-self.sequence_length:],
                horizon=self.forecast_horizon
            )
            predictions.append(pred)

        predictions = np.array(predictions)

        # Calculate statistics
        mean_pred = np.mean(predictions, axis=0)
        std_pred = np.std(predictions, axis=0)

        return {
            'forecast': mean_pred,
            'confidence_95': mean_pred + 1.96 * std_pred,
            'confidence_5': mean_pred - 1.96 * std_pred
        }

# Usage
pipeline = CryptoDiffusionPipeline()
btc_data = pd.read_csv('btc_hourly.csv')

# Preparation and training
prepared_data = pipeline.prepare_data(btc_data)
pipeline.train_model(prepared_data)

# Forecasting
forecast_result = pipeline.forecast(prepared_data)
print(f"Bitcoin forecast for next 24h: {forecast_result['forecast'][-1]:.2f}")
Wann sollten Sie Diffusionsmodelle einsetzen?
Lohnt sich, wenn:
- Sie über umfangreiche historische Daten verfügen (mindestens ein Jahr stündlicher Daten)
- Sie sich langes Training leisten können (Tage bis Wochen auf der GPU)
- Sie synthetische Szenariogenerierung für Backtesting benötigen
- Sie mit multivariaten Zeitreihen arbeiten
- Die Unsicherheitsschätzung von Prognosen wichtig ist
Lohnt sich nicht, wenn:
- Sie schnelle Prognosen in Echtzeit benötigen
- Sie mit kurzen Zeitreihen arbeiten
- Ihre Rechenressourcen begrenzt sind
- Die Interpretierbarkeit des Modells entscheidend ist
Die Zukunft der Diffusionsmodelle in der Krypto-Analytik
Diffusionsmodelle im Finanzwesen sind wie Kryptowährungen im Jahr 2010. Die Technologie ist noch roh und ressourcenintensiv, aber das Potenzial ist enorm. Wir sehen bereits hybride Ansätze: DDPM + Transformer, Diffusion + Reinforcement Learning, bedingte Diffusion für Marktregime.
Der nächste Durchbruch wird bei der multimodalen Diffusion erwartet — Modelle, die nicht nur Preise, sondern auch Nachrichten, soziale Signale und On-Chain-Metriken berücksichtigen. Stellen Sie sich ein Diffusionsmodell vor, das die Korrelation zwischen einem Tweet von Elon Musk und der Bewegung von Dogecoin "sieht".
Fazit: Diffusion als Evolution, nicht als Revolution
Diffusionsmodelle werden klassische Ansätze zur Kryptowährungsprognose nicht ersetzen. Sie werden sie ergänzen. LSTM bleibt für schnelle Prognosen zuständig, ARIMA für stationäre Abschnitte, und Diffusion übernimmt die Szenariogenerierung sowie die Arbeit mit extremer Volatilität.
Die wichtigste Lehre: In der Welt der Kryptowährungen gibt es keine Allheilmittel. Es gibt nur eine kluge Kombination von Werkzeugen, tiefes Marktverständnis und gesunde Skepsis gegenüber jeder "revolutionären" Lösung. Diffusionsmodelle sind ein mächtiges Werkzeug, aber denken Sie daran: Sie versuchen lediglich, Muster im Chaos zu finden. Und das Chaos, wie wir wissen, lässt sich nicht gerne vorhersagen.
P.S.: Wenn Ihr Diffusionsmodell bei der Bitcoin-Prognose eine Genauigkeit von 95 % anzeigt — überprüfen Sie den Code zweimal. Höchstwahrscheinlich gibt es irgendwo ein Data Leakage 😉