Backtesting Without Fooling Yourself
A step-by-step path from what your backtest really optimizes to proving an edge survives overfitting, multiple testing, and live execution. Read top to bottom - each part builds on the last.
Objective-Function Design: de metriek die je optimaliseert kiest stiekem je strategie
Om naar de 'beste' strategie te zoeken, moet je eerst 'beste' definiëren - en die scalair kiest in stilte de winnaar. Op synthetische data met een bekende edge (600 seeds, T=2000, 80 drempels) kroont een naïeve per-trade Sharpe een loterij: hij kiest in 56% van de seeds een winnaar met minder dan 5% exposure en degenereert in 57% - bij de meest extreme seed leveren 8 trades een in-sample Sharpe van 21.09 op die out of sample instort tot 0.13. De eerlijke reparatie is bijna saai: meten over de volledige tijdlijn, die nooit degenereert (out-of-sample 1.71). Een trade-count (conf_k) shrinkage en een exposure floor kunnen een per-trade metriek repareren, maar zelfs volledig gerepareerd evenaren ze slechts de full-timeline Sharpe (1.70 tegen 1.71) - nooit meer dan dat. De wet van Goodhart, in een backtest, met gecontroleerde grondwaarheid.

Bewijzen dat multi-timeframe backtests geen look-ahead vertonen: verstoor de toekomst, bewijs dat het verleden de toekomst niet kan zien
Multi-timeframe backtests lekken de toekomst door een nog vormende higher-timeframe bar waarvan de uiteindelijke close nog niet bestaat. Je kunt niet via code review naar vertrouwen toe redeneren - je moet het testen. We reproduceren de closed-bar regel van de live bot exact, en bewijzen vervolgens de afwezigheid van lekkage met een shifted-future probe: verstoor elke toekomstige bar en toon aan dat elk signaal en elke trade uit het verleden bitwise ongewijzigd blijft. 25/25 parity checks, en de probe heeft tanden.

Look-Ahead Bias: hoe een fout van één bar een Sharpe van 15 fabriceert uit pure ruis
Een gecontroleerde studie van de subtiele look-ahead-lekken die backtests stilletjes opblazen. Zonder enige echte edge fabriceert een fill op dezelfde bar een geannualiseerde Sharpe van +14,8 uit pure ruis; een vooruitblik van één bar door een indicator, +4,8. De taxonomie, de gemeten grootteordes, en hoe je elk lek opspoort voordat het je geld kost.
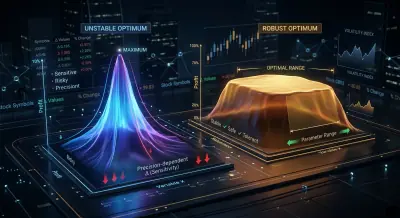
Plateau-analyse: hoe onderscheid je een robuust optimum van overfitting
Waarom het vinden van de beste strategieparameters slechts het halve werk is. Hoe je visueel en kwantitatief een stabiel plateau van een fragiele piek onderscheidt, en waarom Optuna contourplots een verplichte stap zijn voordat je een geoptimaliseerde strategie in productie lanceert.
Multi-symbol validatie: test je strategie op alle paren
Waarom een op ETHUSDT geoptimaliseerde strategie kan falen bij altcoins. Hoe je correct test over pairgroepen (blue chips, large caps, shitcoins) en welke cross-symbol robuustheidsscore als voldoende wordt beschouwd.

Monte Carlo Bootstrap: hoe je in 10 regels code betrouwbaarheidsintervallen voor een backtest krijgt
Waarom een puntschatting uit een backtest een gevaarlijke illusie is. Hoe Monte Carlo bootstrap in 2 seconden rekentijd een 95%-betrouwbaarheidsinterval voor PnL en MaxDD oplevert, en waarom dit een verplichte stap is voordat je een strategie in productie neemt.

Kans op backtest-overfitting (PBO)
Перевод статьи на nl

De Deflated Sharpe Ratio: Hoeveel van je Backtest-'Winnaars' Overleven Multiple Testing?
Een parameterzoektocht is een machine voor het fabriceren van geluk. Op pure ruis - 1.000 strategieën met nul echte edge - behaalt de beste jaarlijkse Sharpe gemiddeld 1,63 en signaleert de naïeve significantietoets 100% van de tijd een ontdekking. We bouwen een gecontroleerde ground truth en laten zien dat de Deflated Sharpe Ratio, de Harvey-Liu haircut en White's Reality Check de eerlijkheid herstellen: valse ontdekkingen dalen van 1,000 naar 0,001-0,057, echte edges boven het ruisplafond blijven behouden met een power van ~1 - en één echte valkuil (gecorreleerde grids) waar de rauwe DSR overdeflateert en het oordeel over een hele band van effectieve-trials-schattingen gelezen moet worden, niet over één getal.

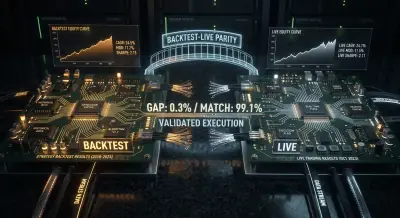
Backtest-live pariteit: waarom je bot anders handelt dan in de backtest
Volledige taxonomie van afwijkingen tussen backtesting en live trading: van slippage en gedeeltelijke fills tot desynchronisatie van de codebase. Architectuurpatronen voor het bereiken van pariteit, Python-voorbeelden van een gedeelde core-module en een checklist voor monitoring in productie.
Het Eerlijke Negatieve Resultaat: Tienduizenden Backtests, Vijf Grote Munten, Geen Robuuste Edge
Het sluitstuk van de zoek-en-overfit-boog, en het eindigt in een negatief resultaat - het juiste. Een single-symbol dual-timeframe-zoektocht op ETHUSDT vond een configuratie ter waarde van +16.35% out-of-sample en +2.62% op een ongebruikte holdout; de Deflated Sharpe Ratio, rekening houdend met ~37,000 trials, deflateerde dit tot 0.00. Een cross-instrument-doorloop over vijf grote munten (ETH/BTC/SOL/BNB/XRP, elk ~1.18M 1m-bars), selecterend op mediaan out-of-sample, maakt er definitief korte metten mee: dual DSR 0.24 / PBO 0.264, triple DSR 0.14 / PBO 0.327 - beide falen op de gates. De kampioen is winstgevend op 1 van de 5 symbolen en negatief op de rest. Hier is het anti-overfitting-apparaat voor bedoeld: om te voorkomen dat je de beste van de ruis als alpha shipt.

Cascadestrategieën: prioriteitsuitvoering met fallback-opvulling
Finale van de reeks 'Backtests zonder illusies'. Hoe bouw je een orchestrator uit N strategieën x M paren, implementeer je cascademodus met prioriteit en fallback-uitvoering, kies je dual_size, en waarom strategieportfolio's niet kunnen worden teruggetest door simpelweg de PnL op te tellen.
