Monte Carlo Bootstrap: hoe je in 10 regels code betrouwbaarheidsintervallen voor een backtest krijgt
Waarom een puntschatting uit een backtest een gevaarlijke illusie is. Hoe Monte Carlo bootstrap in 2 seconden rekentijd een 95%-betrouwbaarheidsinterval voor PnL en MaxDD oplevert, en waarom dit een verplichte stap is voordat je een strategie in productie neemt.
📄 Dit artikel is uitgegroeid tot een onderzoekspaper. De hier beschreven bootstrap-betrouwbaarheidsintervallen worden onderworpen aan een gecontroleerde coverage-test onder seriële afhankelijkheid (iid vs. trade-level vs. block bootstrap, 6.000 experimenten met exact bekende waarheid). Lees het paper online (interactieve versie + PDF) op bootstrap.marketmaker.cc, code en data op github.com/suenot/bootstrap-coverage.
Je hebt een strategie door een backtest gehaald. Je kreeg PnL +42%, Sharpe 1,8, MaxDD -12%. De resultaten zien er geweldig uit. Je lanceert de bot in productie, en een maand later ontdek je dat de drawdown al -28% is en de PnL richting nul beweegt.
Wat ging er mis? Het is geen bug en geen "veranderde markt". Het probleem is dat je een beslissing hebt genomen op basis van één enkel getal — een puntschatting. Je hebt geleerd dat de strategie +42% liet zien, maar niet hoeveel vertrouwen je in dat getal kunt hebben.
Het probleem met puntschattingen
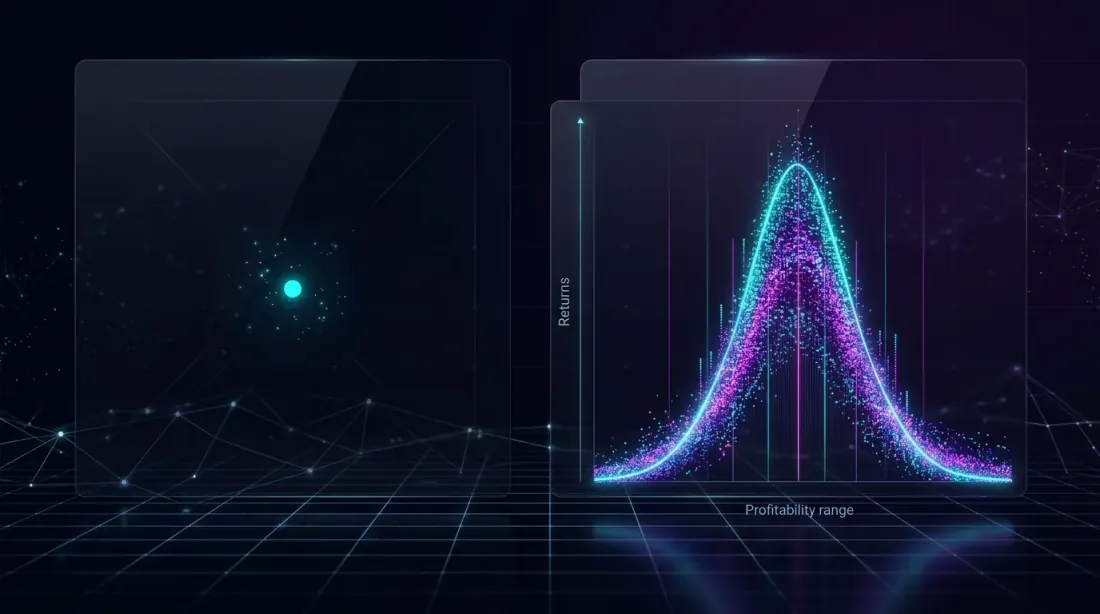 Eén enkel datapunt (links) geeft een misleidend beeld, terwijl de volledige verdeling (rechts) de werkelijke reikwijdte van mogelijke uitkomsten onthult.
Een backtest op historische data is één run door één specifieke reeks marktgebeurtenissen. Het resultaat hangt af van de volgorde van de trades: dezelfde strategie met dezelfde trades, maar in een andere volgorde, kan een geheel andere maximale drawdown laten zien.
Stel je 491 trades voor. Elke trade is een willekeurige gebeurtenis met een bepaalde rendementsverdeling. De historische backtest toont slechts één realisatie van dit proces. Het is alsof je één keer met een dobbelsteen gooit en concludeert dat de dobbelsteen altijd op vier landt.
Wat we eigenlijk nodig hebben:
- Geen puntschatting, maar een interval: "met 95% waarschijnlijkheid zal de uiteindelijke PnL tussen X en Y liggen"
- Geen enkele maximale drawdown, maar een verdeling: "in de 5% slechtste scenario's overschrijdt de drawdown Z%"
- Niet het gemiddelde, maar de staarten: wat gebeurt er als het geluk niet aan jouw kant staat?
Precies hiervoor dient Monte Carlo bootstrap.
Wat is Monte Carlo bootstrap
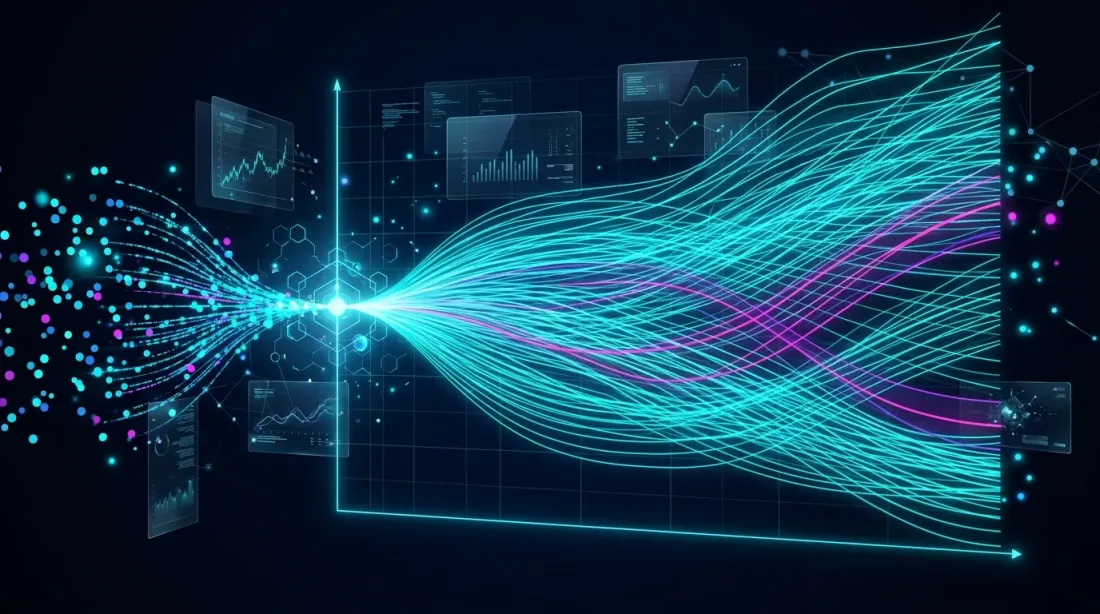 Bootstrap genereert duizenden alternatieve equity-trajecten door trades met teruglegging opnieuw te samplen uit de oorspronkelijke dataset.
Bootstrap is een resamplingmethode voorgesteld door Bradley Efron in 1979. Het idee is elegant: als we een datasteekproef hebben, kunnen we duizenden "nieuwe" steekproeven genereren door willekeurig elementen uit het origineel te selecteren met teruglegging.
In de context van een backtest werkt het zo:
- Je hebt een array van rendementen per trade — bijvoorbeeld 491 waarden
- Je selecteert willekeurig 491 waarden uit deze array met teruglegging — sommige trades komen twee keer voor, sommige helemaal niet
- Je bouwt een equity-curve op basis van deze nieuwe steekproef
- Je herhaalt dit 10.000 keer
- Je krijgt een verdeling van eindmetrieken, geen enkel getal
Elke iteratie is een "alternatief scenario": wat er had kunnen gebeuren als de volgorde en samenstelling van de trades iets anders waren geweest.
Implementatie in 10 regels
Hier is een volledig werkende implementatie:
import numpy as np

def max_drawdown(equity_curve):
    """Calculate the maximum drawdown of an equity curve."""
    peak = np.maximum.accumulate(equity_curve)
    drawdown = (equity_curve - peak) / peak
    return drawdown.min()

# Array of returns for each trade
trade_returns = [...]  # 491 values, e.g. [0.012, -0.005, 0.008, ...]

n_simulations = 10000
results = []

for _ in range(n_simulations):
    # Random sample with replacement
    sampled = np.random.choice(trade_returns, size=len(trade_returns), replace=True)
    # Build equity curve
    equity = np.cumprod(1 + sampled)
    results.append({
        "final_pnl": equity[-1] - 1,
        "max_dd": max_drawdown(equity),
        "sharpe": np.mean(sampled) / np.std(sampled) * np.sqrt(252)
    })
Uitvoeringstijd: ~2 seconden op een gewone laptop. 10.000 alternatieve geschiedenissen van je strategie.
Betrouwbaarheidsintervallen extraheren
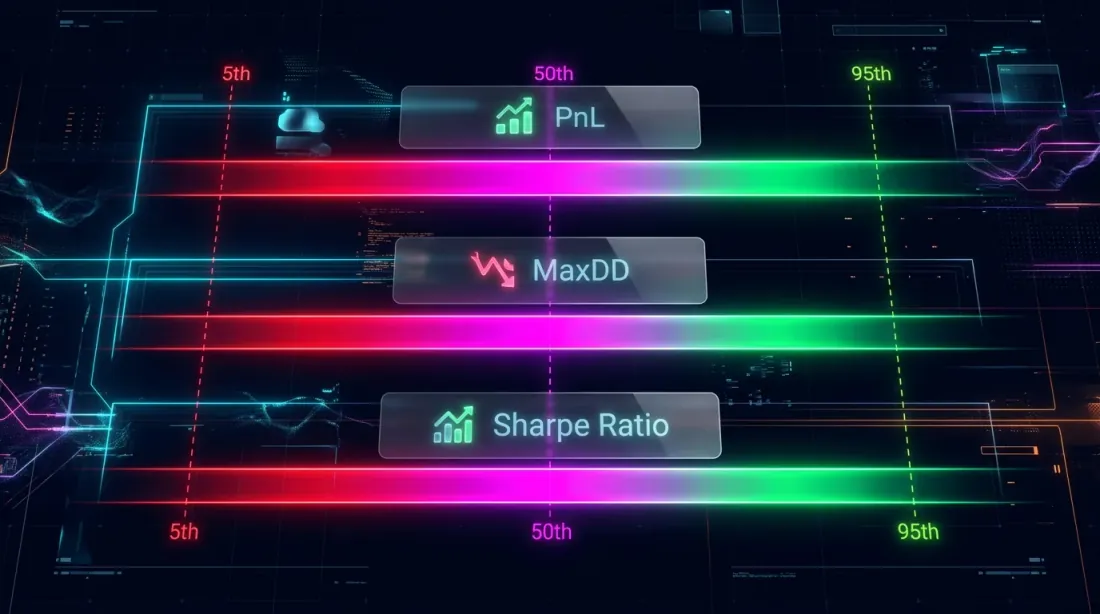 Betrouwbaarheidsintervallen voor de belangrijkste strategiemetrieken: PnL, MaxDD en Sharpe Ratio, met de 5e, 50e en 95e percentielbanden.
Nu hebben we niet één getal, maar een verdeling. Zo haal je er nuttige informatie uit:
import pandas as pd

df = pd.DataFrame(results)

# 95% confidence interval for PnL
pnl_5 = np.percentile(df['final_pnl'], 5)
pnl_50 = np.percentile(df['final_pnl'], 50)
pnl_95 = np.percentile(df['final_pnl'], 95)

# 95% confidence interval for MaxDD
dd_5 = np.percentile(df['max_dd'], 5)    # 5th — worst case
dd_50 = np.percentile(df['max_dd'], 50)
dd_95 = np.percentile(df['max_dd'], 95)  # 95th — best case

print(f"PnL:   {pnl_5:.1%} | {pnl_50:.1%} | {pnl_95:.1%}")
print(f"MaxDD: {dd_5:.1%} | {dd_50:.1%} | {dd_95:.1%}")
print(f"Sharpe: {np.percentile(df['sharpe'], 5):.2f} — {np.percentile(df['sharpe'], 95):.2f}")
Voorbeelduitvoer voor een echte strategie:
| Metric | 5th percentile (worst) | Median | 95th percentile (best) |
|---|---|---|---|
| PnL | +18.3% | +41.7% | +72.1% |
| MaxDD | -23.4% | -12.8% | -5.1% |
| Sharpe | 1.12 | 1.76 | 2.41 |
Nu is het verschil duidelijk:
- De backtest liet PnL +42% zien — maar in de 5% slechtste scenario's is de PnL slechts +18,3%
- De backtest liet MaxDD -12% zien — maar in de 5% slechtste scenario's is de drawdown -23,4%
- Sharpe 1,8 — maar de ondergrens is 1,12
Het 5e percentiel is je "realistische worstcasescenario". Als de strategie bij het 5e percentiel niet meer winstgevend is, is het risicovol om deze in productie te lanceren.
Visualisatie: Fan Chart
Monte Carlo bootstrap wordt van nature gevisualiseerd als een fan chart — een waaier van equity-curves:
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 2, figsize=(16, 6))

# Fan chart: all equity curves
ax = axes[0]
for i in range(min(500, n_simulations)):
    sampled = np.random.choice(trade_returns, size=len(trade_returns), replace=True)
    equity = np.cumprod(1 + sampled)
    ax.plot(equity, alpha=0.02, color='#4FC3F7')

# Add percentiles
all_equities = []
for _ in range(n_simulations):
    sampled = np.random.choice(trade_returns, size=len(trade_returns), replace=True)
    equity = np.cumprod(1 + sampled)
    all_equities.append(equity)

all_equities = np.array(all_equities)
p5 = np.percentile(all_equities, 5, axis=0)
p50 = np.percentile(all_equities, 50, axis=0)
p95 = np.percentile(all_equities, 95, axis=0)

ax.fill_between(range(len(p5)), p5, p95, alpha=0.3, color='#7C4DFF', label='90% CI')
ax.plot(p50, color='#E040FB', linewidth=2, label='Median')
ax.set_title('Monte Carlo Bootstrap: Equity Curves')
ax.legend()

# Histogram of final PnL
ax = axes[1]
ax.hist(df['final_pnl'] * 100, bins=80, color='#4FC3F7', alpha=0.7, edgecolor='#1A237E')
ax.axvline(pnl_5 * 100, color='#FF5252', linestyle='--', label=f'5th: {pnl_5:.1%}')
ax.axvline(pnl_50 * 100, color='#E040FB', linestyle='--', label=f'Median: {pnl_50:.1%}')
ax.axvline(pnl_95 * 100, color='#69F0AE', linestyle='--', label=f'95th: {pnl_95:.1%}')
ax.set_title('Distribution of Final PnL')
ax.set_xlabel('PnL, %')
ax.legend()

plt.tight_layout()
plt.savefig('monte_carlo_fan_chart.png', dpi=150)
plt.show()
Een fan chart geeft een intuïtief inzicht in de spreiding van mogelijke uitkomsten. Een smalle waaier betekent dat de strategie stabiel is. Een brede waaier betekent dat het resultaat sterk afhangt van "geluk" met de volgorde van trades.
 De fan chart (links) toont de spreiding van mogelijke equity-trajecten, en het histogram (rechts) toont de dichtheidsverdeling van de eindrendementen met gemarkeerde betrouwbaarheidsintervallen (5%, 50%, 95%).
Geavanceerde analyse: kans op ruïne
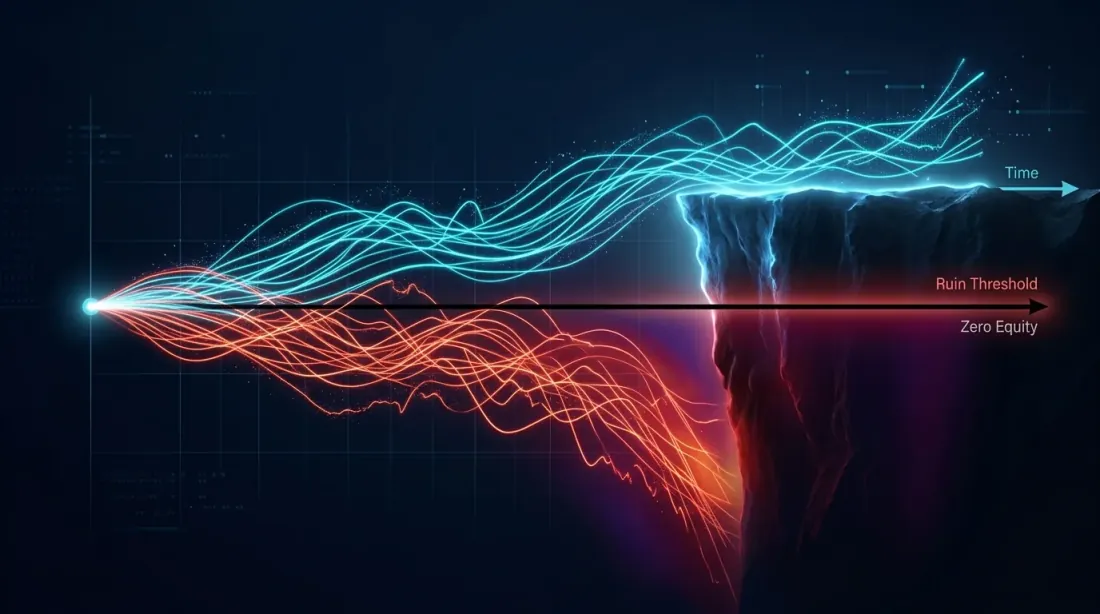 Visualisatie van de kans op ruïne: overlevende equity-paden (cyaan) buigen omhoog, terwijl geruïneerde paden (rood) onder de nul-equitygrens vallen.
Bootstrap stelt je in staat een cruciale vraag te beantwoorden: wat is de kans dat de strategie X% van het kapitaal verliest?
# Probability of ruin: probability of drawdown exceeding 20%
ruin_threshold = -0.20
prob_ruin = (df['max_dd'] < ruin_threshold).mean()
print(f"P(MaxDD < -20%) = {prob_ruin:.1%}")

# Probability of negative PnL
prob_loss = (df['final_pnl'] < 0).mean()
print(f"P(PnL < 0) = {prob_loss:.1%}")

# Expected shortfall (CVaR): average loss in the 5% worst cases
worst_5pct = df['final_pnl'].quantile(0.05)
cvar = df[df['final_pnl'] <= worst_5pct]['final_pnl'].mean()
print(f"CVaR(5%) = {cvar:.1%}")
Deze metrieken zijn onmogelijk te verkrijgen uit één enkele backtestrun. Toch zijn ze cruciaal voor de beslissing om een strategie te lanceren.
Voor meer over waarom diepe drawdowns wiskundig gevaarlijk zijn en hoe rendementsasymmetrie werkt, lees ons artikel Loss-Profit Asymmetry.
Wanneer klassieke bootstrap niet werkt
De methode heeft beperkingen die belangrijk zijn om te kennen.
Autocorrelatie van rendementen
Klassieke bootstrap gaat ervan uit dat trades onafhankelijk zijn. In werkelijkheid is dit vaak niet het geval — een strategie kan winst- en verliesreeksen hebben. Als de autocorrelatie significant is, gebruik dan block bootstrap:
def block_bootstrap(returns, block_size=10, n_simulations=10000):
    """Bootstrap preserving local dependency structure."""
    n = len(returns)
    results = []

    for _ in range(n_simulations):
        # Select random starting points for blocks
        starts = np.random.randint(0, n - block_size + 1, size=n // block_size + 1)
        # Assemble blocks
        sampled = np.concatenate([returns[s:s+block_size] for s in starts])[:n]
        equity = np.cumprod(1 + sampled)
        results.append({
            "final_pnl": equity[-1] - 1,
            "max_dd": max_drawdown(equity),
        })

    return pd.DataFrame(results)
Block bootstrap behoudt lokale afhankelijkheden tussen opeenvolgende trades en levert zo realistischere betrouwbaarheidsintervallen voor de MaxDD op.
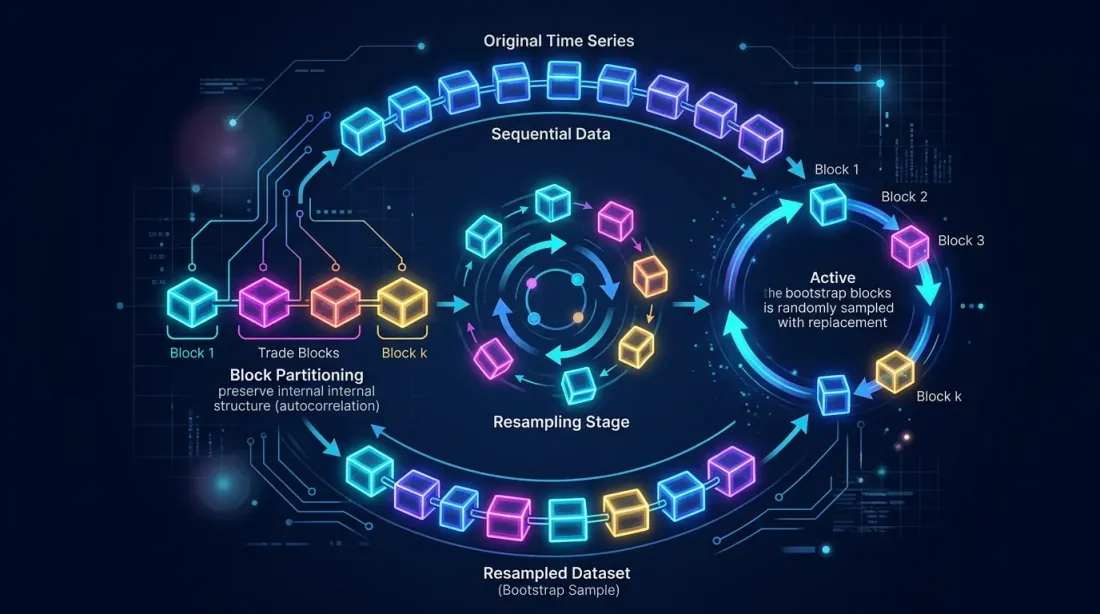 Block bootstrap behoudt de autocorrelatie binnen blokken door de trade-reeks in blokken te verdelen en deze met teruglegging opnieuw te samplen.
Niet-stationariteit van de markt
Bootstrap werkt met de oorspronkelijke trade-verdeling. Als de markt structureel is veranderd (bijvoorbeeld de volatiliteit is gedaald of de liquiditeit is veranderd), kunnen historische trades niet representatief zijn. Om hiermee rekening te houden:
- Gebruik een rolling window: doe bootstrap alleen op de laatste N trades
- Weeg recente trades zwaarder: weighted bootstrap
- Splits data op marktregimes en voer bootstrap apart uit
Klein aantal trades
Bootstrap is betrouwbaar bij n > 30 trades. Als je 10 trades hebt — geen hoeveelheid resampling zal helpen. 491 trades is een uitstekende steekproef; je kunt de resultaten vertrouwen.
Vergelijking van benaderingen voor het beoordelen van backtest-robuustheid
| Method | What it provides | Complexity | Time | When to use |
|---|---|---|---|---|
| Single backtest | One point estimate | Minimal | Seconds | Never as a final result |
| Walk-forward | Out-of-sample metrics | Medium | Minutes | To check for overfitting |
| Monte Carlo bootstrap | Confidence intervals | Minimal | ~2 sec | Always before production |
| Monte Carlo path | New price paths | High | Minutes-hours | For stress testing |
| Cross-validation | Average metrics across folds | Medium | Minutes | For parameter tuning |
Monte Carlo bootstrap is de enige methode die in minimale tijd een compleet beeld van de risico's geeft.
Checklist: resultaten interpreteren
Zo raden we aan om de resultaten van Monte Carlo bootstrap te interpreteren:
Lanceer in productie als:
- de PnL bij het 5e percentiel positief is
- de MaxDD bij het 5e percentiel acceptabel is voor jouw risicobereidheid
- de kans op ruïne < 1% is
- de Sharpe bij het 5e percentiel > 0,5 is
Vereist verder werk als:
- de PnL bij het 5e percentiel dicht bij nul ligt
- de MaxDD bij het 5e percentiel significant slechter is dan bij het 50e
- de spreiding van de fan chart breed is — de strategie is instabiel
Niet lanceren als:
- de PnL bij het 5e percentiel negatief is
- de kans op ruïne > 5% is
- het betrouwbaarheidsinterval voor Sharpe 0 bevat
Onze ervaring bij marketmaker.cc
Bij marketmaker.cc ontwikkelen we onze eigen backtest-engine, en Monte Carlo bootstrap is een integraal onderdeel van onze pipeline. Elke strategie doorloopt automatisch bootstrap voordat deze wordt goedgekeurd voor live trading.
We hebben bootstrap rechtstreeks in de backtest-engine geïntegreerd: na een run krijg je niet alleen de eindwaarde van de PnL, maar een compleet rapport met betrouwbaarheidsintervallen, fan chart, kans op ruïne, en een vergelijking van block versus standaard bootstrap. Dit kost 2-3 seconden extra — een verwaarloosbare prijs voor het begrijpen van echte risico's.
Uit onze ervaring: ongeveer 30% van de strategieën die er op basis van de puntschatting aantrekkelijk uitzien, worden na Monte Carlo bootstrap uitgefilterd. Hun PnL bij het 5e percentiel wordt negatief of de MaxDD blijkt onaanvaardbaar. Zonder bootstrap zouden deze strategieën in productie zijn gegaan en zeer waarschijnlijk tot verliezen hebben geleid.
Conclusie
Monte Carlo bootstrap is ~10 regels code en ~2 seconden rekentijd. Het transformeert een enkel getal uit een backtest in een volledige verdeling met betrouwbaarheidsintervallen. Dit is misschien wel de hoogste ROI van elke kwantitatieve analysetool:
- Minimale kosten: implementatie in 30 minuten
- Maximale opbrengst: begrip van de echte strategierisico's
- Geen afhankelijkheden: alleen NumPy
Als je nog geen bootstrap gebruikt — voeg het vandaag nog toe aan je pipeline. Het is de enige manier om te weten hoeveel je de resultaten van je backtest kunt vertrouwen.
References
- Efron, B. — Bootstrap Methods: Another Look at the Jackknife (1979)
- Davison, A.C., Hinkley, D.V. — Bootstrap Methods and their Application (Cambridge)
- Aronson, D.R. — Evidence-Based Technical Analysis: Monte Carlo permutation
- QuantStart — Monte Carlo Simulation for Backtest Analysis
- Marcos Lopez de Prado — Advances in Financial Machine Learning, Chapter 12: Backtesting
- Kevin Davey — Building Winning Algorithmic Trading Systems: Monte Carlo Analysis
- NumPy — numpy.random.choice
Citation
@software{soloviov2026montecarlobootstrap,
  author = {Soloviov, Eugen},
  title = {Monte Carlo Bootstrap: How to Get Confidence Intervals for a Backtest in 10 Lines of Code},
  year = {2026},
  url = {https://marketmaker.cc/ru/blog/post/monte-carlo-bootstrap-backtest},
  version = {0.1.0},
  description = {Why a single-point estimate from a backtest is a dangerous illusion. How Monte Carlo bootstrap in 2 seconds of computation gives you a 95\% confidence interval for PnL and MaxDD, and why this is a mandatory step before launching a strategy in production.}
}


