Backtesting Without Fooling Yourself
A step-by-step path from what your backtest really optimizes to proving an edge survives overfitting, multiple testing, and live execution. Read top to bottom - each part builds on the last.
Design da função objetivo: a métrica que você otimiza escolhe secretamente sua estratégia
Para buscar a 'melhor' estratégia é preciso primeiro definir 'melhor' - e esse escalar escolhe o vencedor em silêncio. Em dados sintéticos com um edge conhecido (600 seeds, T=2000, 80 limiares), um Sharpe por trade ingênuo coroa uma loteria: escolhe um vencedor com menos de 5% de exposição em 56% das seeds e degenera em 57% - na seed mais extrema, 8 trades produzem um Sharpe in-sample de 21.09 que desaba para 0.13 fora da amostra. O conserto honesto é quase entediante: medir na linha do tempo completa, que nunca degenera (out-of-sample 1.71). Um shrinkage por número de trades (conf_k) e um piso de exposição podem remendar uma métrica por trade, mas mesmo totalmente corrigidos eles apenas igualam o Sharpe de linha do tempo completa (1.70 contra 1.71) - nunca o superam. A lei de Goodhart, num backtest, com verdade fundamental controlada.

Provando a Ausência de Look-Ahead em Backtests Multi-Timeframe: Perturbe o Futuro, Prove que o Passado Não Pode Vê-lo
Backtests multi-timeframe vazam o futuro através de uma barra de timeframe superior ainda em formação, cujo fechamento final ainda não existe. Não se chega à confiança por revisão de código - é preciso testar. Reproduzimos exatamente a regra de barra fechada do bot ao vivo e depois provamos a ausência de vazamento com uma sonda de futuro deslocado: perturbamos cada barra futura e verificamos que todo sinal e trade passado permanece bit a bit inalterado. 25/25 verificações de paridade, e a sonda tem dentes.

Look-Ahead Bias: como um erro de uma vela fabrica um Sharpe de 15 a partir de puro ruído
Um estudo controlado das sutis fugas de look-ahead que inflam silenciosamente os backtests. Sem nenhum edge real, uma execução na mesma vela fabrica um Sharpe anualizado de +14,8 a partir de puro ruído; uma espiada de um indicador uma vela à frente, +4,8. A taxonomia, as magnitudes medidas e como detectar cada fuga antes que ela lhe custe dinheiro.
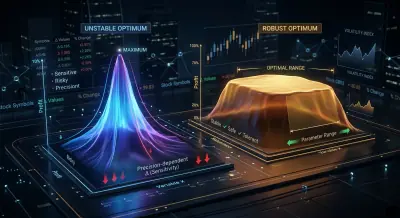
Análise de plateau: como distinguir um ótimo robusto de overfitting
Por que encontrar os melhores parâmetros de uma estratégia é apenas metade do trabalho. Como distinguir visual e quantitativamente um plateau estável de um pico frágil, e por que os gráficos de contorno do Optuna são uma etapa obrigatória antes de lançar uma estratégia otimizada em produção.
Validação multi-símbolo: teste sua estratégia em todos os pares
Por que uma estratégia otimizada em ETHUSDT pode falhar em altcoins. Como testar corretamente em grupos de pares (blue chips, large caps, shitcoins) e qual pontuação de robustez cross-symbol é considerada suficiente.

Monte Carlo Bootstrap: como obter intervalos de confiança para um backtest em 10 linhas de código
Por que uma estimativa pontual de um backtest é uma ilusão perigosa. Como o bootstrap Monte Carlo, em 2 segundos de computação, fornece um intervalo de confiança de 95% para o PnL e o MaxDD, e por que esse é um passo obrigatório antes de lançar uma estratégia em produção.

Probabilidade de sobreajuste do backtest (PBO)
Перевод статьи на pt

O Deflated Sharpe Ratio: Quantos dos seus 'vencedores' de backtest sobrevivem ao multiple testing?
Uma busca de parâmetros é uma máquina de fabricar sorte. Em ruído puro - 1.000 estratégias com zero de edge real - o melhor Sharpe anualizado tem média de 1,63 e o teste de significância ingênuo aponta uma descoberta em 100% das vezes. Construímos uma verdade fundamental controlada e mostramos que o Deflated Sharpe Ratio, o haircut de Harvey-Liu e o Reality Check de White restauram a honestidade: os falsos positivos caem de 1,000 para 0,001-0,057, edges genuínos acima do teto de ruído são mantidos com poder ~1 - e uma armadilha real (grids correlacionados) onde o DSR bruto deflaciona em excesso e o veredito precisa ser lido em toda uma faixa de estimativas de trials efetivos, não em um único número.

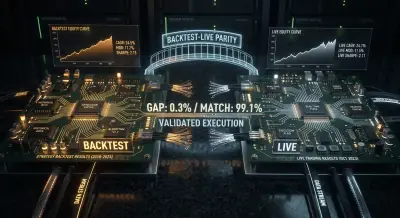
Paridade backtest-live: por que seu bot opera diferente do backtest
Taxonomia completa das divergências entre backtesting e trading ao vivo: de slippage e execuções parciais até a dessincronização da base de código. Padrões arquiteturais para alcançar paridade, exemplos em Python de um módulo core compartilhado e uma checklist de monitoramento em produção.
O Negativo Honesto: Dezenas de Milhares de Backtests, Cinco Majors, Nenhuma Vantagem Robusta
O ponto culminante do arco de busca-e-overfitting, e ele termina em um resultado negativo - o correto. Uma busca de timeframe duplo em um único símbolo no ETHUSDT encontrou uma configuração que valia +16,35% out-of-sample e +2,62% em um holdout intocado; o Deflated Sharpe Ratio, considerando ~37.000 tentativas, deflacionou-o para 0,00. Uma passagem cross-instrument sobre cinco majors (ETH/BTC/SOL/BNB/XRP, ~1,18M de barras de 1m cada), selecionando pela mediana out-of-sample, o mata de vez: DSR duplo 0,24 / PBO 0,264, DSR triplo 0,14 / PBO 0,327 - ambos falham nos limiares. O campeão é lucrativo em 1 de 5 símbolos e negativo no restante. É para isso que serve o aparato anti-overfitting: para impedir você de embarcar o melhor do ruído como alfa.

Estratégias em cascata: execução prioritária com preenchimento de reserva
Final da série 'Backtests sem ilusões'. Como construir um orquestrador a partir de N estratégias x M pares, implementar o modo cascata com prioridade e execução de reserva, escolher dual_size, e por que carteiras de estratégias não podem ser testadas retroativamente somando o PnL.
