Monte Carlo Bootstrap: cómo obtener intervalos de confianza para un backtest en 10 líneas de código
Por qué una estimación puntual de un backtest es una ilusión peligrosa. Cómo el bootstrap Monte Carlo, en 2 segundos de cómputo, te da un intervalo de confianza del 95% para el PnL y el MaxDD, y por qué es un paso obligatorio antes de lanzar una estrategia a producción.
📄 Este artículo dio origen a un paper de investigación. Los intervalos de confianza bootstrap descritos aquí se someten a una prueba controlada de cobertura bajo dependencia serial (iid vs. bootstrap a nivel de trade vs. block bootstrap, 6.000 experimentos con verdad exactamente conocida). Lee el paper online (versión interactiva + PDF) en bootstrap.marketmaker.cc, código y datos en github.com/suenot/bootstrap-coverage.
Ejecutaste una estrategia en un backtest. Obtuviste PnL +42%, Sharpe 1.8, MaxDD -12%. Los resultados se ven excelentes. Lanzas el bot a producción, y un mes después descubres que el drawdown ya está en -28% y el PnL se dirige hacia cero.
¿Qué salió mal? No es un bug ni "el mercado cambió". El problema es que tomaste una decisión basada en un solo número — una estimación puntual. Supiste que la estrategia mostró +42%, pero no supiste cuánto podías confiar en ese número.
El problema de las estimaciones puntuales
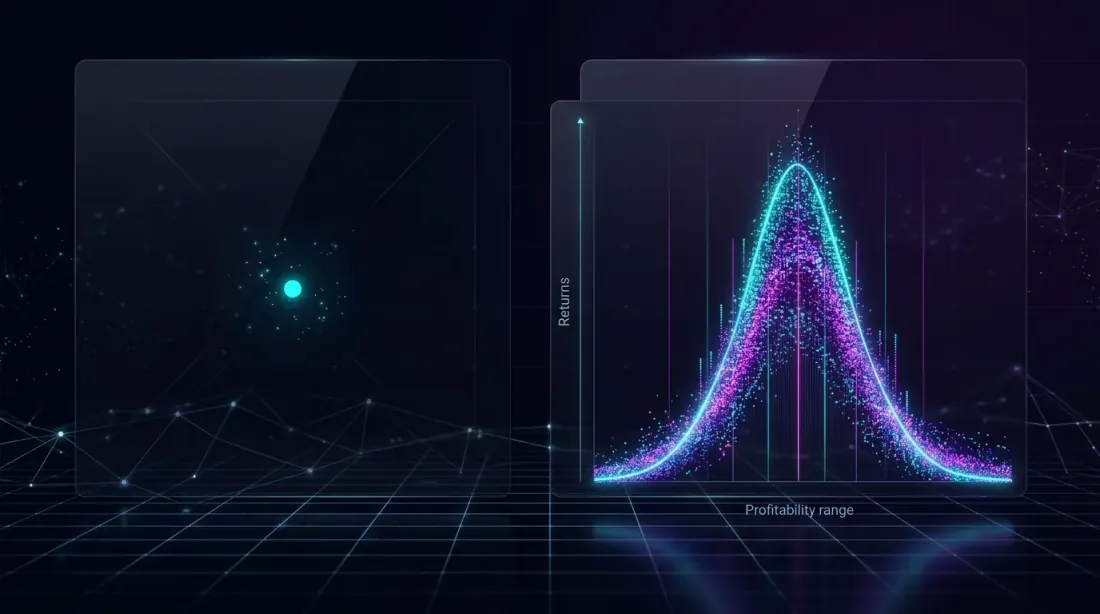 Un único punto de datos (izquierda) da una imagen engañosa, mientras que la distribución completa (derecha) revela el verdadero rango de resultados posibles.
Un backtest sobre datos históricos es una sola ejecución a través de una secuencia específica de eventos de mercado. El resultado depende del orden de los trades: la misma estrategia con los mismos trades, pero en un orden distinto, puede mostrar un drawdown máximo completamente diferente.
Imagina 491 trades. Cada trade es un evento aleatorio con una cierta distribución de retornos. El backtest histórico muestra solo una realización de este proceso. Es como lanzar un dado una vez y concluir que el dado siempre cae en cuatro.
Lo que realmente necesitamos:
- No una estimación puntual, sino un intervalo: "con 95% de probabilidad, el PnL final estará entre X e Y"
- No un único drawdown máximo, sino una distribución: "en el 5% de los peores escenarios, el drawdown supera Z%"
- No la media, sino las colas: ¿qué pasa si la suerte no está de tu lado?
Para esto exactamente sirve el bootstrap Monte Carlo.
Qué es el bootstrap Monte Carlo
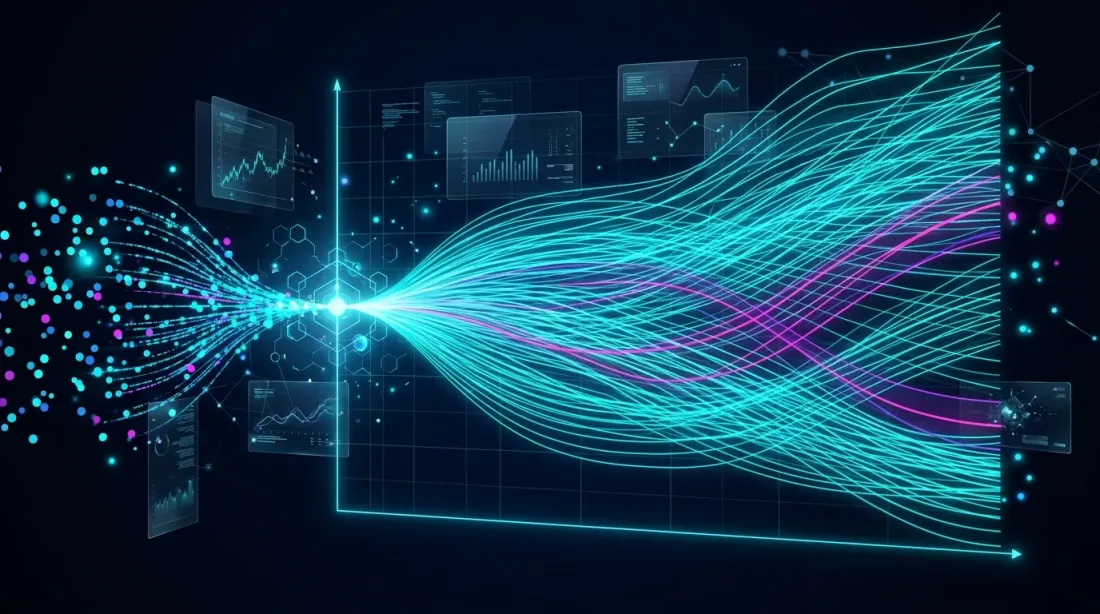 El bootstrap genera miles de trayectorias alternativas de equity mediante remuestreo de trades con reemplazo a partir del conjunto de datos original.
El bootstrap es un método de remuestreo propuesto por Bradley Efron en 1979. La idea es elegante: si tenemos una muestra de datos, podemos generar miles de "nuevas" muestras seleccionando aleatoriamente elementos de la original con reemplazo.
En el contexto de un backtest, funciona así:
- Tienes un array de retornos para cada trade — por ejemplo, 491 valores
- Seleccionas aleatoriamente 491 valores de ese array con reemplazo — algunos trades aparecerán dos veces, otros no aparecerán en absoluto
- Construyes una curva de equity a partir de esta nueva muestra
- Repites el proceso 10.000 veces
- Obtienes una distribución de métricas finales, no un solo número
Cada iteración es un "escenario alternativo": lo que podría haber pasado si el orden y el conjunto de trades hubieran sido ligeramente distintos.
Implementación en 10 líneas
Aquí tienes una implementación completa y funcional:
import numpy as np

def max_drawdown(equity_curve):
    """Calculate the maximum drawdown of an equity curve."""
    peak = np.maximum.accumulate(equity_curve)
    drawdown = (equity_curve - peak) / peak
    return drawdown.min()

# Array of returns for each trade
trade_returns = [...]  # 491 values, e.g. [0.012, -0.005, 0.008, ...]

n_simulations = 10000
results = []

for _ in range(n_simulations):
    # Random sample with replacement
    sampled = np.random.choice(trade_returns, size=len(trade_returns), replace=True)
    # Build equity curve
    equity = np.cumprod(1 + sampled)
    results.append({
        "final_pnl": equity[-1] - 1,
        "max_dd": max_drawdown(equity),
        "sharpe": np.mean(sampled) / np.std(sampled) * np.sqrt(252)
    })
Tiempo de ejecución: ~2 segundos en una laptop común. 10.000 historias alternativas de tu estrategia.
Extraer intervalos de confianza
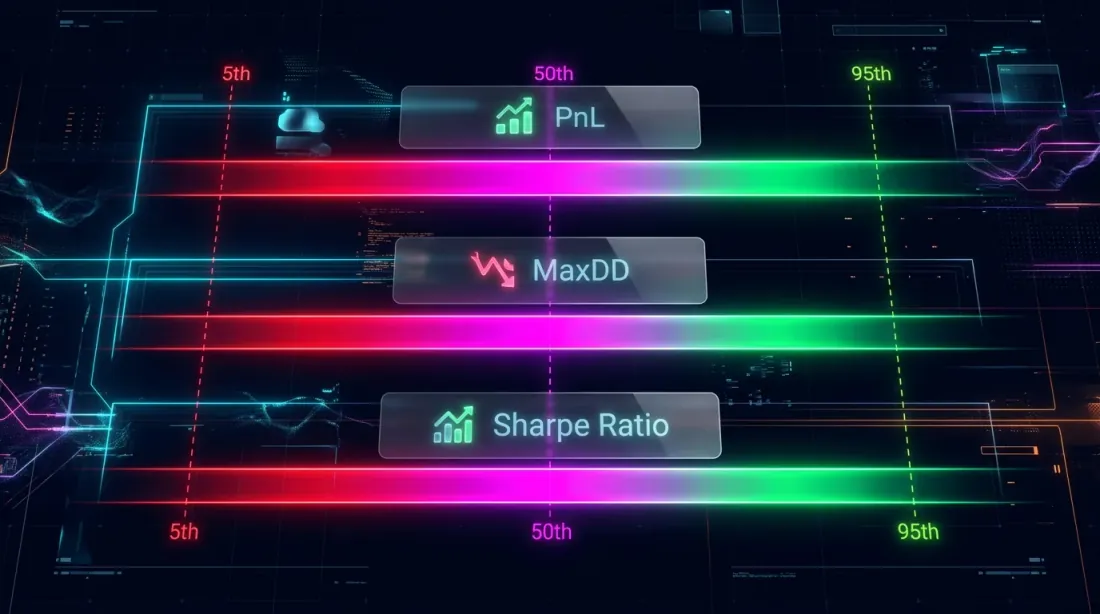 Intervalos de confianza para las métricas clave de la estrategia: PnL, MaxDD y Sharpe Ratio, mostrando las bandas de los percentiles 5, 50 y 95.
Ahora tenemos no un número, sino una distribución. Así se extrae información útil de ella:
import pandas as pd

df = pd.DataFrame(results)

# 95% confidence interval for PnL
pnl_5 = np.percentile(df['final_pnl'], 5)
pnl_50 = np.percentile(df['final_pnl'], 50)
pnl_95 = np.percentile(df['final_pnl'], 95)

# 95% confidence interval for MaxDD
dd_5 = np.percentile(df['max_dd'], 5)    # 5th — worst case
dd_50 = np.percentile(df['max_dd'], 50)
dd_95 = np.percentile(df['max_dd'], 95)  # 95th — best case

print(f"PnL:   {pnl_5:.1%} | {pnl_50:.1%} | {pnl_95:.1%}")
print(f"MaxDD: {dd_5:.1%} | {dd_50:.1%} | {dd_95:.1%}")
print(f"Sharpe: {np.percentile(df['sharpe'], 5):.2f} — {np.percentile(df['sharpe'], 95):.2f}")
Ejemplo de salida para una estrategia real:
| Metric | 5th percentile (worst) | Median | 95th percentile (best) |
|---|---|---|---|
| PnL | +18.3% | +41.7% | +72.1% |
| MaxDD | -23.4% | -12.8% | -5.1% |
| Sharpe | 1.12 | 1.76 | 2.41 |
Ahora la diferencia es evidente:
- El backtest mostró PnL +42% — pero en el 5% de los escenarios peores, el PnL es solo +18.3%
- El backtest mostró MaxDD -12% — pero en el 5% de los escenarios peores, el drawdown es -23.4%
- Sharpe 1.8 — pero el límite inferior es 1.12
El percentil 5 es tu "peor caso realista". Si la estrategia deja de ser rentable en el percentil 5, lanzarla a producción es arriesgado.
Visualización: Fan Chart
El bootstrap Monte Carlo se visualiza de forma natural como un fan chart — un abanico de curvas de equity:
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 2, figsize=(16, 6))

# Fan chart: all equity curves
ax = axes[0]
for i in range(min(500, n_simulations)):
    sampled = np.random.choice(trade_returns, size=len(trade_returns), replace=True)
    equity = np.cumprod(1 + sampled)
    ax.plot(equity, alpha=0.02, color='#4FC3F7')

# Add percentiles
all_equities = []
for _ in range(n_simulations):
    sampled = np.random.choice(trade_returns, size=len(trade_returns), replace=True)
    equity = np.cumprod(1 + sampled)
    all_equities.append(equity)

all_equities = np.array(all_equities)
p5 = np.percentile(all_equities, 5, axis=0)
p50 = np.percentile(all_equities, 50, axis=0)
p95 = np.percentile(all_equities, 95, axis=0)

ax.fill_between(range(len(p5)), p5, p95, alpha=0.3, color='#7C4DFF', label='90% CI')
ax.plot(p50, color='#E040FB', linewidth=2, label='Median')
ax.set_title('Monte Carlo Bootstrap: Equity Curves')
ax.legend()

# Histogram of final PnL
ax = axes[1]
ax.hist(df['final_pnl'] * 100, bins=80, color='#4FC3F7', alpha=0.7, edgecolor='#1A237E')
ax.axvline(pnl_5 * 100, color='#FF5252', linestyle='--', label=f'5th: {pnl_5:.1%}')
ax.axvline(pnl_50 * 100, color='#E040FB', linestyle='--', label=f'Median: {pnl_50:.1%}')
ax.axvline(pnl_95 * 100, color='#69F0AE', linestyle='--', label=f'95th: {pnl_95:.1%}')
ax.set_title('Distribution of Final PnL')
ax.set_xlabel('PnL, %')
ax.legend()

plt.tight_layout()
plt.savefig('monte_carlo_fan_chart.png', dpi=150)
plt.show()
Un fan chart ofrece una comprensión intuitiva de la dispersión de los resultados posibles. Un abanico estrecho significa que la estrategia es estable. Un abanico ancho significa que el resultado depende en gran medida de la "suerte" con el orden de los trades.
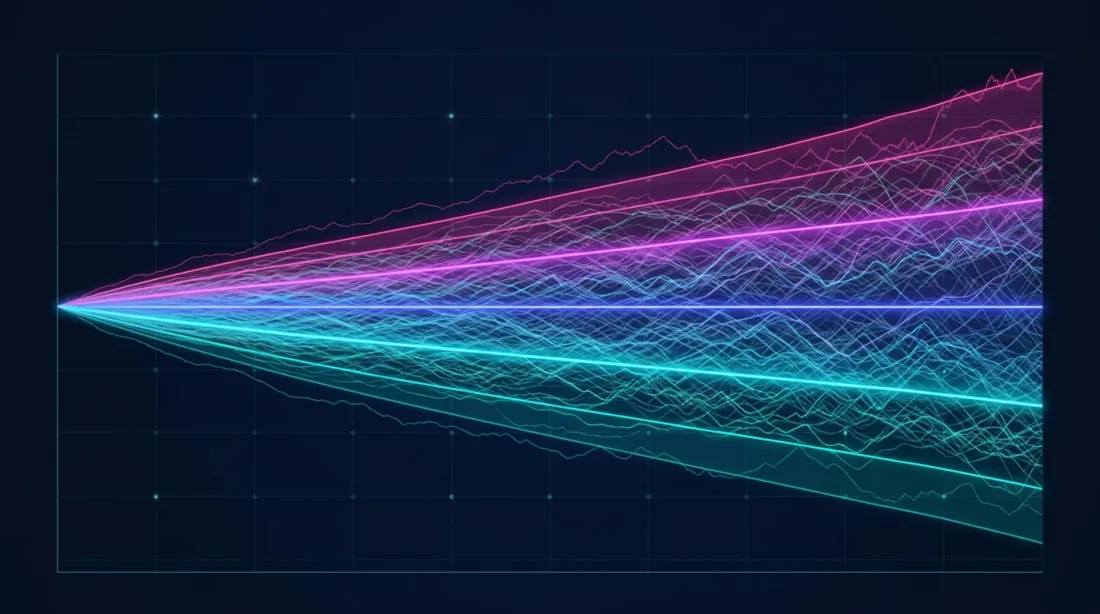 El fan chart (izquierda) muestra la dispersión de las posibles trayectorias de equity, y el histograma (derecha) muestra la distribución de densidad de los retornos finales con los intervalos de confianza resaltados (5%, 50%, 95%).
Análisis avanzado: probabilidad de ruina
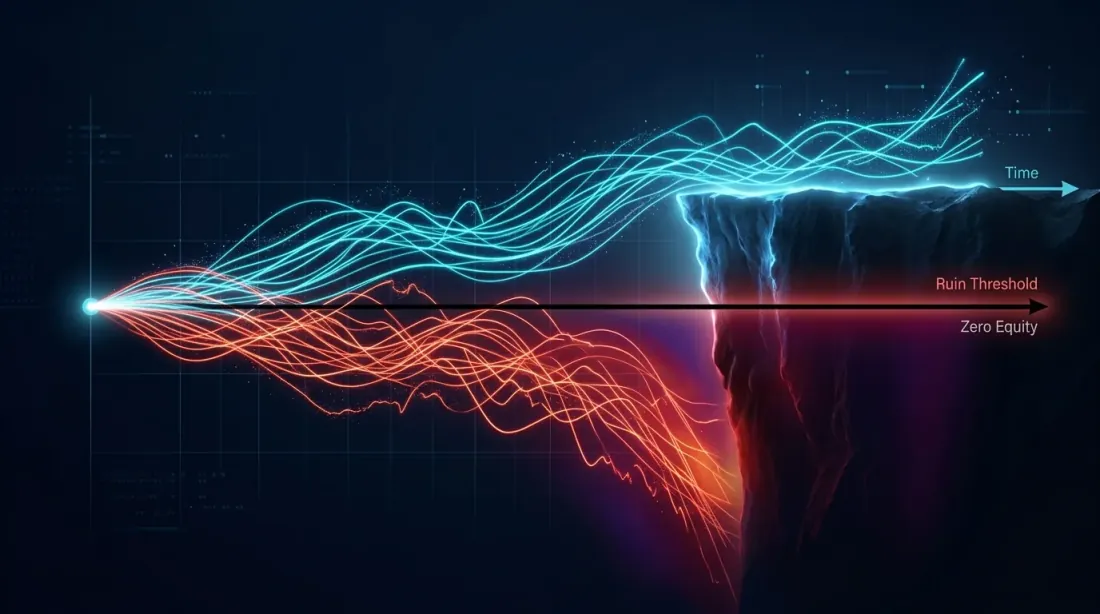 Visualización de la probabilidad de ruina: las trayectorias de equity que sobreviven (cian) se curvan hacia arriba, mientras que las trayectorias arruinadas (rojo) caen por debajo del borde de equity cero.
El bootstrap permite responder una pregunta crítica: ¿cuál es la probabilidad de que la estrategia pierda X% del capital?
# Probability of ruin: probability of drawdown exceeding 20%
ruin_threshold = -0.20
prob_ruin = (df['max_dd'] < ruin_threshold).mean()
print(f"P(MaxDD < -20%) = {prob_ruin:.1%}")

# Probability of negative PnL
prob_loss = (df['final_pnl'] < 0).mean()
print(f"P(PnL < 0) = {prob_loss:.1%}")

# Expected shortfall (CVaR): average loss in the 5% worst cases
worst_5pct = df['final_pnl'].quantile(0.05)
cvar = df[df['final_pnl'] <= worst_5pct]['final_pnl'].mean()
print(f"CVaR(5%) = {cvar:.1%}")
Estas métricas son imposibles de obtener a partir de una sola ejecución de backtest. Sin embargo, son fundamentales para decidir si lanzar una estrategia.
Para más información sobre por qué los drawdowns profundos son matemáticamente peligrosos y cómo funciona la asimetría de retornos, lee nuestro artículo Loss-Profit Asymmetry.
Cuándo el bootstrap clásico no funciona
El método tiene limitaciones importantes de conocer.
Autocorrelación de los retornos
El bootstrap clásico asume que los trades son independientes. En la realidad, esto a menudo no es así — una estrategia puede tener rachas de ganancias y de pérdidas. Si la autocorrelación es significativa, usa block bootstrap:
def block_bootstrap(returns, block_size=10, n_simulations=10000):
    """Bootstrap preserving local dependency structure."""
    n = len(returns)
    results = []

    for _ in range(n_simulations):
        # Select random starting points for blocks
        starts = np.random.randint(0, n - block_size + 1, size=n // block_size + 1)
        # Assemble blocks
        sampled = np.concatenate([returns[s:s+block_size] for s in starts])[:n]
        equity = np.cumprod(1 + sampled)
        results.append({
            "final_pnl": equity[-1] - 1,
            "max_dd": max_drawdown(equity),
        })

    return pd.DataFrame(results)
El block bootstrap preserva las dependencias locales entre trades consecutivos, proporcionando intervalos de confianza más realistas para el MaxDD.
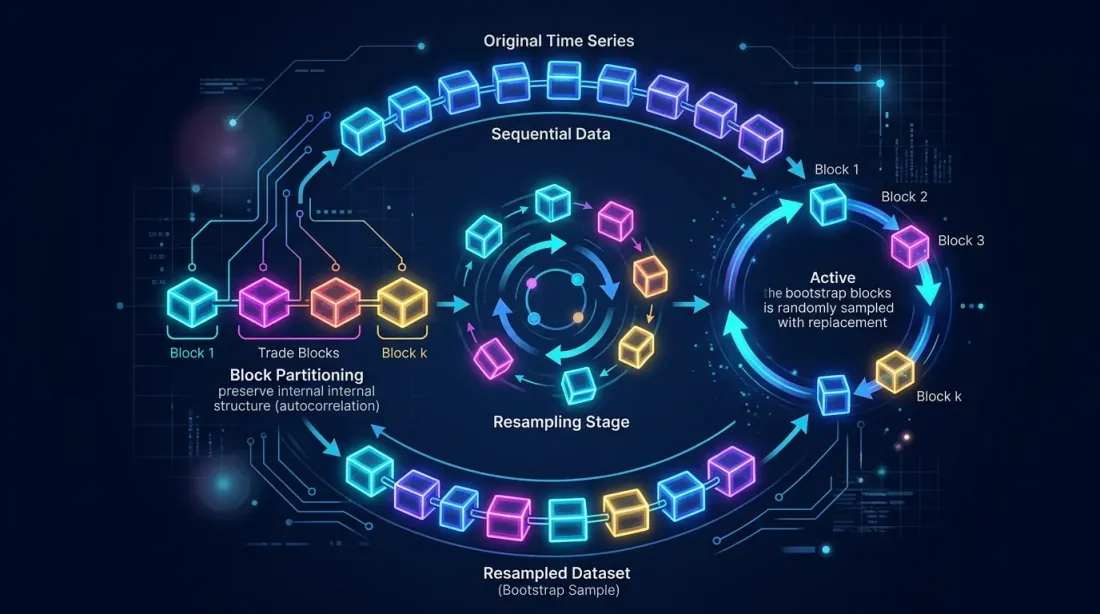 El block bootstrap preserva la autocorrelación dentro de los bloques al dividir la secuencia de trades en bloques y remuestrearlos con reemplazo.
No estacionariedad del mercado
El bootstrap trabaja con la distribución original de trades. Si el mercado ha cambiado estructuralmente (por ejemplo, la volatilidad cayó o la liquidez cambió), los trades históricos pueden no ser representativos. Para tenerlo en cuenta:
- Usa una ventana móvil: haz bootstrap solo sobre los últimos N trades
- Pondera más los trades recientes: weighted bootstrap
- Divide los datos por regímenes de mercado y haz bootstrap por separado
Número pequeño de trades
El bootstrap es fiable con n > 30 trades. Si tienes 10 trades, ninguna cantidad de remuestreo ayudará. 491 trades es una muestra excelente; puedes confiar en los resultados.
Comparación de enfoques para evaluar la robustez del backtest
| Method | What it provides | Complexity | Time | When to use |
|---|---|---|---|---|
| Single backtest | One point estimate | Minimal | Seconds | Never as a final result |
| Walk-forward | Out-of-sample metrics | Medium | Minutes | To check for overfitting |
| Monte Carlo bootstrap | Confidence intervals | Minimal | ~2 sec | Always before production |
| Monte Carlo path | New price paths | High | Minutes-hours | For stress testing |
| Cross-validation | Average metrics across folds | Medium | Minutes | For parameter tuning |
El bootstrap Monte Carlo es el único método que, en un tiempo mínimo, ofrece una imagen completa de los riesgos.
Checklist: interpretación de resultados
Así recomendamos interpretar los resultados del bootstrap Monte Carlo:
Lanzar a producción si:
- el PnL en el percentil 5 es positivo
- el MaxDD en el percentil 5 es aceptable para tu apetito de riesgo
- la probabilidad de ruina es < 1%
- el Sharpe en el percentil 5 es > 0.5
Necesita trabajo si:
- el PnL en el percentil 5 está cerca de cero
- el MaxDD en el percentil 5 es significativamente peor que en el percentil 50
- la dispersión del fan chart es amplia — la estrategia es inestable
No lanzar si:
- el PnL en el percentil 5 es negativo
- la probabilidad de ruina es > 5%
- el intervalo de confianza del Sharpe incluye el 0
Nuestra experiencia en marketmaker.cc
En marketmaker.cc, desarrollamos nuestro propio motor de backtest, y el bootstrap Monte Carlo es una parte integral de nuestro pipeline. Cada estrategia pasa por el bootstrap automáticamente antes de ser aprobada para trading en vivo.
Integramos el bootstrap directamente en el motor de backtest: tras una ejecución, obtienes no solo el PnL final, sino un informe completo con intervalos de confianza, fan chart, probabilidad de ruina y una comparación de block vs. bootstrap estándar. Esto toma 2-3 segundos adicionales — un precio insignificante por entender los riesgos reales.
Por nuestra experiencia: aproximadamente el 30% de las estrategias que parecen atractivas según la estimación puntual quedan filtradas tras el bootstrap Monte Carlo. Su PnL en el percentil 5 se vuelve negativo o el MaxDD resulta inaceptable. Sin bootstrap, estas estrategias habrían llegado a producción y muy probablemente habrían generado pérdidas.
Conclusión
El bootstrap Monte Carlo son ~10 líneas de código y ~2 segundos de cómputo. Transforma un solo número de un backtest en una distribución completa con intervalos de confianza. Este es quizás el mayor ROI de cualquier herramienta de análisis cuantitativo:
- Costo mínimo: implementación en 30 minutos
- Beneficio máximo: comprensión de los riesgos reales de la estrategia
- Sin dependencias: solo NumPy
Si aún no usas bootstrap — añádelo a tu pipeline hoy mismo. Es la única forma de saber cuánto puedes confiar en los resultados de tu backtest.
References
- Efron, B. — Bootstrap Methods: Another Look at the Jackknife (1979)
- Davison, A.C., Hinkley, D.V. — Bootstrap Methods and their Application (Cambridge)
- Aronson, D.R. — Evidence-Based Technical Analysis: Monte Carlo permutation
- QuantStart — Monte Carlo Simulation for Backtest Analysis
- Marcos Lopez de Prado — Advances in Financial Machine Learning, Chapter 12: Backtesting
- Kevin Davey — Building Winning Algorithmic Trading Systems: Monte Carlo Analysis
- NumPy — numpy.random.choice
Citation
@software{soloviov2026montecarlobootstrap,
  author = {Soloviov, Eugen},
  title = {Monte Carlo Bootstrap: How to Get Confidence Intervals for a Backtest in 10 Lines of Code},
  year = {2026},
  url = {https://marketmaker.cc/ru/blog/post/monte-carlo-bootstrap-backtest},
  version = {0.1.0},
  description = {Why a single-point estimate from a backtest is a dangerous illusion. How Monte Carlo bootstrap in 2 seconds of computation gives you a 95\% confidence interval for PnL and MaxDD, and why this is a mandatory step before launching a strategy in production.}
}


