High-Performance Backtest Engines
How to build a backtest engine that runs hundreds of times faster without changing a single PnL number — data layout, caching, adaptive resolution, and architecture, from first speedups to production internals.
- 01
 Jun 26, 2026#algotrading
Thang Tốc Độ Backtest: 298x Trên CPU Laptop, PnL Giống Hệt Đến Giao Dịch Cuối
Năm cách triển khai của cùng một sweep tham số 80 combo, tất cả được xác minh cho ra PnL giống hệt nhau: pandas rolling.apply mất 69.9 giây, numpy 3.1, numba 2.0, numba song song 0.23 — mức tăng tốc đo được 298x trên Apple M2 Max mà không đổi bất kỳ phần cứng nào, và vẫn còn ~13x so với baseline vector hóa có năng lực. Mỗi bậc mang lại điều gì, tại sao GPU không phải là mảnh ghép còn thiếu, và nút thắt cổ chai thực sự trong tìm kiếm tham số quy mô lớn nằm ở đâu.
- 02
 Jul 2, 2026#algotrading
Thuế Framework: Khi Thư Viện Backtest Của Bạn Chậm Hơn Cả Một Vòng Lặp Pandas Ngây Thơ
Chúng tôi đã đo hiệu năng tám engine backtest trên cùng một parameter sweep — 150 nghìn bar, 80 tổ hợp HMA-cross, số lệnh khớp chốt ở mức 2707. Hai trong số các framework event-driven phổ biến nhất lại chậm hơn một vòng lặp pandas viết tay, trong khi một engine vectorized/compiled chạy cùng khối lượng công việc đó nhanh hơn ~13.000 lần. Một nghiên cứu về chi phí phụ trội theo từng bar mà các thư viện phổ biến chưa từng được thiết kế để khấu hao.
- 03
 Mar 16, 2026#algotrading
Bộ nhớ đệm Parquet tổng hợp: Cách tăng tốc backtest đa khung thời gian lên hàng trăm lần
Cách tính trước các khung thời gian và chỉ báo từ nến phút, lưu vào parquet, và sử dụng chúng để kiểm thử hàng loạt chiến lược mà không cần tính toán lại thừa.
- 04
 Jul 3, 2026#giao dịch thuật toán
Không gian tham số hai trục: Vì sao phần lớn phép quét của bạn nên gần như miễn phí
Không phải tham số nào cũng tốn chi phí tìm kiếm như nhau. Tham số của một chiến lược tách thành trục đắt (chỉ báo — phải tính lại trên toàn chuỗi giá) và trục rẻ (ngưỡng quyết định — một lượt duyệt O(n) trên tín hiệu đã tính sẵn). Vì chỉ báo bất biến với ngưỡng, bạn chỉ tính chúng một lần rồi quét hàng nghìn cấu hình ngưỡng ở tốc độ ~5,600 cfg/s — rẻ hơn khoảng 1,600 lần so với tính lại cho từng cấu hình. Một cách định giá lại lời nguyền số chiều.
- 05
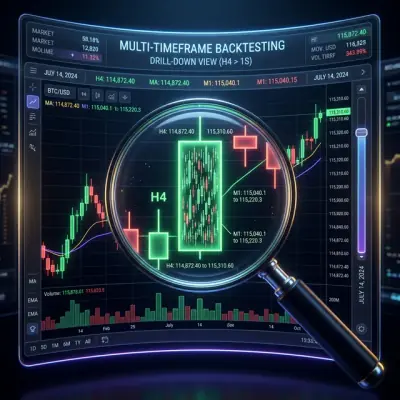 Mar 17, 2026#algotrading
Adaptive Drill-Down: Backtest với Độ Phân Giải Biến Đổi từ Phút đến Giao Dịch Thô
Cách độ phân giải dữ liệu thích ứng tăng tốc backtest và tiết kiệm lưu trữ: drill-down từ 1m xuống 1s, 100ms và giao dịch thô chỉ ở nơi giá biến động đáng kể hoặc khối lượng tăng đột biến, không phải trên toàn bộ chuỗi lịch sử.
- 06
 Jul 5, 2026#algotrading
Cổng Fidelity: Backtest Từ Thô Đến Tinh Đánh Lừa Bạn Nhanh Hơn Trừ Khi Proxy Rẻ Xếp Hạng Giống Đánh Giá Đắt Tiền
Tìm kiếm đào sâu / đa fidelity (ASHA, successive halving, Hyperband) sàng lọc hàng nghìn cấu hình với chi phí rẻ và chỉ đưa những cấu hình sống sót lên đánh giá đầy đủ đắt đỏ. Đây là một cách tăng tốc thực sự — nhưng nó sụp đổ trong im lặng nếu xếp hạng ở fidelity thấp không khớp với xếp hạng ở fidelity cao. Chúng tôi đã đo tương quan thứ hạng theo fold: ở một fold, Spearman ρ có thể chỉ là 0.03 (xếp hạng gần như ngẫu nhiên), rồi tăng lên 0.43, 0.67, 0.78, 0.91 khi số fold tích lũy dần. Cách khắc phục là một cổng bắt buộc duy nhất — đo ρ(rẻ, đầy đủ) trước, rồi tự động nâng fidelity tối thiểu lên bậc đầu tiên có ρ ≥ 0.5.
- 07
 Jul 4, 2026#giao dịch thuật toán
Random vs Smart Search: Điểm giao thoa nằm ở chi phí đánh giá, không phải thuật toán
Khi một lần backtest rẻ, Sobol scrambled kém tinh vi thắng về thông lượng thô — các sampler thông minh (TPE, CMA-ES, ASHA) phải trả một khoản thuế ask/tell bằng Python khiến chúng chậm đi 20 lần, nên chúng đánh giá được ít điểm hơn hẳn ở cùng wall-clock và thua cuộc. Khiến mỗi lần đánh giá trở nên đắt đỏ (multi-TF + các fold walk-forward) và điểm giao thoa đảo chiều. Chúng tôi đo cả hai chế độ, và lý do vì sao độ trung thực xếp hạng theo fold (ρ@1 tăng từ 0.03→0.43) là điều kiện tiên quyết để việc cắt tỉa (pruning) mang lại hiệu quả.
- 08
 Mar 11, 2026#algotrading
Coordinate Descent vs Tối ưu hóa Bayesian: Phương pháp nào tìm tham số tốt hơn
Tại sao tìm kiếm toàn bộ không thể thực hiện với 12+ tham số, cách coordinate descent bỏ lỡ các tương tác, và cách Optuna với TPE sampler tìm ra trong 500 vòng lặp những gì OAT không thể tìm trong 96. Ví dụ code thực tế, so sánh sampler và tối ưu hóa đa mục tiêu.
- 09
 Jul 6, 2026#giao dịch thuật toán
Cái bẫy độ chính xác GPU: Vì sao một backtest fp32 trên Apple Metal âm thầm trả về rác
GPU Metal của Apple không có float64. Chuyển một backtest được vector hóa sang nó một cách ngây thơ và thủ thuật WMA bằng prefix-sum đầy cám dỗ sẽ tràn fp32 — sai số tương đối lớn nhất 211× — vậy mà nó vẫn chạy và trả về những con số trông có vẻ hợp lý. Cách sửa không phải là thêm độ chính xác; đó là một công thức khác: tích chập cửa sổ trực tiếp, an toàn với fp32 tới 8×10⁻⁷ và nhanh hơn 55,9× so với numba đơn luồng. Cái bẫy, phép số học, và cách chứng minh bạn không rơi vào nó.
- 10
 Jul 7, 2026#giao dịch thuật toán
Khi Nào GPU Đáng Đồng Tiền: Roofline Của Sweep Tham Số, Nơi Con Số Tiêu Đề 167x Thực Ra Là 27x Thuật Toán Nhân 6.2x Phần Cứng
Lợi thế của GPU so với CPU tăng lên theo kích thước lô — 54.5x ở một combo mỗi lời gọi cho đến 359.6x ở 61 combo trên phép precompute chỉ báo đa khung thời gian của chúng tôi — bởi vì một sweep nhỏ không thể khấu hao chi phí khởi chạy kernel và truyền dữ liệu. Chúng tôi phân rã con số tiêu đề 167x thành một chiến thắng thuật toán 27x mà CPU cũng được hưởng và một chiến thắng phần cứng 6.2x, cho thấy lợi thế thực sự của GPU so với CPU tốt nhất chỉ là 3.2x với khung thời gian đơn và 6.2x với đa khung, và đưa ra một hướng dẫn quyết định về việc một sweep phải rộng đến mức nào trước khi đáng để đầu tư vào một GPU.
- 11
 Jun 30, 2026#algotrading
Thuế IPC: Đặt Engine Backtest Sau Một Socket Và Mất 13% — Nhưng Gần Như Không Gì Trong Đó Là Do Socket
Chúng tôi đã port một kernel backtest numba theo từng dòng sang Rust và gọi nó qua ranh giới tiến trình theo bốn cách khác nhau, với một cổng tương đương xác nhận PnL giống hệt đến tận giao dịch cuối cùng. Truyền toàn bộ chuỗi giá 1.2 MB qua một Unix socket tốn ~2 ms — khoảng 0.1% công việc. Mã hóa JSON cùng payload đó tốn gấp 1348x so với byte thô, các lệnh gọi chatty theo từng combo truyền lại dữ liệu 80 lần, và một mẫu hình gọi theo từng nến sẽ phải trả 2.1 s IPC thuần túy trên một công việc 2.0 s. Ranh giới thì rẻ; thuế nằm ở cách bạn băng qua nó.