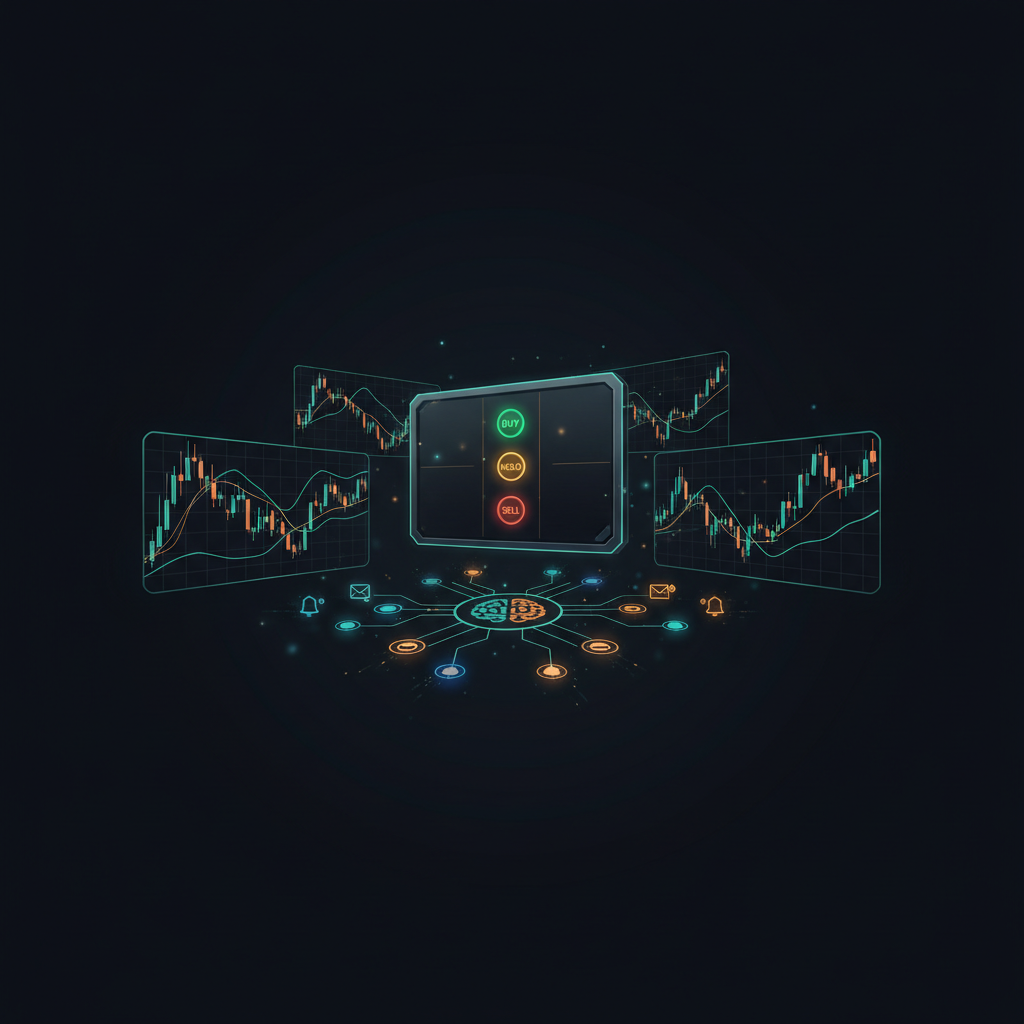

ZhuLinsen开发的daily_stock_analysis是当下星标数最高的AI金融项目之一——曾登上Trendshift单日Python仓库榜首。但有意思的并不是星标数量,而是这个项目拒绝假装自己能预测价格。相反,它解决的是一个更窄、却实用得多的问题:每个交易日,拿你的自选股清单生成一份结构化、可解释的分析报告——并把它送到你真正会去看的地方,也就是你的即时通讯工具。
项目作者免责声明: 仅供学习与研究使用,不构成投资建议。市场有风险。
核心思路:不是机器人,而是每日的分析师兼撰稿人
大多数“AI交易”仓库都在追逐同一个幻想:模型输入、信号输出、收益上涨。daily_stock_analysis建立在一个更诚实的前提之上——投资真正困难的部分不在于再多生成一个信号,而在于为某只标的拼出一幅完整、一致的全景图,并且每天都用同样的方式把它写下来。
因此它的行为更像一位按计划工作的初级分析师。整条管道是线性且清晰可读的:
| 阶段 | 发生了什么 |
|---|---|
| 数据抓取 | 行情、日K线、指标、资金流向、基本面、筹码 |
| 技术分析 | 均线、RSI、成交量、乖离率、趋势分类 |
| 新闻与资讯 | 按标的检索近期新闻、公告与情绪 |
| LLM分析 | 构建上下文包与提示词,产出JSON决策仪表盘 |
| 报告渲染 | Markdown报告,可选转换为图片 |
| 推送通知 | 推送到企业微信、飞书、Telegram、Discord、Slack或邮箱 |
默认情况下它按计划运行(工作日、收盘后),并会跳过非交易日。它覆盖A股、港股、美股及ETF,在数据源覆盖不到的地方,对日本与韩国市场提供降级支持。
低调而聪明的部分:数据回退

项目里最稳健的工程决策不是LLM——而是它如何默认把数据视为不可靠。
行情数据通过六个数据提供方组成的优先级链来抓取,每一个都是上一个的回退方案:
Efinance (P0) → Tencent (P0) → Akshare (P1) → Pytdx (P2) → Baostock (P3) → Yfinance (P4)
当你分析一只美股标的时,系统会自动跳过仅限中国的数据源,并转向Yahoo Finance。如果某个数据源失败、超时或只返回部分数据,本次运行会让对应的那一块降级,而不是让整份报告崩溃。提示词甚至会被告知哪些数据块是fallback、partial或missing——这样模型就被要求写出“数据不可用”,而不是编造一个数字。
对于任何生产系统而言,这都是正确的直觉:单个数据源失败绝不应该拖垮整个分析。 把每一路数据源都当作尽力而为,统一字段,并让缺失的数据可见,而不是被悄悄填上。
决策仪表盘
LLM并不返回散文——它返回的是一份严格的JSON“决策仪表盘”,报告会把它渲染成统一的版式:
- 核心结论 — 一句话:买入、持有或观望,并附上时间敏感度。
- 分场景建议 — 对持仓者与空仓者给出不同的指引。
- 数据视角 — 均线排列、价格相对支撑/阻力位、乖离率、量能解读。
- 资讯 — 风险提示与利好催化剂,每一条都必须带日期。
- 作战计划 — 具体的狙击点位:理想买点、止损、目标、仓位管理。
- 检查清单 — 每个条件标注 ✅ / ⚠️ / ❌(多头排列、乖离在区间内、量能、无重大利空、估值)。
提示词中内置的纪律是有明确立场且合乎情理的:不追高(高于MA5超过5%的乖离是硬性的“不买”),只在多头排列时交易(MA5 > MA10 > MA20),偏好在缩量回踩支撑时买入,并且绝不因为单日波动就在买入和卖出之间反复切换。
智能体策略:向系统提问
除了每日报告,项目还提供了一种智能体模式,内置15套策略剧本,你可以针对每只标的进行问询:
| 类别 | 示例 |
|---|---|
| 趋势 / 均线 | 均线金叉、多头趋势 |
| 结构理论 | 缠论、艾略特波浪 |
| 行为 / 流动性 | 情绪周期、放量突破、底部放量、缩量回踩 |
| 催化 / 叙事 | 热点题材、事件驱动、预期重定价 |
| 质量 / 成长 | 成长质量 |
每个策略都是一个YAML文件,拥有自己的规则、所需工具与评分调整——因此这份“智能”是可配置、可审计的,而不是藏在一个庞大的提示词里。
如何在不自欺的前提下解读它
任何这类项目都很容易被过度信任。一份诚实的评估清单:
- 新闻来源质量。 资讯模块的好坏完全取决于你配置的检索提供方——没有它们,情绪与催化剂就会空白,报告将完全依赖技术面。
- 确定性。 LLM输出会有波动;同一只标的在不同次运行中读起来可能略有差异。把仪表盘当作一种结构化的观点,而非固定的真理。
- 各市场覆盖度。 A股的深度数据(资金流向、筹码、龙虎榜)在数据无法覆盖的市场上会优雅降级为
not_supported。 - 数据新鲜度。 留意
fallback/partial标记——降级的输入应当降低你的信心,正如提示词所指示的那样。 - 回测 ≠ 盈利。 报告是决策支持,而不是经过验证的优势。
局限与诚实评估
daily_stock_analysis不是什么:
- 不是执行系统。 它做分析和报告;它不下单,也不对流动性建模。
- 依赖模型。 输出质量取决于你接入的LLM。
- 依赖检索。 没有新闻API密钥,报告中定性的那一半就会变得稀薄。
- 非确定性。 完全相同的输入也可能产出略有差异的仪表盘。
链接
- 💻 GitHub: ZhuLinsen/daily_stock_analysis
- 📄 许可证: MIT
结语
daily_stock_analysis的价值不在于它是一个先知,而在于它是一种被自动化的、可重复的分析习惯:
- 把“看一只股票”到底意味着什么标准化,每天如此。
- 把数据视为不可靠,并让缺口可见。
- 让结论可解释——评分、点位、检查清单、风险。
- 把想法生成(15套策略)与有纪律的决策框架分开。
用于学习、每日复盘以及为研究工作流做原型,它做得很扎实。要走向生产,下一层就是每个严肃系统都需要的那一层:经过验证的数据、模型漂移控制、贴近现实的执行,以及活在代码里、而不仅仅活在提示词里的风险规则。