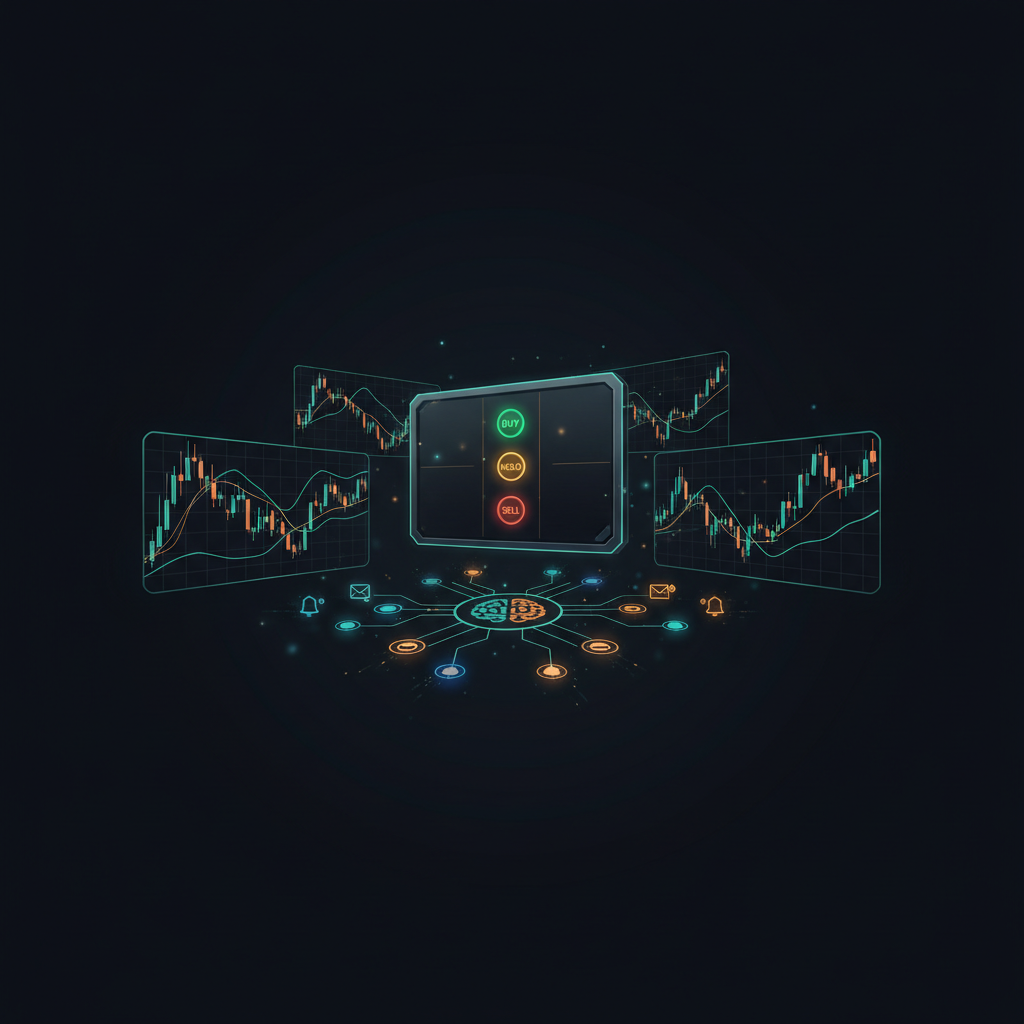

ZhuLinsen이 만든 daily_stock_analysis는 지금 가장 많은 스타를 받은 AI 금융 프로젝트 중 하나로, Trendshift에서 그날의 Python 저장소 1위에 올랐다. 하지만 흥미로운 부분은 스타 수가 아니다. 이 프로젝트가 가격을 예측하는 척하기를 거부한다는 점이다. 대신, 더 좁지만 훨씬 더 유용한 문제를 푼다. 즉, 매 거래일마다 당신의 관심 종목 목록을 받아 구조화되고 설명 가능한 분석 리포트를 만들어 — 당신이 실제로 무언가를 읽는 곳, 바로 당신의 메신저로 전달한다.
프로젝트 작성자의 면책 조항: 학습 및 연구 목적으로만 사용한다. 투자 조언이 아니다. 시장에는 리스크가 따른다.
핵심 아이디어: 봇이 아니라, 매일의 애널리스트 겸 리포터
대부분의 "AI 트레이딩" 저장소는 같은 환상을 좇는다. 모델에 넣으면 시그널이 나오고 돈이 늘어난다. daily_stock_analysis는 더 정직한 전제 위에 세워져 있다 — 투자에서 어려운 부분은 시그널을 하나 더 생성하는 것이 아니라, 한 종목에 대한 완전하고 일관된 그림을 조립하고 그것을 매일 같은 방식으로 적어 내려가는 것이다.
그래서 이 시스템은 일정에 따라 일하는 주니어 애널리스트처럼 동작한다. 파이프라인은 선형적이고 읽기 쉽다.
| 단계 | 무슨 일이 일어나는가 |
|---|---|
| 데이터 수집 | 호가, 일봉, 지표, 자금 흐름, 펀더멘털, 칩 |
| 기술적 분석 | 이동평균, RSI, 거래량, 이격도, 추세 분류 |
| 뉴스 & 인텔리전스 | 종목별로 최근 뉴스, 공시, 감성을 검색 |
| LLM 분석 | 컨텍스트 팩과 프롬프트를 구성하고, JSON 의사결정 대시보드를 생성 |
| 리포트 렌더링 | Markdown 리포트, 선택적으로 이미지로 변환 |
| 알림 | WeCom, Feishu, Telegram, Discord, Slack 또는 이메일로 푸시 |
기본적으로 일정(평일, 장 마감 후)에 따라 실행되며, 비거래일은 건너뛴다. A주, 홍콩, 미국 주식과 ETF를 커버하며, 데이터 소스가 닿지 않는 영역에서는 일본과 한국 시장을 축소된 수준으로 지원한다.
조용히 영리한 부분: 데이터 폴백

이 프로젝트에서 가장 견고한 엔지니어링 결정은 LLM이 아니다 — 그것은 데이터를 기본적으로 신뢰할 수 없는 것으로 다루는 방식이다.
시장 데이터는 6개 제공자로 이루어진 우선순위 체인을 통해 가져오며, 각각은 이전 것의 폴백 역할을 한다.
Efinance (P0) → Tencent (P0) → Akshare (P1) → Pytdx (P2) → Baostock (P3) → Yfinance (P4)
미국 종목을 분석할 때, 시스템은 중국 전용 제공자를 자동으로 건너뛰고 Yahoo Finance로 라우팅한다. 어떤 소스가 실패하거나, 타임아웃되거나, 부분적인 데이터를 반환하면, 해당 실행은 리포트 전체를 무너뜨리는 대신 그 한 블록만 강등시킨다. 프롬프트에는 어떤 블록이 fallback, partial, missing인지까지 전달된다 — 그래서 모델은 숫자를 지어내는 대신 "데이터를 사용할 수 없음"이라고 적도록 요구받는다.
이것은 어떤 프로덕션 시스템에서도 올바른 직관이다. 단일 데이터 소스의 실패가 분석 전체를 다운시키는 일은 결코 있어서는 안 된다. 모든 피드를 최선의 노력으로 다루고, 필드를 표준화하며, 누락된 데이터를 조용히 채우는 대신 보이게 만든다.
의사결정 대시보드
LLM은 산문을 반환하지 않는다 — 엄격한 JSON "의사결정 대시보드"를 반환하며, 리포트는 이를 일관된 레이아웃으로 렌더링한다.
- 핵심 결론 — 한 문장: 매수, 보유 또는 관망, 그리고 시간 민감도.
- 상황별 조언 — 포지션을 보유한 사람과 현금을 가진 사람에게 서로 다른 가이드.
- 데이터 관점 — MA 정렬, 가격 대 지지/저항, 이격도, 거래량 해석.
- 인텔리전스 — 리스크 경고와 긍정적 촉매, 각각 반드시 날짜를 동반한다.
- 작전 계획 — 구체적인 저격 지점: 이상적인 매수, 손절, 목표, 포지션 사이징.
- 체크리스트 — 모든 조건에 ✅ / ⚠️ / ❌ 표시(강세 정렬, 이격도 범위 내, 거래량, 중대한 악재 없음, 밸류에이션).
프롬프트에 새겨진 규율은 명확한 입장을 지니면서도 합리적이다. 추격하지 않는다(MA5보다 5%를 초과하는 이격도는 절대적인 "매수 금지"), 강세 MA 정렬(MA5 > MA10 > MA20)에서만 거래한다, 거래량이 줄어든 지지선으로의 눌림목 매수를 선호한다, 그리고 하루의 움직임만으로 매수와 매도 사이를 결코 오가지 않는다.
에이전트 전략: 시스템에 질문하기
일일 리포트 외에도, 이 프로젝트는 종목별로 질의할 수 있는 15개의 내장 전략 플레이북을 갖춘 에이전트 모드를 제공한다.
| 계열 | 예시 |
|---|---|
| 추세 / 이동평균 | MA 골든크로스, 강세 추세 |
| 구조 이론 | 찬(선) 이론, 엘리엇 파동 |
| 행동 / 유동성 | 감정 사이클, 거래량 돌파, 바닥 거래량, 축소 눌림목 |
| 촉매 / 내러티브 | 핫 테마, 이벤트 드리븐, 기대 리프라이싱 |
| 품질 / 성장 | 성장 품질 |
각 전략은 자체 규칙, 필요한 도구, 스코어링 조정을 가진 YAML 파일이다 — 그래서 이 "인텔리전스"는 설정 가능하고 감사 가능하며, 하나의 거대한 프롬프트 안에 숨겨져 있지 않다.
자기기만 없이 읽는 법
이런 종류의 프로젝트는 모두 과신하기 쉽다. 정직한 평가 체크리스트는 다음과 같다.
- 뉴스 소스 품질. 인텔리전스 블록은 당신이 설정한 검색 제공자만큼만 좋다 — 그것들이 없으면 감성과 촉매는 비어 버리고, 리포트는 전적으로 기술적 분석에 기댄다.
- 결정성. LLM 출력은 변동한다. 같은 종목이라도 실행마다 약간 다르게 읽힐 수 있다. 대시보드를 고정된 진실이 아니라 구조화된 의견으로 다뤄라.
- 시장별 커버리지. A주의 깊이(자금 흐름, 칩, 용호방)는 데이터가 커버하지 않는 시장에서
not_supported로 우아하게 강등된다. - 데이터 신선도.
fallback/partial플래그를 주시하라 — 강등된 입력은 프롬프트가 지시하는 대로 당신의 확신을 낮춰야 한다. - 백테스트 ≠ 수익. 리포트는 의사결정 지원이지, 검증된 우위가 아니다.
한계와 정직한 평가
daily_stock_analysis가 아닌 것:
- 실행 시스템이 아니다. 분석하고 리포트한다. 주문을 내거나 유동성을 모델링하지 않는다.
- 모델 의존적. 출력 품질은 당신이 연결한 LLM을 따라간다.
- 검색 의존적. 뉴스 API 키가 없으면 리포트의 정성적인 절반이 얇아진다.
- 비결정적. 동일한 입력이라도 약간 다른 대시보드를 낼 수 있다.
링크
- 💻 GitHub: ZhuLinsen/daily_stock_analysis
- 📄 라이선스: MIT
결론
daily_stock_analysis가 가치 있는 것은 신탁으로서가 아니라, 자동화된 반복 가능한 분석 습관으로서다.
- "주식을 본다"는 것이 무엇을 의미하는지를 매일 표준화한다.
- 데이터를 신뢰할 수 없는 것으로 다루고, 빈틈을 보이게 만든다.
- 결론을 설명 가능하게 만든다 — 점수, 레벨, 체크리스트, 리스크.
- 아이디어 생성(15개 전략)을 규율 있는 의사결정 틀에서 분리한다.
학습, 일일 복기, 그리고 리서치 워크플로 프로토타이핑에는 잘 만들어져 있다. 프로덕션을 향해서는, 다음 계층은 모든 진지한 시스템이 필요로 하는 바로 그것이다. 검증된 데이터, 모델 드리프트 제어, 현실적인 실행, 그리고 프롬프트 안에만이 아니라 코드 안에 살아 있는 리스크 규칙.