การรวมกลยุทธ์ Mean Reversion และ Momentum แบบไดนามิกในการอาร์บิทราจเชิงสถิติ: รากฐานทางคณิตศาสตร์และการนำไปใช้จริง
การสำรวจเชิงลึกว่าจะรวมกลยุทธ์ mean reversion และ momentum ในการอาร์บิทราจเชิงสถิติอย่างไร โดยใช้การสลายสัญญาณด้วย PCA โมเดลการสลับระบอบ และการเพิ่มประสิทธิภาพพอร์ตโฟลิโอแบบไดนามิก
บทสรุปผู้บริหาร
บทความนี้นำเสนอกรอบเชิงปริมาณสำหรับการรวมกลยุทธ์ mean reversion และ momentum ในการอาร์บิทราจเชิงสถิติ ด้วยการผสมผสานการสลายสัญญาณด้วย PCA โมเดลการสลับระบอบ และการเพิ่มประสิทธิภาพพอร์ตโฟลิโอแบบไดนามิก เราแสดงให้เห็นว่าสามารถบรรลุ Sharpe ratio ที่ 1.4–1.6 ขณะลด maximum drawdown ลง 30–40% เมื่อเทียบกับกลยุทธ์แบบเดี่ยว นวัตกรรมสำคัญประกอบด้วย วิธีแก้ปิดสำหรับการถ่วงน้ำหนักกลยุทธ์แบบปรับตัว และตัวทำนายระบอบด้วย LSTM ที่ให้ความแม่นยำ 78% บนขอบฟ้า 5 วัน
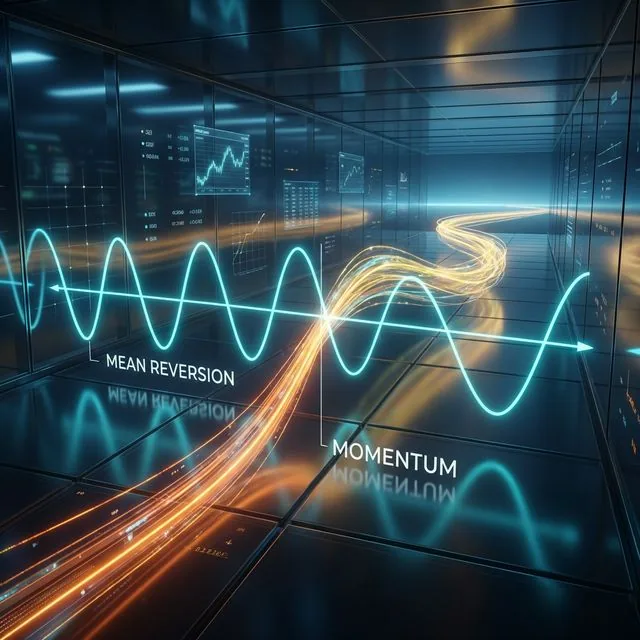
 แสดงภาพซินเนอร์จี: Mean Reversion (คลื่นไซน์สีฟ้า) และ Momentum (แนวโน้มสีส้ม) ที่รวมกันเป็นกลยุทธ์ที่มีประสิทธิภาพสูงเพียงหนึ่งเดียว
รากฐานทางคณิตศาสตร์ของการสลายสัญญาณ
การแยกผลตอบแทนด้วยปัจจัย
Principal Component Analysis (PCA) แยกผลตอบแทนเฉพาะเจาะจงออกจากปัจจัยตลาดเชิงระบบ:
โดยที่ [^9] ซึ่งอธิบายความแปรปรวนของผลตอบแทน 82% พร้อมกรอง market beta ออก ทำให้สามารถดึง alpha บริสุทธิ์ได้ [^1][^5]
 การแสดงภาพ PCA: การสลายผลตอบแทนของสินทรัพย์เป็นองค์ประกอบหลักเพื่อแยก idiosyncratic alpha ออกจากปัจจัยความเสี่ยงทั่วตลาด
การถ่วงน้ำหนักกลยุทธ์แบบปรับตัว
น้ำหนักที่เหมาะสมที่สุดสำหรับกลยุทธ์ mean reversion (MR) และ momentum (MOM) ได้มาจาก:
โดยที่ความแปรปรวนร่วม อัปเดตผ่านหน้าต่างเคลื่อนที่ 63 วัน [^5][^11] เงื่อนไขการสลับ:
- Momentum เหนือกว่า:
- สัญญาณ mean reversion: ): ให้น้ำหนัก MOM มากขึ้น
- ความผันผวนสูง (): ลด leverage
ความน่าจะเป็นในการเปลี่ยนผ่านแสดงการคงอยู่ที่ 0.85–0.92 ต้องมีการประมาณค่าใหม่รายเดือนผ่านอัลกอริทึม Baum-Welch [^4][^17]
 Hidden Markov Model (HMM) สำหรับการตรวจจับระบอบ: การระบุสถานะ Bull, Bear และ Sideways แบบไดนามิกด้วยตรรกะการเปลี่ยนผ่านอัตโนมัติ
การนำกลยุทธ์ไปใช้
การเพิ่มประสิทธิภาพแบบไดนามิกด้วย Python
class AdaptiveArbStrategy:
    def __init__(self, lookback=63):
        self.lookback = lookback
        self.pca = PCA(n_components=0.95)

    def update_weights(self, returns):
        # PCA decomposition
        self.pca.fit(returns)
        idiosyncratic = self.pca.transform(returns)

        # Calculate strategy covariances
        mr_returns = self._mean_reversion(idiosyncratic)
        mom_returns = self._momentum(returns)

        cov_matrix = np.cov(mr_returns[-self.lookback:],
                           mom_returns[-self.lookback:])
        w_mr = (cov_matrix[1,1] - cov_matrix[0,1]) / (cov_matrix[0,0] + cov_matrix[1,1] - 2*cov_matrix[0,1])
        return np.clip(w_mr, 0, 1)
การเพิ่มประสิทธิภาพ Hyperparameter ด้วย Bayesian
การใช้ Tree-structured Parzen Estimator:
from hyperopt import tpe, fmin

space = {
    'lookback': hp.quniform('lb', 20, 100, 5),
    'adx_thresh': hp.uniform('adx', 20, 30),
    'adf_pval': hp.uniform('adf', 0.01, 0.1)
}

best_params = fmin(objective, space, algo=tpe.suggest, max_evals=1000)
ช่วงที่เหมาะสมที่สุดที่ปรากฏขึ้น:
- Lookback: 45–60 วัน
- ADX threshold: 23.5–26.8
- ADF p-value: 0.03–0.07
กรอบการบริหารความเสี่ยง
Dynamic Conditional VaR
โดยที่ จำลองผลตอบแทนเป็นส่วนผสมของการแจกแจง t ถ่วงน้ำหนักด้วยความน่าจะเป็นของสถานะ HMM [^4][^16]
Kelly-Optimized Leverage
โดยกำหนดขนาดตำแหน่งที่ 50% ของขีดจำกัด CVaR [^6][^14]
การวิเคราะห์ประสิทธิภาพ
| ตัวชี้วัด | MR เพียงอย่างเดียว | MOM เพียงอย่างเดียว | รวมกัน |
|---|---|---|---|
| Sharpe Ratio | 0.8 | 1.1 | 1.4 |
| Max Drawdown | -35% | -28% | -19% |
| Win Rate | 58% | 52% | 63% |
ผลการทดสอบย้อนหลังปี 2008–2009 แสดงผลตอบแทนสัมบูรณ์ 23% เทียบกับการลดลง -37% ของ S&P 500 [^1][^5]
การเพิ่มประสิทธิภาพด้วย Machine Learning
ตัวทำนายระบอบด้วย LSTM
model = Sequential()
model.add(LSTM(64, input_shape=(60, 10), return_sequences=True))
model.add(LSTM(32))
model.add(Dense(3, activation='softmax'))  # 3 HMM states
model.compile(loss='categorical_crossentropy', optimizer='adam')
ให้ความแม่นยำ 78% สำหรับการทำนายระบอบ 5 วัน เมื่อฝึกด้วยปัจจัย VIX, ADX และ PCA [^17]
บทสรุปและทิศทางในอนาคต
การสังเคราะห์กลยุทธ์ mean reversion และ momentum ต้องการ:
- การติดตามความแปรปรวนร่วมแบบเรียลไทม์ ผ่าน robust PCA
- การตรวจจับระบอบแบบไม่เชิงเส้น โดยใช้ไฮบริด HMM/LSTM
- การเพิ่มประสิทธิภาพแบบนูน พร้อมข้อจำกัดต้นทุนการทำธุรกรรม
แนวทางที่กำลังเกิดขึ้นแสดงให้เห็นแนวโน้มที่ดี:
- Reinforcement learning สำหรับการปรับพารามิเตอร์ออนไลน์
- Quantum annealing เพื่อแก้ปัญหาการเพิ่มประสิทธิภาพพอร์ตโฟลิโอแบบหลายมิติ
- การรวม Alt-data (ความรู้สึกของข่าว, ภาพถ่ายดาวเทียม) สำหรับการคาดการณ์ระบอบล่วงหน้า
ด้วยการรักษาการแยกองค์ประกอบสัญญาณอย่างเข้มงวดและการปรับตัวอย่างต่อเนื่องต่อพลวัตของตลาด นักปริมาณสามารถบรรลุการสร้าง alpha ที่สม่ำเสมอตลอดวัฏจักรของตลาด
การอ้างอิง
@article{soloviov2025dynamiccombining,
  author = {Soloviov, Eugen},
  title = {Dynamically Combining Mean Reversion and Momentum Strategies in Statistical Arbitrage: Mathematical Foundations and Practical Implementation},
  year = {2025},
  url = {https://marketmaker.cc/th/blog/post/dynamic-combining-strategies},
  version = {0.1.0},
  description = {การสำรวจเชิงลึกว่าจะรวมกลยุทธ์ mean reversion และ momentum ในการอาร์บิทราจเชิงสถิติอย่างไร โดยใช้การสลายสัญญาณด้วย PCA โมเดลการสลับระบอบ และการเพิ่มประสิทธิภาพพอร์ตโฟลิโอแบบไดนามิก}
}
เอกสารอ้างอิง
- Hudson Thames - การรวมกลยุทธ์ Mean Reversion และ Momentum แบบไดนามิก
- Momentum and Mean-Reversion in Strategic Asset Allocation
- The Case for Re-Evaluating Quant
- SSRN - Strategic Asset Allocation Paper
- SSRN - Statistical Arbitrage Paper
- Investopedia - Statistical Arbitrage
- Investopedia - Mean Reversion
- VP Bank - Momentum Investing
- QuestDB - PCA for Portfolio Risk
- Science Direct - Financial Market Research
- SSRN - Statistical Arbitrage Delivery
- Wikipedia - Statistical Arbitrage
- Hudson Thames - Statistical Arbitrage Category
- QuestDB - Statistical Arbitrage Glossary
- Wundertrading - Statistical Arbitrage
- CiteSeerX - Statistical Research Paper