12 อัลกอริทึมการปรับพอร์ตโฟลิโอให้เหมาะที่สุด เปรียบเทียบกัน: HRP, Black-Litterman, NCO และอื่น ๆ
คริปโตหนึ่งตะกร้า สิบสองอัลกอริทึมการจัดสรร หนึ่งการเปรียบเทียบที่ซื่อสัตย์ เราเปิดซอร์ส Rust portfolio optimizer ที่รัน HRP, HERC, MVO, Black-Litterman, NCO, Entropy Pooling และอื่น ๆ ผ่านอินเทอร์เฟซเดียว - นี่คือวิธีคิดของแต่ละตัว และเหตุใดจึงไม่มีผู้ชนะเพียงคนเดียว
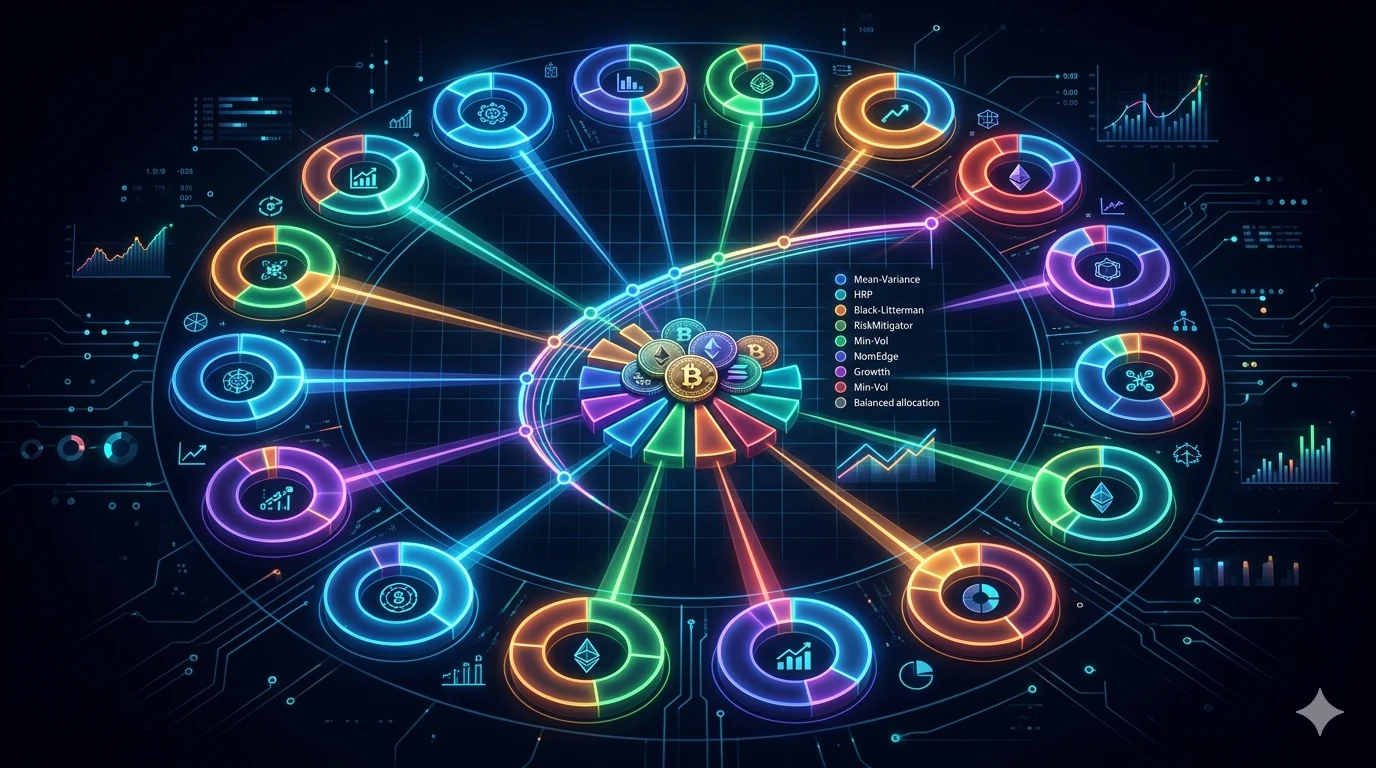
ทุก portfolio optimizer ตอบคำถามเดียวกัน: เมื่อกำหนดประวัติราคาของสินทรัพย์จำนวนหนึ่ง ควรจัดสรรเงินทุนกี่เปอร์เซ็นต์ให้กับแต่ละสินทรัพย์? ปัญหาคือไม่มีคำตอบเดียวที่ถูกต้อง — มีเพียงกลุ่มคำตอบ แต่ละคำตอบเป็นผลมาจากสมมติฐานที่แตกต่างกันเกี่ยวกับพฤติกรรมของตลาด และความมั่นใจในการประมาณค่าของตัวเอง
แทนที่จะเดิมพันกับวิธีเดียว เราจึงสร้างเครื่องมือที่รัน สิบสอง วิธีพร้อมกัน ทั้งหมดผ่านอินเทอร์เฟซเดียว และให้คุณดูว่าพวกมันไม่เห็นด้วยกับข้อมูลจริงอย่างไร เป็นโอเพนซอร์ส เขียนด้วย Rust และอยู่ที่ portfolio-optimizer.marketmaker.cc บทความนี้คือแผนที่: อัลกอริทึมแต่ละตัวเชื่ออะไร คณิตศาสตร์มาจากไหน และเกิดอะไรขึ้นเมื่อคุณเล็งทั้งสิบสองตัวไปที่ตะกร้าคริปโตเดียวกัน
อินเทอร์เฟซเดียว สิบสองความคิดเห็น
ทุกอัลกอริทึมในโปรเจกต์นี้เปิดเผย function signature เดียวกัน:
pub fn optimize(prices: &[Vec<f64>]) -> Vec<f64>
ส่งราคาเข้าไป ได้น้ำหนักออกมา น้ำหนักเป็น long-only ไม่ติดลบ และรวมกันได้ 1.0 ความสม่ำเสมอนี้คือจุดประสงค์ทั้งหมด — หมายความว่าคุณสามารถสลับ Hierarchical Risk Parity กับ Mean-Variance Optimization โดยไม่ต้องแตะโค้ดที่เรียกใช้แม้แต่บรรทัดเดียว และสามารถ benchmark ทั้งหมดบน input ที่เหมือนกัน อัลกอริทึมแต่ละตัวอยู่ใน crate ของตัวเอง (portfolio-hrp, portfolio-mvo, portfolio-nco, …) เพื่อให้คุณสามารถพึ่งพาเพียงตัวเดียวที่ต้องการ
ภายใต้ฝากระโปรง พวกมันแตกต่างกันอย่างสิ้นเชิง มาดูกันตามกลุ่ม
คลาสสิก: Mean-Variance Optimization (MVO)
นี่คือจุดเริ่มต้นของทฤษฎีพอร์ตโฟลิโอสมัยใหม่ — Harry Markowitz, 1952 MVO ปฏิบัติต่อการจัดสรรเป็นการปรับให้เหมาะที่สุดภายใต้ข้อจำกัด: เพิ่มผลตอบแทนที่คาดหวังให้สูงสุดสำหรับระดับความเสี่ยงที่กำหนด อย่างเป็นทางการ คุณแก้ปัญหา
โดยที่ คือเวกเตอร์ของผลตอบแทนที่คาดหวัง คือเมทริกซ์ความแปรปรวนร่วม และ คือความไม่ชอบความเสี่ยงของคุณ เมื่อ input ดี MVO ไม่มีใครเทียบได้: มันคือ efficient frontier โดยการก่อสร้าง
ปัญหาคือ input ไม่เคยดีเลย ผลตอบแทนที่คาดหวัง ถูกประมาณจากประวัติที่มีสัญญาณรบกวน และ MVO มีความไวต่อมันอย่างเหลือเชื่อ — การเปลี่ยนแปลงเล็กน้อยในการประมาณค่าสามารถเปลี่ยนการจัดสรรจาก 80% ในสินทรัพย์หนึ่งไปอีก 80% ในสินทรัพย์อื่นได้ นักปฏิบัติเรียกมันว่า "error maximization": optimizer จะเทเงินทุนเข้าไปในสินทรัพย์ที่มีการประมาณผลตอบแทนสูงเกินจริงมากที่สุดอย่างมีความสุข MVO คือ benchmark ที่ทุกคนวัดเทียบและเรื่องเตือนใจที่ทุกคนอ้างถึง
กลุ่ม Hierarchical: HRP, HERC, GHRP, MHRP
ในปี 2016 Marcos López de Prado เสนอแนวคิดที่แตกต่าง: อย่า invert เมทริกซ์ความแปรปรวนร่วมเลย Hierarchical Risk Parity (HRP) หลีกเลี่ยงความไม่เสถียรของ MVO โดยไม่แก้ปัญหาการปรับให้เหมาะที่สุดโดยตรงเลย ทำงานใน 3 ขั้นตอน:
- Tree clustering — แปลงเมทริกซ์ความสัมพันธ์เป็นเมตริกระยะทาง และสร้างลำดับชั้นของสินทรัพย์ เพื่อให้สินทรัพย์ที่คล้ายกันอยู่ในสาขาเดียวกัน
- Quasi-diagonalization — จัดเรียงเมทริกซ์ความแปรปรวนร่วมใหม่เพื่อให้สินทรัพย์ที่สัมพันธ์กันอยู่ติดกัน โดยรวมค่าขนาดใหญ่ไว้ตามแนวทแยง
- Recursive bisection — แบ่งต้นไม้จากบนลงล่าง โดยจัดสรรเงินทุนระหว่างสองซีกในสัดส่วนผกผันกับความแปรปรวน
ผลลัพธ์คือพอร์ตโฟลิโอที่เคารพ โครงสร้าง ของตลาด — สินทรัพย์ที่สัมพันธ์กันแข่งขันกันเองเพื่อน้ำหนัก ไม่ใช่แข่งกับทุกอย่างพร้อมกัน HRP มีความเสถียรกว่า MVO นอกตัวอย่างอย่างมาก เพราะมันไม่เคย invert เมทริกซ์ที่มีเงื่อนไขไม่ดี
โปรเจกต์มีสมาชิกสี่คนในกลุ่มนี้:
- HRP — อัลกอริทึมดั้งเดิมของ López de Prado
- HERC (Hierarchical Equal Risk Contribution) — แทนที่การแบ่งตาม inverse-variance ด้วยกฎ equal-risk-contribution ที่แต่ละ node เพื่อให้ทุก cluster มีส่วนร่วมในความเสี่ยงรวมเท่ากัน
- GHRP (Generalized HRP) — การสรุปทั่วไปแบบมีพารามิเตอร์ที่ให้คุณปรับขั้นตอนการ clustering และการจัดสรร
- MHRP (Modified HRP) — ตัวแปรที่ปรับน้ำหนักการแบ่งสำหรับการแจกแจงผลตอบแทนที่มี tail หนักกว่า
พวกมันเป็นญาติใกล้ชิด แต่บนข้อมูลจริงพวกมันแตกต่างกันอย่างมีนัยสำคัญ — นั่นคือเหตุผลที่มีทั้งสี่ตัวจะเป็นประโยชน์
การใส่มุมมอง: Black-Litterman
โมเดล Black-Litterman (Goldman Sachs, ทศวรรษ 1990) ถูกสร้างขึ้นเพื่อแก้ไขข้อบกพร่องที่ปฏิบัติได้จริงที่สุดของ MVO: มันบังคับให้คุณระบุผลตอบแทนที่คาดหวังสำหรับ ทุก สินทรัพย์ แม้แต่สินทรัพย์ที่คุณไม่มีความคิดเห็น Black-Litterman เริ่มจาก equilibrium ที่บอกเป็นนัยโดยตลาด ที่เป็นกลาง และให้คุณผสมมุมมองของตัวเอง โดยถ่วงน้ำหนักตามความมั่นใจ
ที่นี่ คือผลตอบแทน equilibrium, และ เข้ารหัสมุมมองของคุณ ("สินทรัพย์ A จะ outperform สินทรัพย์ B โดย 2%") และ คือความไม่แน่นอนของมุมมองเหล่านั้น เมื่อคุณไม่มีมุมมอง มันจะยุบตัวกลับไปเป็น market portfolio; เมื่อคุณมั่นใจ มันจะเอียงอย่างหนักไปทางการเดิมพันของคุณ มันเป็น opinion-aware ที่สุดในบรรดาสิบสองตัว
ไฮบริด: Nested Clustered Optimization (NCO)
NCO ก็มาจาก López de Prado เช่นกัน เป็นการผสมผสานที่ชาญฉลาดของสองโลกข้างต้น มัน cluster สินทรัพย์เหมือน HRP แล้วรัน Mean-Variance Optimization ขนาดเล็กที่มีเงื่อนไขดีภายในแต่ละ cluster และอีกครั้งข้าม cluster โดยการ invert เฉพาะ sub-matrix ขนาดเล็กและเสถียร NCO จับ optimality ของ MVO ไว้ในที่ที่ปลอดภัยที่จะใช้ ในขณะที่หลีกเลี่ยงความไม่เสถียรของการ invert เมทริกซ์ความแปรปรวนร่วมขนาดใหญ่ตัวเดียว มักเป็นตัวที่ดีที่สุดของทั้งสองพฤติกรรม
ส่วนที่เหลือของรายการ
- Entropy Pooling (Meucci) — กรอบงานเชิงความน่าจะเป็นที่ค้นหาการแจกแจงที่ใกล้เคียงกับ prior ของคุณมากที่สุด (โดย relative entropy) ขณะที่ตอบสนองชุดมุมมองเป็นข้อจำกัด หรูหราเมื่อคุณต้องการแสดงความไม่แน่นอนแทนการพยากรณ์แบบจุด
- OLPS (Online Portfolio Selection) — กลุ่มกลยุทธ์ตามลำดับ (universal portfolios, follow-the-winner, mean-reversion) ที่ rebalance เมื่อราคาใหม่มาถึง พร้อม regret bounds ที่พิสูจน์ได้ วิธีเดียวที่เป็น online อย่างแท้จริงในชุด
- RBA (Robust Bayesian Allocation) — ห่อการจัดสรรด้วยชั้น Bayesian shrinkage ดึงการประมาณที่มีสัญญาณรบกวนไปทาง prior ที่สมเหตุสมผล เพื่อไม่ให้เดือนแปลก ๆ เดียวครอบงำน้ำหนัก
- TIC (Theory-Implied Correlation) — แทนที่เมทริกซ์ความสัมพันธ์ตัวอย่างดิบด้วยตัวที่ถูก denoise ตามโครงสร้างทางทฤษฎี (มักเป็นอนุกรมวิธานทางเศรษฐกิจ) ซึ่งสามารถปรับปรุงวิธี hierarchical ที่พึ่งพาความสัมพันธ์ได้อย่างมาก
- Pipeline — อัลกอริทึม "house" แบบผสมของเรา: โครงสร้าง HRP พร้อม long/short overlay ที่ตัวเลือกได้ และข้อจำกัด CVaR (tail-risk) ผ่าน entry point
optimize()แบบ long-only สม่ำเสมอ มันทำงานเหมือน HRP; เครื่องจักร long/short และ tail-risk มีชีวิตขึ้นมาเมื่อคุณขับเคลื่อนด้วย signal ที่ชัดเจน เราวิเคราะห์มันอย่างละเอียดใน deep dive เฉพาะ: Inside Our House Algorithm: HRP + Long/Short + CVaR with Hull-White
เกิดอะไรขึ้นเมื่อคุณแข่งทั้งสิบสอง
นี่คือส่วนที่สนุก เราเล็งทั้งสิบสองตัวไปที่ ตะกร้าผสม โดยเจตนา — ผู้ชนะสามรายชัดเจน (ZEC, Tether Gold, 1000RATS) และผู้แพ้หนักสามราย (FLOW, KAVA, LINEA) — ในช่วง กันยายน 2025 ถึงกุมภาพันธ์ 2026 และให้แต่ละตัวจัดสรร
| อัลกอริทึม | ผลตอบแทนรายปี | Sharpe |
|---|---|---|
| RBA | +149% | — |
| MVO | +74% | 2.52 |
| Entropy Pooling | +57% | 1.93 |
| NCO | +44% | — |
| HERC | +30% | — |
| Black-Litterman | +7% | — |
| OLPS | −74% | — |
| MHRP | −78% | — |
| GHRP | −95% | — |
| HRP / Pipeline | −103% | −2.45 |
| TIC | −131% | — |
คำเตือนสำคัญก่อนที่คุณจะอ่านอะไรจากนี้: ตัวเลขเหล่านี้มาจาก หนึ่ง ตะกร้าในช่วง หนึ่ง ช่วงเวลา และตะกร้านั้นถูกออกแบบมาให้มีผู้ชนะและผู้แพ้ที่รุนแรงโดยเจตนา นี่ไม่ใช่การอ้างสิทธิ์ด้านผลการดำเนินงานและไม่ใช่คำแนะนำแน่นอน — มันคือการแสดงให้เห็น ความแตกต่างทางพฤติกรรม รันบนสินทรัพย์ของคุณเองและการจัดอันดับจะเรียงลำดับใหม่อย่างสมบูรณ์
แต่ รูปร่าง ของผลลัพธ์คือบทเรียน วิธีที่แสวงหาผลตอบแทน — MVO, RBA, Entropy Pooling, NCO — รวมเงินทุนเข้าไปในผู้ชนะและพิมพ์ผลตอบแทนบวกที่แข็งแกร่ง วิธี risk parity บริสุทธิ์ — HRP, TIC, MHRP, GHRP — กระจายน้ำหนักอย่างสม่ำเสมอเพื่อการกระจายความเสี่ยง ซึ่งหมายความว่าถือผู้แพ้ด้วย และติดลบ ไม่มีพฤติกรรมใดที่ "ผิด" Risk parity ถูกสร้างขึ้นเพื่อรอดเมื่อคุณ ไม่สามารถ บอกได้ล่วงหน้าว่าใครชนะหรือแพ้; บนตะกร้าที่อนาคตถูกออกแบบให้รู้ล่วงหน้า มันจ่ายราคาสำหรับความถ่อมตน ความตึงเครียดนั้น — การรวมศูนย์กับการกระจาย ความเชื่อมั่นกับความทนทาน — คือทั้งสาขาในหนึ่งตาราง
โอเพนซอร์สและไลฟ์
ทั้งหมดเป็น open: algorithm crate ของ Rust สิบสองตัวเป็น git submodules, Axum HTTP backend ที่ dispatch ทั้งหมด และ Next.js front end พร้อมกราฟ efficient-frontier แบบโต้ตอบและตารางเปรียบเทียบแบบเคียงข้างกัน คุณสามารถ:
- ลองไลฟ์ที่ portfolio-optimizer.marketmaker.cc — เลือกสินทรัพย์ ช่วงวันที่ และอัลกอริทึม แล้วดูน้ำหนักและ frontier อัปเดต
- เปิดแท็บ Compare Methods เพื่อรันทั้งสิบสองบนราคาที่เหมือนกันพร้อมกัน
- พึ่งพา crate เดียว (
portfolio-hrp,portfolio-nco, …) ในโปรเจกต์ Rust ของคุณเอง
สรุปสาระสำคัญ
- ไม่มี optimizer ที่ดีที่สุดแบบสากล การเลือกที่ถูกต้องขึ้นอยู่กับความมั่นใจในการประมาณผลตอบแทนของคุณมากแค่ไหน เชื่อพวกมัน → MVO/Black-Litterman ไม่เชื่อ → HRP และเพื่อน
- MVO เหมาะที่สุดและเปราะบาง มันกำหนด efficient frontier แต่เพิ่ม estimation error ให้สูงสุด ปฏิบัติต่อน้ำหนักของมันด้วยความสงสัย เว้นแต่ input ของคุณเชื่อถือได้จริง ๆ
- วิธี Hierarchical แลก peak performance กับความเสถียร พวกมันแทบไม่เคยเป็นอันดับหนึ่งใน backtest เดียว แต่แทบไม่เคยล้มเหลวอย่างรุนแรงเช่นกัน — ซึ่งนั่นคือสิ่งที่สำคัญจริง ๆ เมื่ออนาคตไม่ทราบ
- อินเทอร์เฟซสม่ำเสมอคือพลังพิเศษ เมื่อทุกอัลกอริทึมเป็น
prices -> weightsการเปรียบเทียบอย่างซื่อสัตย์ไม่มีค่าใช้จ่าย และการสลับเป็นอิสระ
วิธีที่ดีที่สุดในการเข้าใจสิบสองอัลกอริทึมคือการดูพวกมันโต้เถียงกัน ไป รันการเปรียบเทียบ บนสินทรัพย์ที่คุณสนใจจริง ๆ
อ้างอิง
- Markowitz, H. (1952). Portfolio Selection. The Journal of Finance.
- López de Prado, M. (2016). Building Diversified Portfolios that Outperform Out of Sample. The Journal of Portfolio Management.
- López de Prado, M. (2020). Machine Learning for Asset Managers. Cambridge University Press.
- Black, F., & Litterman, R. (1992). Global Portfolio Optimization. Financial Analysts Journal.
- Meucci, A. (2008). Fully Flexible Views: Theory and Practice. Risk.
- Marketmaker.cc: marketmaker.cc
การอ้างอิง
@article{soloviov2026portfoliooptimization,
  author = {Soloviov, Eugen and Zhuravleva, Marina and Kiselev, Kirill},
  title = {12 Portfolio Optimization Algorithms, Compared: HRP, Black-Litterman, NCO and Beyond},
  year = {2026},
  url = {https://marketmaker.cc/th/blog/post/portfolio-optimization-algorithms-compared},
  description = {ทัวร์อัลกอริทึมการจัดสรรพอร์ตโฟลิโอสิบสองตัว — MVO, กลุ่ม hierarchical (HRP, HERC, GHRP, MHRP), Black-Litterman, NCO, Entropy Pooling, OLPS, RBA, TIC และ pipeline แบบผสม — ผ่านอินเทอร์เฟซ Rust เดียว พร้อมการเปรียบเทียบแบบซื่อสัตย์เคียงข้างกันบนตะกร้าคริปโตผสม}
}