Один стакан, разные сделки: скрытое допущение в бэктесте
Есть особенно коварный вид честной ошибки в бэктесте. Все наблюдаемые данные одинаковы: цена, десять уровней стакана, сделки, объемы. Код детерминирован, сверка проходит. Но пассивная заявка в одном симуляторе успевает исполниться, а в другом - нет. Не потому, что кто-то подменил котировки, а потому, что L2 не хранит порядок отдельных ордеров внутри уровня. А FIFO-исполнение требует именно его.
Riya Danait, Yuliana Zamora и Ioana Boier называют это задачей частичной идентификации. По агрегированному пути стакана можно восстановить несколько market-by-order историй, одинаково согласованных с наблюдениями. Их работа не выбирает "правильную" очередь из воздуха. Она фиксирует все, что можно удержать постоянным, и меняет только ненаблюдаемое распределение отмен: спереди, случайно с весом по объему или сзади. На двух японских бумагах этого хватает, чтобы заметно изменить completion и implementation shortfall пассивной политики.
Парадокс полезен: один красивый результат на L2 может быть не оценкой стратегии, а оценкой выбранной по умолчанию фантазии о том, кто отменился перед вами.
L2 видит полку, FIFO требует знать, кто стоит на полке
На уровне L2 биржа публикует суммарный объем по цене. Если на лучшем биде было 1 000 акций, затем осталось 700, мы знаем уменьшение на 300. Но не знаем, ушли ли 300 заявок из головы очереди, из хвоста или несколькими кусками вокруг вашей виртуальной заявки. Сделка и отмена имеют разное значение: сделка в FIFO съедает голову, отмена может освободить место где угодно, если у нас нет идентификаторов.
Наивный симулятор часто поступает молча. Он вычитает отмены из объема перед заявкой, то есть фактически выбирает правило "front"; или, наоборот, считает, что отменяются прежде всего заявки позади. Оба правила могут давать тот же L2 path. Зато шанс нашего fill различается радикально. Особенно там, где отмен много, а очередь длинна: именно в таких местах пассивная стратегия любит рассказывать о своей терпеливости.
Авторы используют десятиуровневые L2 snapshots и L1 trades. Через reconciliation они выделяют market removals и resting side, затем собирают допустимые скрытые разбиения. Это не попытка сделать L2 равным L3. Это честная маркировка границы данных: агрегат наблюдаем, внутритиковая очередь - нет.
Front, random, back: три истории одного и того же стакана
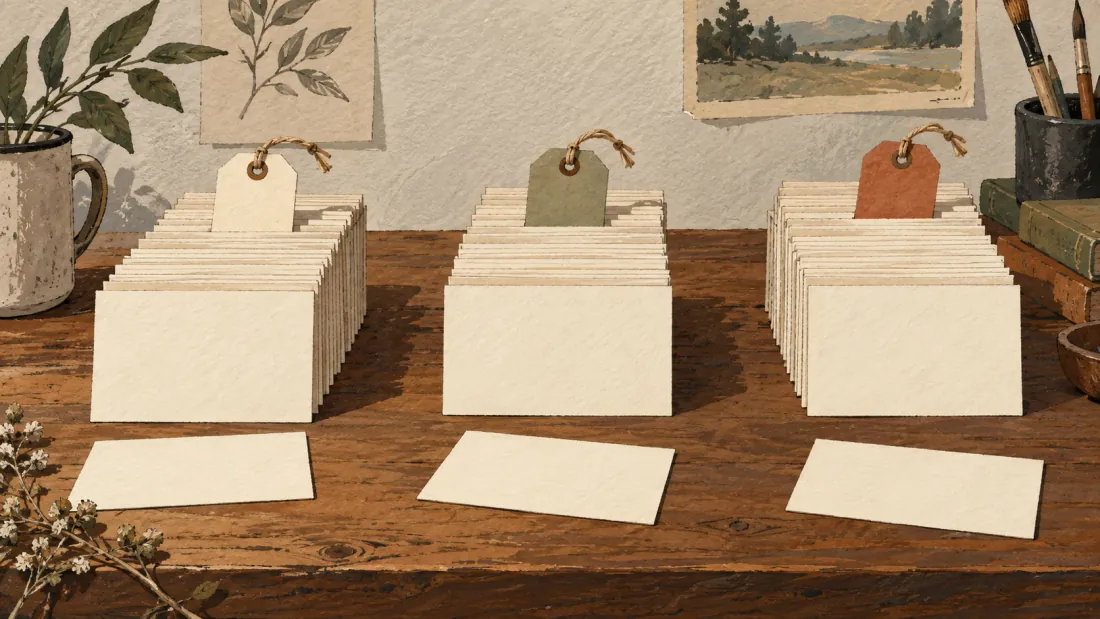
В path-preserving compiler сохраняются наблюдаемый путь, согласованные рыночные удаления, добавления и скрытые partitions. Меняется только отмена. Правило front убирает отмененный объем перед tagged order; back - после него; quantity-weighted random распределяет отмену случайно, взвешивая выбор по объему. Все три мира способны воспроизвести одинаковые L2-снимки.
При одном touch-price spell авторы доказывают порядок fill для tagged order: front дает верхнюю, back - нижнюю границу в их классе реконструкций. Это важнее, чем спор о том, какой rule "реалистичнее". Если данных недостаточно, правильный объект отчета - интервал результатов, а не одно число с двумя десятичными знаками. Последнее выглядит строго, но часто является декоративной бухгалтерией.
Случайная модель не становится истинной от слова random. Ее следует воспроизводимо seed-ить, запускать много раз и показывать распределение. А front/back полезны как stress bounds. Если политика убыточна уже на optimistic front, обсуждать тонкость оценки очереди не придется. Если прибыльна и на conservative back, это уже более содержательный сигнал.
Две японские бумаги: разница не растворилась в базисных пунктах
Исследование берет семь месяцев синхронизированных данных Tokyo Stock Exchange за 2025 год для 1301.T и 7911.T - инструментов с разной торговой активностью. Для каждой бумаги используются 1 080 совпадающих пяти минутных эпизодов на одних и тех же 18 отложенных торговых днях. Агрессивный benchmark инвариантен к FIFO-реконструкции: он берет ликвидность сейчас, поэтому тайная очередь его почти не интересует. Пассивный - нет.
Для 1301.T переход от back к front повышает preterminal completion на 8,01 процентного пункта и уменьшает implementation shortfall на 1,010 bps. Для 7911.T соответствующие величины - 7,39 процентного пункта и 0,384 bps. Это не обещание, что front всегда лучше на такую величину, и не оценка универсального edge. Это измеренный разброс двух допустимых реконструкций для конкретных данных и политики.
Именно здесь обычно хочется сказать "всего один базисный пункт". Для крупного исполнения это не всегда "всего"; для маленького - может быть меньше комиссии и шума. Важнее другое: completion сдвигается на несколько процентных пунктов. У schedule с жестким дедлайном недобор превращается в последующую агрессию, поэтому ошибка queue model может всплыть не там, где вы ее измеряли.
Чувствительность симулятора надо публиковать как риск модели
Минимальный отчет L2-бэктеста пассивной стратегии должен содержать не одну PnL-кривую, а таблицу чувствительности: front, quantity-weighted random с доверительным диапазоном и back; completion, shortfall, fill-time и долю forced aggressive completion. Добавьте срезы по времени дня, глубине, отменам и длительности нахождения на touch. Это не роскошь, а описание того, какой кусок результата идентифицирован данными, а какой - симулятором.
Генеративные модели не отменяют этот долг. FlowLOB, например, генерирует траектории L2 и заявляет контроль над liquidity и imbalance; авторы прямо называют выходом L2 states, пригодные для snapshot-based policies. Это удобно для stress testing, но модель состояния уровня все равно не наблюдает исходную FIFO-очередь. Убедительное сходство распределений объемов не превращается автоматически в верные fills для resting order.
Похожая осторожность нужна при реконструкции скрытых причин. Работа Goliath и Gebbie о synthetic metaorders из публичных данных показывает, что можно подобрать реконструкцию, воспроизводящую широкие aggregate impact facts, но это не является независимой валидацией Lillo-Mike-Farmer order splitting. Совместимость внутри класса реконструкций - не идентификация истины. Для очереди это почти буквальная мораль статьи Danait и соавторов.
Что делать на практике? Если есть market-by-order или собственные order acknowledgements, использовать их и валидировать replay на своих fills. Если есть только L2, строить диапазон, не точечную сказку. А если стратегия проходит только при конкретном front rule, стоит назвать это не альфой, а зависимостью от допущения. Рынок переживет такую честность. Ваш риск-комитет, вероятно, тоже.
Есть и более приземленная проверка. Возьмите собственные исторические passive orders, для которых известны точные acknowledgement, cancel и fill, и пропустите рядом с ними L2-replay. Не ждите совершенного совпадения: в реальности есть сетевые задержки, скрытая ликвидность, правила matching engine и собственная очередь. Но если симулятор систематически завышает fill в длинных очередях или слишком рано снимает объем перед заявкой, это уже наблюдаемая калибровочная ошибка, а не философская оговорка.
Важно не смешивать два вопроса. Первый: могла ли заявка быть исполнена при некоторой допустимой FIFO-истории? Второй: с какой вероятностью именно эта история была у биржи? Статья отвечает на первый, строя границы внутри явно заданного класса реконструкций. Для второго нужны дополнительные данные или отдельная поведенческая модель отмен. Она может быть полезна, но должна называться моделью, иметь out-of-sample проверку и не прятаться за словом "replay".
Проведите чувствительность и через логику стратегии. Если после неполного passive fill алгоритм догоняет рынок агрессивно, граница completion переходит в границу total cost. Если переносит объем, меняется риск позиции и сравнение с benchmark. Поэтому в отчете фиксируют deadline, replace/cancel, комиссии, тик, лимит участия и реакцию на частичное исполнение. Иначе один FIFO-assumption незаметно сравнивает разные стратегии, а не разные реконструкции одной стратегии.
Источники
- Riya Danait, Yuliana Zamora, Ioana Boier, "Same Book, Different Fills: Partial Identification of FIFO Execution from Aggregate Order Books", arXiv:2609.13597v2, 2026. Основной источник: compiler, front/random/back rules и результаты по 1301.T и 7911.T.
- "FlowLOB: Efficient and Controllable Limit Order Book Generation with Flow Matching", arXiv:2608.13096v1, 2026. Использован только для границы применимости L2 trajectory generators.
- Ezra Goliath, Tim Gebbie, "Metaorder modelling and identification from public data", arXiv:2608.30999v1, 2026. Использован только как аналогия ограничений реконструкции скрытой структуры из публичных агрегатов.
Авторы
Инженер торговых систем
Разработка торговых ботов с 2017 года: межбиржевой арбитраж (подключал до 30 бирж), парный арбитраж на коинтеграции между спотом и фьючерсами, скальпинг, фронтраннинг, торговля по новостям, сентиментный анализ, трендовые алгоритмы, а также алгоритмы управления и балансировки портфелей. Делает выставление ордеров до 1 мс, warehouse для big data, бэктестинг-движки, AI-агентов и интерфейсы для ботов (в т.ч. open-source profitmaker.cc). Стек: JS/TS, Python, Rust/Zig/Go, DevOps, backend, frontend, архитектура.
Читайте также
Внутри слайса: тактика дочерних ордеров между планировщиком и биржей

Кривые проскальзывания вместо констант: модели издержек, которые выживают при столкновении с реальной торговлей