Backtest-Live-Parität: warum dein Bot anders handelt als im Backtest
Vollständige Taxonomie der Abweichungen zwischen Backtesting und Live-Trading: von Slippage und Teilausführungen bis zur Desynchronisierung der Codebasis. Architekturmuster zur Erreichung von Parität, Python-Beispiele für ein gemeinsames Core-Modul und eine Checkliste für Produktions-Monitoring.
Du hast eine Strategie durch einen Backtest laufen lassen. Sharpe 2,1, MaxDD -8 %, PnL +67 %. Du hast den Bot gestartet. Einen Monat später vergleichst du: gleiche Signale, gleicher Zeitraum — aber der Live-PnL ist 40 % niedriger. Der Drawdown ist anderthalbmal tiefer. Zwei von zehn Trades wurden gar nicht ausgeführt.
Das ist kein Bug. Das ist Backtest-Live-Divergenz — eine systematische Diskrepanz zwischen Backtest-Ergebnissen und echtem Trading. Jeder hat sie. Die einzige Frage ist, ob du davon weißt und ob du sie kontrollieren kannst.
Dieser Artikel bietet eine vollständige Taxonomie der Divergenzen, Architekturmuster zu ihrer Minimierung und eine praktische Checkliste zur Überwachung der Parität in der Produktion.
Das "es hat im Backtest funktioniert"-Syndrom
Jeder Algotrader durchläuft diesen Kreislauf:
- Strategie in einem Jupyter-Notebook geschrieben
- Backtest auf historischen CSV-Daten durchgeführt — die Ergebnisse sind großartig
- Die Logik als Bot neu geschrieben (oft in einer anderen Sprache oder einem anderen Framework)
- Gestartet — die Ergebnisse stimmen nicht überein
- Nach einem Bug gesucht, keinen gefunden — "der Markt hat sich verändert"
Das Problem ist nicht der Markt. Das Problem ist, dass der Backtest und der Bot zwei unterschiedliche Softwareprodukte sind, die dieselbe Realität unterschiedlich modellieren. Divergenzen sind unvermeidlich, aber sie lassen sich systematisieren und minimieren.
Taxonomie der Divergenzen
Alle Divergenzquellen fallen in vier Kategorien. Für jede — eine Schweregrad-Bewertung (von 1 bis 5) und ein typischer Beitrag zur PnL-Divergenz.
1. Daten-Divergenzen (Schweregrad: 3/5)
Die Daten, die der Backtest sieht, und die Daten, die der Bot in Echtzeit sieht, sind nicht dasselbe.
Zeitstempel. Börsen liefern Candles mit unterschiedlichen Regeln für die Zeitstempel-Zuordnung. Eine Börse markiert die Candle mit dem Beginn der Periode, eine andere mit dem Ende. Eine REST-API kann eine Candle mit 1-3 Sekunden Verzögerung nach dem tatsächlichen Schluss zurückgeben. Der Backtest arbeitet mit "idealen" Zeitstempeln aus der historischen Datei.
OHLCV-Aggregation. Historische Daten werden vom Anbieter oft anders aggregiert, als die Börse es in Echtzeit tut. Der Unterschied liegt in der letzten Stelle — aber bei Schwellenwertsignalen (MA-Crossover, Level-Breakout) entscheidet das darüber, ob die Strategie eine Position eingeht oder nicht.
Lücken und fehlende Daten. Historische Daten sind meist sauber — fehlende Candles werden durch Interpolation gefüllt. In Echtzeit kann ein WebSocket abbrechen, und der Bot verpasst 30 Sekunden an Daten.
Typischer Beitrag zur PnL-Divergenz: 2-5 % des jährlichen PnL.
2. Ausführungs-Divergenzen (Schweregrad: 5/5)
Die gefährlichste Klasse von Divergenzen. Der Backtest simuliert die Ausführung perfekt — die Realität ist weit davon entfernt, ideal zu sein.
Slippage. Der Backtest füllt die Order zum Schlusskurs (oder zum Signalkurs). In der Realität wird eine Market-Order zum besten Bid/Ask plus Slippage ausgeführt, die von Volumen und Liquidität abhängt. Für eine 10.000-$-Position bei einem Altcoin mit mittlerer Liquidität kann die Slippage 0,05-0,3 % betragen.
Formel für kumulierte Slippage über Trades:
wobei die Slippage des -ten Trades ist, abhängig von der Orderbuchtiefe:
Latenz. Vom Moment der Signalgenerierung bis zur Orderausführung vergeht Zeit: Signalberechnung (1-50 ms), Übertragung der Anfrage (10-200 ms), Matching an der Börse (1-10 ms). Im Backtest ist Latenz = 0. Im Live-Betrieb kann sich der Preis bewegen.
Teilausführungen. Der Backtest geht davon aus, dass 100 % der Order sofort ausgeführt werden. In der Realität kann eine Limit-Order teilweise ausgeführt werden — oder gar nicht, wenn sich der Preis umkehrt. Bei einer Market-Order in einem illiquiden Markt "rutscht" die Order durch mehrere Orderbuch-Levels.
Queue-Priorität. Eine Limit-Order, die zum besten Bid-Preis platziert wird, wird nicht sofort ausgeführt — sie reiht sich hinter allen zuvor auf diesem Level platzierten Orders ein. Ein Backtest, der "Preis berührt = Order ausgeführt" annimmt, überschätzt systematisch die Fill-Rate.
Typischer Beitrag zur PnL-Divergenz: 10-30 % des jährlichen PnL.
3. Logik-Divergenzen (Schweregrad: 4/5)
Das sind Divergenzen im Strategiecode selbst zwischen Backtest und Bot.
Getrennte Codebasen. Das klassische Anti-Pattern: backtests/strategy_a.py und bot/strategy_a.py — zwei separate Dateien, die "dasselbe tun". Nach drei Monaten Änderungen driften sie unweigerlich auseinander. Jemand hat im Backtest einen Filter hinzugefügt und vergessen, ihn im Bot zu replizieren. Oder umgekehrt — ein Bug wurde im Bot behoben, blieb aber im Backtest bestehen.
Unterschiedliche Frameworks. Backtest auf pandas mit vektorisierten Operationen, Bot auf asyncio mit ereignisgesteuerter Logik. Selbst bei identischer Strategie werden Grenzfälle unterschiedlich behandelt: Rundung, Reihenfolge der Bedingungsprüfungen, Umgang mit NaN.
Zustandsverwaltung. Der Backtest ist in der Regel zustandslos — er iteriert über ein Datenarray. Der Bot ist zustandsbehaftet — er speichert Positionen, Kontostände, Orderhistorie. Bot-Neustart, Zustandsverlust, Desynchronisierung mit der Börse — all das sind Divergenzquellen.
Typischer Beitrag zur PnL-Divergenz: 5-20 % des jährlichen PnL.
4. Kosten-Divergenzen (Schweregrad: 3/5)
Divergenzen bei der Modellierung der Handelskosten.
Funding Rates. Die meisten Backtests von Perpetual Futures berücksichtigen Funding Rates überhaupt nicht. Bei 10-fachem Hebel und einer durchschnittlichen Rate von 0,01 % pro 8 Stunden ergibt das pro Jahr — mehr als der PnL der meisten Strategien. Eine detaillierte Analyse findet sich im Artikel Funding Rates fressen deinen Hebel.
Kommissionen. Maker/Taker-Kommissionen werden in der Regel modelliert, oft aber mit dem falschen Satz. VIP-Stufen, BNB-Rabatte, Rebates — all das beeinflusst das Endergebnis.
Spread. Ein candle-basierter Backtest sieht den Bid-Ask-Spread nicht. Bei einer 1-Minuten-Candle beträgt der Schlusskurs 3000, aber in der Realität ist bid = 2999,5 und ask = 3000,5. Jeder Trade "kostet" die Hälfte des Spreads.
Typischer Beitrag zur PnL-Divergenz: 5-15 % des jährlichen PnL.
Kumulativer Effekt
Alle vier Kategorien wirken gleichzeitig und in der Regel in eine Richtung — gegen den Trader:
Eine Gesamtdivergenz von 20-50 % vom Backtest-PnL ist für ein unausgereiftes System normal. Mit Hebel wird der Effekt vervielfacht.
Architekturmuster für Parität
Muster 1: Shared Core (Extraktion eines gemeinsamen Kerns)
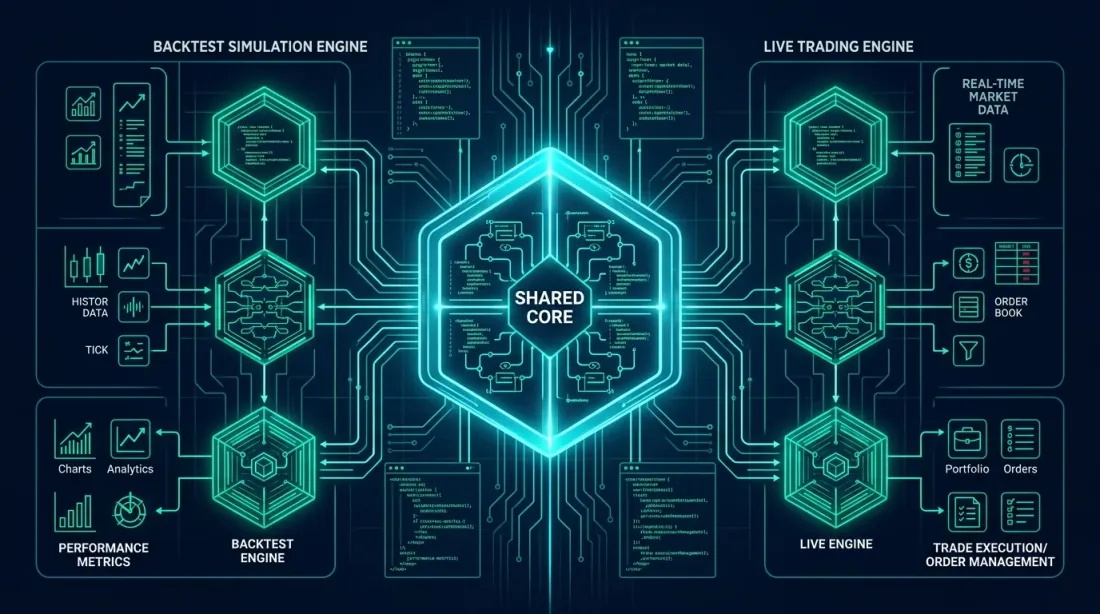
Die Idee: den Strategiekern — Signalgenerierung und Ausführungslogik — in ein separates Modul auszulagern, das sowohl vom Backtest als auch vom Bot verwendet wird. Nur die umgebende Infrastruktur unterscheidet sich: die Datenquelle und der Mechanismus zur Ordereinreichung.
┌─────────────────────────────────────┐
│         strategy_core.py            │
│  ┌─────────────┐ ┌───────────────┐  │
│  │ SignalEngine │ │ OrderManager  │  │
│  └──────┬──────┘ └──────┬────────┘  │
│         │               │           │
│    generate_signal()  create_order()│
└─────────┬───────────────┬───────────┘
          │               │
    ┌─────┴─────┐   ┌─────┴──────┐
    │ Backtest   │   │ Live       │
    │ DataFeed   │   │ DataFeed   │
    │ FillModel  │   │ Exchange   │
    └────────────┘   └────────────┘
# strategy_core.py — shared core

from dataclasses import dataclass
from typing import Optional
import numpy as np

@dataclass
class Signal:
    side: str          # 'long' | 'short'
    entry_price: float
    sl_price: float
    tp_price: float
    size: float
    timestamp: int

@dataclass
class OrderRequest:
    side: str
    order_type: str    # 'market' | 'limit'
    price: float
    size: float

class StrategyCore:
    """
    Strategy core. Identical code for backtest and live.
    Depends only on data, not on infrastructure.
    """
    def __init__(self, params: dict):
        self.fast_period = params.get('fast_ma', 20)
        self.slow_period = params.get('slow_ma', 50)
        self.sl_pct = params.get('sl_pct', 0.02)
        self.tp_pct = params.get('tp_pct', 0.04)
        self.position: Optional[Signal] = None
        self._closes: list[float] = []

    def on_candle(self, timestamp: int, o: float, h: float,
                  l: float, c: float, v: float) -> Optional[OrderRequest]:
        """
        Process a new candle. Returns an OrderRequest or None.
        This method is called identically from the backtest and the bot.
        """
        self._closes.append(c)

        if len(self._closes) < self.slow_period:
            return None

        fast_ma = np.mean(self._closes[-self.fast_period:])
        slow_ma = np.mean(self._closes[-self.slow_period:])

        # Check exit
        if self.position is not None:
            exit_order = self._check_exit(h, l, c)
            if exit_order:
                self.position = None
                return exit_order

        # Check entry
        if self.position is None:
            if fast_ma > slow_ma and self._prev_fast_ma <= self._prev_slow_ma:
                self.position = Signal(
                    side='long', entry_price=c,
                    sl_price=c * (1 - self.sl_pct),
                    tp_price=c * (1 + self.tp_pct),
                    size=1.0, timestamp=timestamp,
                )
                return OrderRequest('buy', 'market', c, 1.0)

        self._prev_fast_ma = fast_ma
        self._prev_slow_ma = slow_ma
        return None

    def _check_exit(self, high: float, low: float,
                    close: float) -> Optional[OrderRequest]:
        pos = self.position
        if pos.side == 'long':
            if low <= pos.sl_price:
                return OrderRequest('sell', 'market', pos.sl_price, pos.size)
            if high >= pos.tp_price:
                return OrderRequest('sell', 'market', pos.tp_price, pos.size)
        return None
Jetzt verwenden Backtest und Bot dieselbe StrategyCore:
# backtest_runner.py

from strategy_core import StrategyCore

def run_backtest(candles, params, fill_model):
    core = StrategyCore(params)
    trades = []

    for candle in candles:
        order = core.on_candle(
            candle['timestamp'], candle['open'], candle['high'],
            candle['low'], candle['close'], candle['volume'],
        )
        if order:
            fill_price = fill_model.simulate_fill(order, candle)
            trades.append({'price': fill_price, 'side': order.side})

    return trades
# live_runner.py

from strategy_core import StrategyCore

async def run_live(exchange, symbol, params):
    core = StrategyCore(params)

    async for candle in exchange.stream_candles(symbol, '1m'):
        order = core.on_candle(
            candle['timestamp'], candle['open'], candle['high'],
            candle['low'], candle['close'], candle['volume'],
        )
        if order:
            await exchange.place_order(symbol, order.side,
                                       order.order_type, order.size)
Die Kernregel: StrategyCore weiß nicht, woher die Daten kommen oder wohin die Orders gesendet werden. Sie erhält OHLCV und gibt eine OrderRequest zurück. Alles andere liegt in der Verantwortung der Infrastrukturschicht.
Muster 2: Event-driven Vereinheitlichung (NautilusTrader-Ansatz)
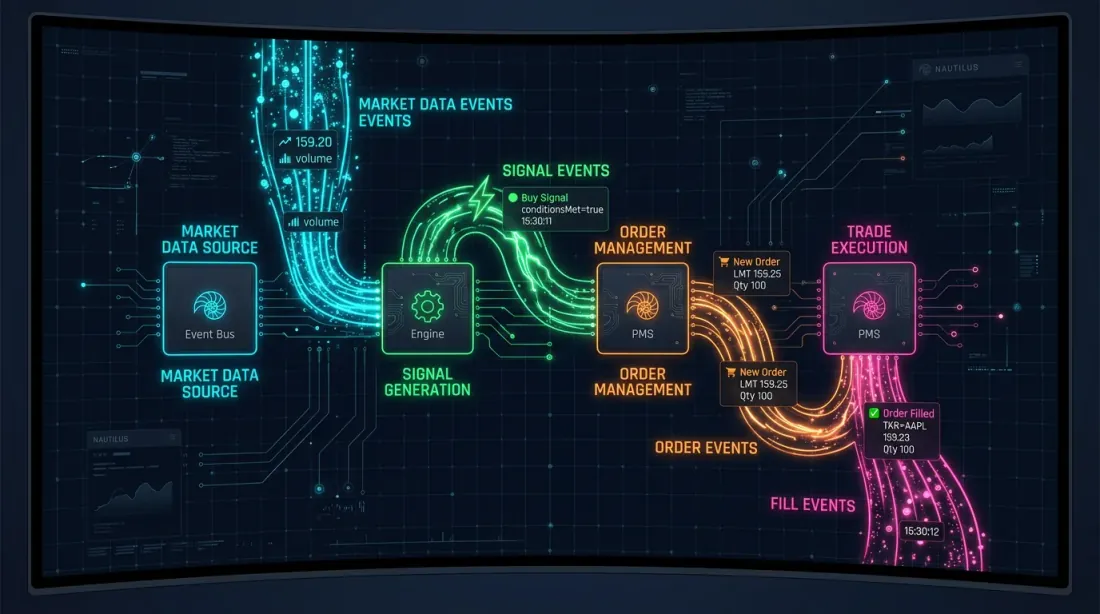
NautilusTrader implementiert Parität durch einen einheitlichen NautilusKernel — eine Rust-native Engine mit einem deterministischen, ereignisgesteuerten Kern und Nanosekunden-Auflösung. Dieselbe Strategieimplementierung funktioniert sowohl im Backtest als auch im Live-Trading.
Die Architektur basiert auf dem Ports-and-Adapters-Muster (hexagonale Architektur):
┌──────────────────────────────────┐
│        NautilusKernel            │
│  ┌───────────┐  ┌─────────────┐  │
│  │ Strategy   │  │ RiskEngine  │  │
│  │ (Python)   │  │ (Rust)      │  │
│  └─────┬─────┘  └──────┬──────┘  │
│        │               │         │
│  ┌─────┴───────────────┴──────┐  │
│  │      Message Bus (Rust)    │  │
│  └─────┬───────────────┬──────┘  │
└────────┼───────────────┼─────────┘
         │               │
   ┌─────┴─────┐   ┌─────┴──────┐
   │ Backtest   │   │ Live       │
   │ Adapter    │   │ Adapter    │
   │ FillModel  │   │ Exchange   │
   │ (L2 book)  │   │ Gateway    │
   └────────────┘   └────────────┘
Vorteile:
- Deterministischer Replay. Events werden in strikt definierter Reihenfolge verarbeitet — das Backtest-Ergebnis ist bit-genau reproduzierbar.
- Custom FillModel. L2-Orderbuch-Simulation für jede Ausführung — Slippage wird basierend auf realer Orderbuchtiefe simuliert.
- Performance. Bis zu 5 Millionen Zeilen/Sek., Verarbeitung von Daten, die nicht in den RAM passen.
- Redis + PostgreSQL. Cache und Message Bus über Redis, Persistenz über PostgreSQL — identische Infrastruktur für Backtest und Live.
Muster 3: Strategy Interface (Freqtrade-Ansatz)
Freqtrade verwendet ein einheitliches IStrategy-Interface: Dieselbe Strategieklasse funktioniert sowohl im Backtest als auch im Live-Betrieb. Der einzige Unterschied ist die Persistenzschicht.
# IStrategy example (Freqtrade-style)

class IStrategy:
    """Unified interface — the implementation does not know if this is a backtest or live."""

    def populate_indicators(self, dataframe, metadata):
        """Compute indicators."""
        dataframe['fast_ma'] = dataframe['close'].rolling(20).mean()
        dataframe['slow_ma'] = dataframe['close'].rolling(50).mean()
        return dataframe

    def populate_entry_trend(self, dataframe, metadata):
        """Determine entry signals."""
        dataframe.loc[
            (dataframe['fast_ma'] > dataframe['slow_ma']) &
            (dataframe['fast_ma'].shift(1) <= dataframe['slow_ma'].shift(1)),
            'enter_long'
        ] = 1
        return dataframe

    def populate_exit_trend(self, dataframe, metadata):
        """Determine exit signals."""
        dataframe.loc[
            (dataframe['fast_ma'] < dataframe['slow_ma']),
            'exit_long'
        ] = 1
        return dataframe
Freqtrade bietet zusätzlich:
- Hyperopt via Optuna — Optimierung der Strategieparameter
--timeframe-detail— Drill-down zu einem feineren Zeitrahmen für die Verfeinerung der Fills (ähnlich wie adaptives Drill-down)
Vergleich der Muster
| Shared Core | Event-driven (NautilusTrader) | Strategy Interface (Freqtrade) | |
|---|---|---|---|
| Implementierungskomplexität | Niedrig | Hoch | Mittel |
| Paritätsniveau | Mittel | Maximal | Hoch |
| Fill-Simulation | Separates FillModel | L2-Orderbuch | --timeframe-detail |
| Kern-Sprache | Python | Rust + Python | Python |
| Geeignet für | Custom Engines | Institutionelles Trading | Schneller Einstieg |
Genauigkeit der Fill-Simulation
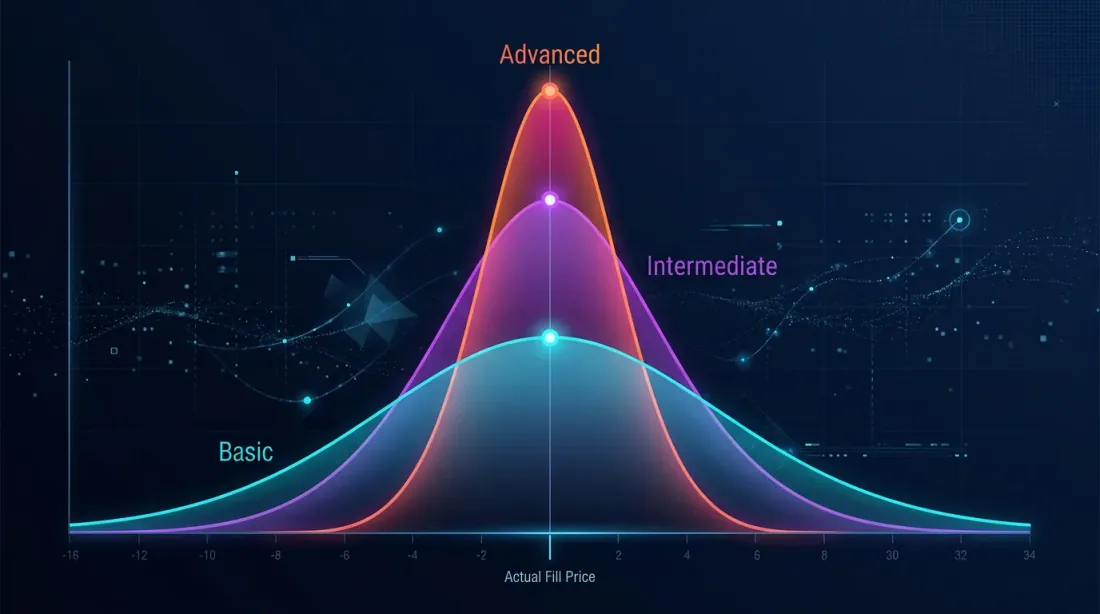
Die Fill-Simulation ist die Hauptquelle der Ausführungsdivergenz. Drei Genauigkeitsstufen:
Stufe 1: Naiv (Fill zum Schlusskurs)
fill_price = candle['close']
Fehler: berücksichtigt weder Slippage noch Spread noch Teilausführungen. Überschätzt den PnL systematisch.
Stufe 2: Slippage-Modell
def simulate_fill(order, candle, slippage_bps=5):
    """Fill with slippage."""
    base_price = candle['close']
    slip = base_price * slippage_bps / 10000

    if order.side == 'buy':
        return base_price + slip  # Buy at a higher price
    else:
        return base_price - slip  # Sell at a lower price
Fehler: eine feste Slippage berücksichtigt weder Liquidität noch Ordergröße. Besser als naiv, aber immer noch ein grobes Modell.
Stufe 3: Adaptives Drill-down mit 1s/100ms-Daten
Die beste Option: reale, feingranulare Daten für die präzise Bestimmung der SL/TP-Fill-Reihenfolge verwenden. Ausführlich beschrieben im Artikel Adaptives Drill-down: Backtesting mit variabler Granularität.
class RealisticFillModel:
    """
    Combined fill model: slippage + spread + volume impact.
    """
    def __init__(self, avg_spread_bps=3, impact_coeff=0.1):
        self.avg_spread_bps = avg_spread_bps
        self.impact_coeff = impact_coeff

    def simulate_fill(self, order, candle, order_size_usd):
        base_price = candle['close']

        # 1. Half-spread cost
        spread_cost = base_price * self.avg_spread_bps / 20000

        # 2. Market impact (depends on order size and candle volume)
        candle_volume_usd = candle['volume'] * candle['close']
        participation_rate = order_size_usd / max(candle_volume_usd, 1)
        impact = base_price * self.impact_coeff * np.sqrt(participation_rate)

        # 3. Final price
        if order.side == 'buy':
            return base_price + spread_cost + impact
        else:
            return base_price - spread_cost - impact
Formel für Market Impact (vereinfachtes Almgren-Chriss-Modell):
wobei die Volatilität ist, der Impact-Koeffizient, das Ordervolumen und das Marktvolumen für den Zeitraum.
Praktische Paritäts-Checkliste
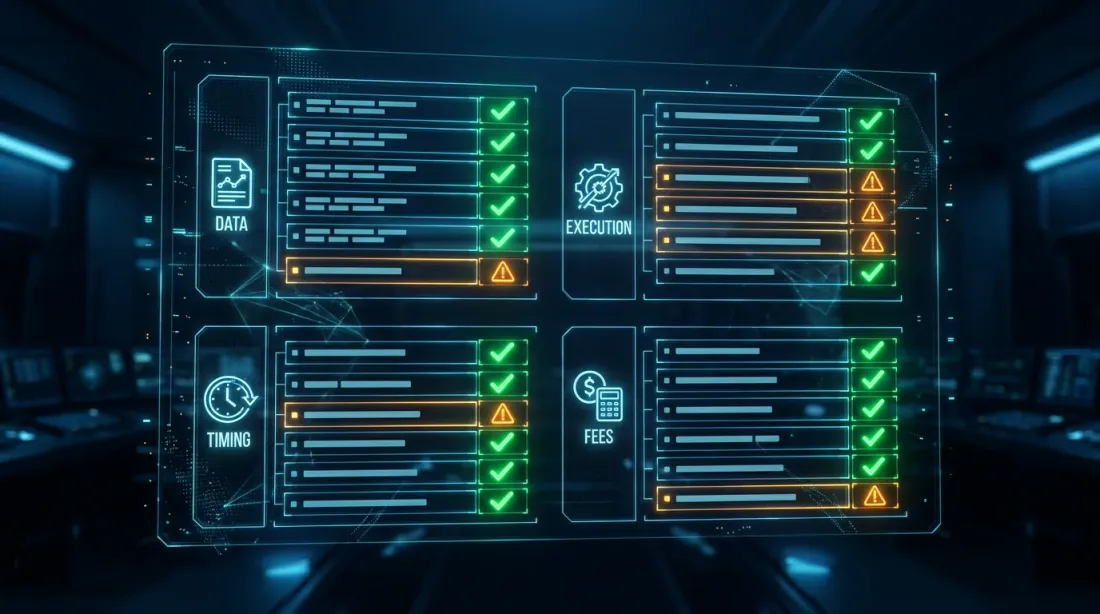
Vor dem Live-Start des Bots jeden Punkt prüfen:
Code:
- Die Strategie verwendet einen Shared Core (ein Modul für Backtest und Live)
- Keine Duplizierung der Signallogik an zwei Stellen
- Unit-Tests verifizieren identische Kern-Ausgaben bei identischen Eingaben
- Die Reihenfolge der Bedingungsprüfungen ist identisch (SL vor TP? TP vor SL?)
Daten:
- Das Zeitstempelformat ist identisch (UTC, gleicher Anbieter)
- Die OHLCV-Aggregation verwendet dieselben Regeln
- Der Umgang mit fehlenden Candles ist identisch
- Kein Look-ahead-Bias — der Backtest schaut nicht in die Zukunft
Ausführung:
- Das Slippage-Modell ist auf realen Daten kalibriert
- Teilausführungen werden modelliert (oder zumindest pessimistisch geschätzt)
- Limit-Orders haben ein Queue-Prioritäts-Modell
- Latenz wird berücksichtigt (100-500 ms Verzögerung vom Signal bis zum Fill)
Kosten:
- Maker/Taker-Kommissionen sind mit dem aktuellen Satz enthalten
- Funding Rates werden bei Perpetual Futures berücksichtigt
- Der Spread wird modelliert (zumindest der Durchschnitt)
Infrastruktur:
- Zustandspersistenz: der Bot stellt Positionen nach einem Neustart wieder her
- Reconnection-Logik: WebSocket verbindet sich ohne Datenverlust neu
- Logging: alle Orders und Fills werden für die Post-Mortem-Analyse protokolliert
Divergenz-Monitoring in der Produktion
Parität ist keine einmalige Prüfung, sondern ein kontinuierlicher Prozess. Nach dem Start des Bots müssen Divergenzen in Echtzeit verfolgt werden.
Shadow Mode (Paper Trading)
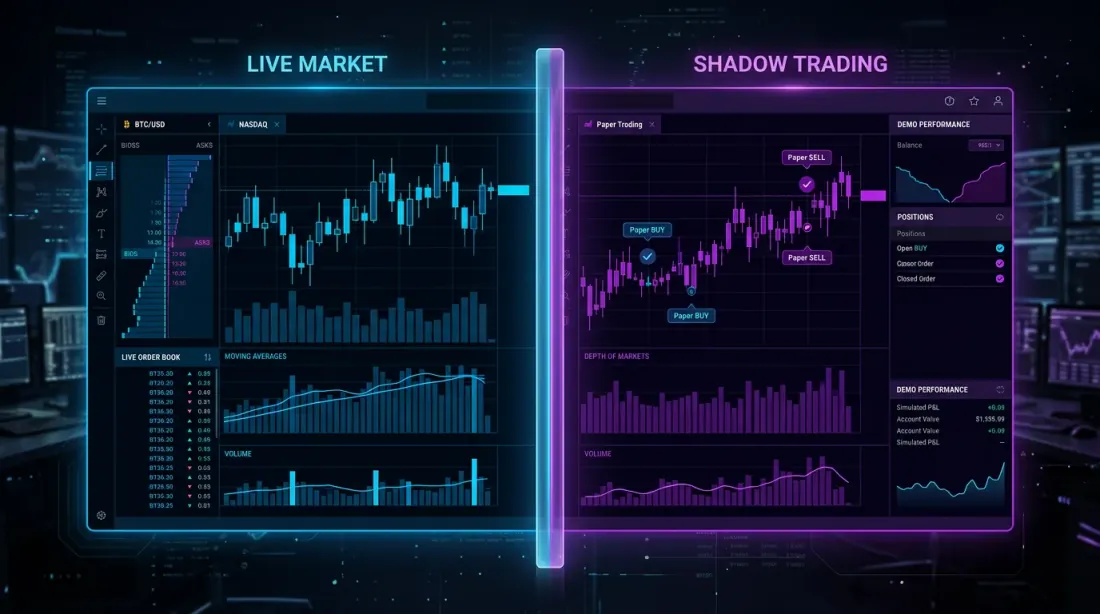
Den Bot parallel zum Backtest auf denselben Daten laufen lassen. Der Bot generiert Signale, sendet aber keine Orders — er protokolliert sie nur. Gleichzeitig verarbeitet der Backtest dieselben Daten. Vergleichen:
class DivergenceMonitor:
    """
    Compares backtest and live bot signals in real time.
    """
    def __init__(self, tolerance_pct=0.5):
        self.tolerance = tolerance_pct / 100
        self.divergences = []

    def compare_signal(self, backtest_signal, live_signal, timestamp):
        """Compare backtest and live signals."""
        if backtest_signal is None and live_signal is None:
            return  # Both silent — OK

        if (backtest_signal is None) != (live_signal is None):
            self.divergences.append({
                'timestamp': timestamp,
                'type': 'signal_mismatch',
                'backtest': backtest_signal,
                'live': live_signal,
                'severity': 'HIGH',
            })
            return

        # Both generated a signal — compare prices
        price_diff = abs(
            backtest_signal.entry_price - live_signal.entry_price
        ) / backtest_signal.entry_price

        if price_diff > self.tolerance:
            self.divergences.append({
                'timestamp': timestamp,
                'type': 'price_divergence',
                'diff_pct': price_diff * 100,
                'severity': 'MEDIUM',
            })

    def compare_fill(self, backtest_fill, live_fill, timestamp):
        """Compare execution."""
        if backtest_fill and live_fill:
            slippage = (live_fill['price'] - backtest_fill['price']
                        ) / backtest_fill['price']
            self.divergences.append({
                'timestamp': timestamp,
                'type': 'fill_divergence',
                'slippage_bps': slippage * 10000,
                'severity': 'LOW' if abs(slippage) < 0.001 else 'MEDIUM',
            })

    def report(self):
        """Weekly divergence report."""
        from collections import Counter
        severity_counts = Counter(d['severity'] for d in self.divergences)
        return {
            'total_divergences': len(self.divergences),
            'by_severity': dict(severity_counts),
            'avg_slippage_bps': np.mean([
                d['slippage_bps'] for d in self.divergences
                if d['type'] == 'fill_divergence'
            ]) if any(d['type'] == 'fill_divergence'
                      for d in self.divergences) else 0,
        }
Dashboard-Metriken
| Metrik | Formel | Alarmschwelle |
|---|---|---|
| Signal-Übereinstimmungsrate | < 95 % | |
| Durchschnittliche Slippage | (bps) | > 10 bps |
| Fill-Rate | < 90 % | |
| PnL-Divergenz | > 20 % | |
| Latenz p99 | 99. Perzentil Signal-zu-Fill | > 500 ms |
Kalibrierung des Slippage-Modells
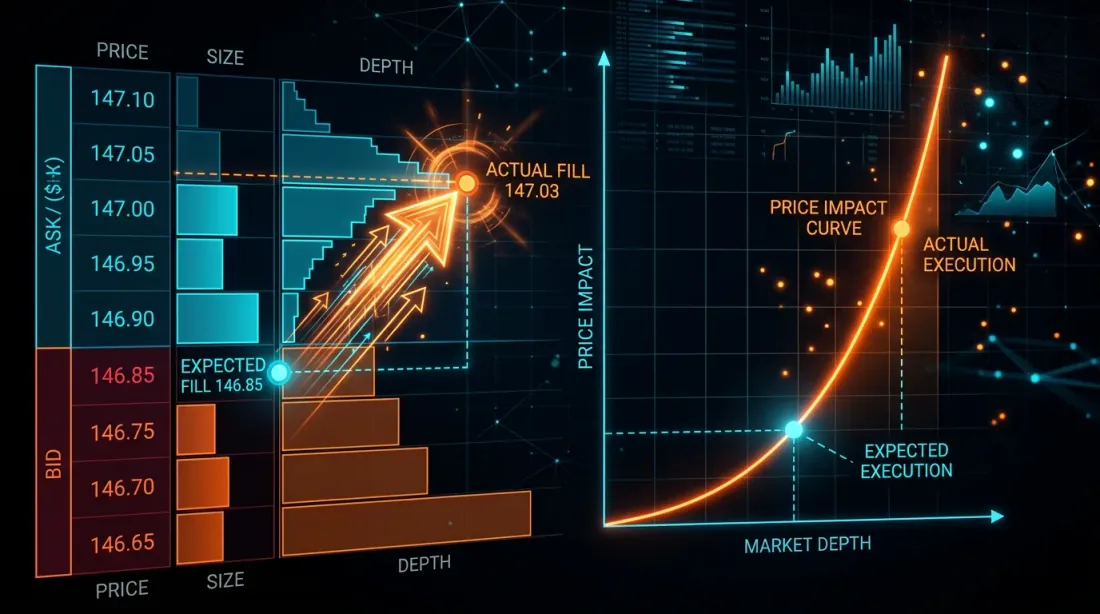
Nach 2-4 Wochen Datensammlung kannst du das Slippage-Modell des Backtests anhand realer Daten kalibrieren:
def calibrate_slippage(live_fills: list[dict]) -> dict:
    """
    Calibrate slippage model using real fills.

    live_fills: [{'expected_price': ..., 'actual_price': ..., 'size_usd': ..., 'volume_usd': ...}]
    """
    slippages = []
    participation_rates = []

    for fill in live_fills:
        slip = abs(fill['actual_price'] - fill['expected_price']
                   ) / fill['expected_price']
        part = fill['size_usd'] / max(fill['volume_usd'], 1)
        slippages.append(slip)
        participation_rates.append(part)

    slippages = np.array(slippages)
    participation_rates = np.array(participation_rates)

    # Fit: slippage = k * sqrt(participation_rate) + base
    from scipy.optimize import curve_fit

    def model(x, k, base):
        return k * np.sqrt(x) + base

    popt, _ = curve_fit(model, participation_rates, slippages,
                        p0=[0.1, 0.0001])

    return {
        'impact_coeff': popt[0],
        'base_slippage': popt[1],
        'mean_slippage_bps': np.mean(slippages) * 10000,
        'p95_slippage_bps': np.percentile(slippages, 95) * 10000,
    }
Verbindungen zu anderen Tools
Backtest-Live-Parität ist keine isolierte Aufgabe. Sie überschneidet sich mit anderen Tools aus der Serie "Backtests ohne Illusionen":
- Adaptives Drill-down — verbessert die Genauigkeit der Fill-Simulation, eine Schlüsselkomponente der Ausführungsparität.
- Funding Rates — wenn der Backtest kein Funding modelliert, ist Parität bei Hebel > 3x unmöglich.
- Parquet-Cache — vorberechnete Zeitrahmen und Indikatoren stellen sicher, dass der Backtest dieselben Daten sieht wie der Bot. RunningCandleBuffer-Emulation = Echtzeit-Aktualisierung.
- Polars vs Pandas — beim Wechsel von pandas (Backtest) zu Polars (Live) muss sichergestellt werden, dass die numerischen Ergebnisse übereinstimmen.
- Walk-Forward — Walk-Forward auf Out-of-Sample-Daten zeigt, wie die Strategie degradiert — das kommt dem Live-Betrieb näher als ein In-Sample-Backtest.
Empfehlungen
-
Shared Core ist Pflicht. Eine einzige Codebasis für die Signalgenerierung ist die Mindestanforderung für Parität. Zwei Dateien mit identischer Logik garantieren Divergenz innerhalb eines Monats.
-
Das Fill-Modell kalibrieren. Eine feste Slippage von 5 bps ist besser als nichts. Ein an realen Daten kalibriertes Slippage-Modell ist deutlich besser.
-
Shadow Mode für die ersten 2-4 Wochen nutzen. Nicht mit echtem Geld handeln, bis die Signal-Übereinstimmungsrate 95 %+ erreicht.
-
Funding Rates modellieren. Bei Perpetual Futures ist das nicht optional — es ist Pflicht. Funding kann bei Hebel > 5x den gesamten PnL auffressen.
-
Alles loggen. Jedes Signal, jede Order, jeder Fill — mit Zeitstempeln. Ohne Logs ist eine Post-Mortem-Analyse unmöglich.
-
Den Vergleich automatisieren. Ein wöchentlicher DivergenceMonitor-Report sollte automatisch eintreffen. Nicht warten, bis der PnL negativ wird.
-
Standardmäßig pessimistischer Backtest. Es ist besser, die Erwartungen im Backtest zu unterschätzen und im Live-Betrieb positiv überrascht zu werden, als umgekehrt. Das Slippage-Modell sollte konservativ sein.
Fazit
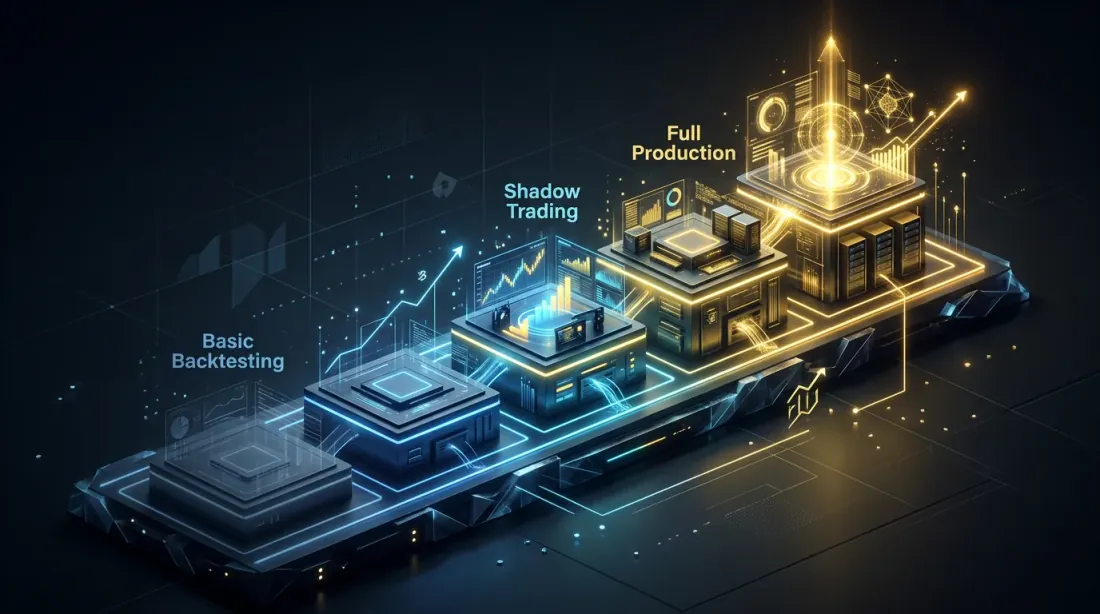
Backtest-Live-Parität ist keine Eigenschaft eines Systems, sondern ein Prozess. Perfekte Parität existiert nicht: Ein Backtest ist per Definition ein Modell der Realität, und ein Modell vereinfacht immer. Aber der Unterschied zwischen "das Modell weicht um 5 % ab" und "das Modell weicht um 50 % ab" wird durch die Architektur bestimmt.
Drei Reifegrade:
- Basis. Shared Core, feste Slippage, Kommissionen. Divergenz: 10-20 %.
- Fortgeschritten. Event-getriebene Architektur, adaptives Drill-down, Funding-Modell, Shadow Mode. Divergenz: 5-10 %.
- Institutionell. L2-Orderbuch-Simulation, kalibriertes Impact-Modell, Echtzeit-Divergenz-Monitoring. Divergenz: 2-5 %.
Deine Aufgabe ist es, herauszufinden, auf welchem Niveau du dich befindest, und zu verstehen, welche Divergenz du für deine Positionsgröße und deinen Hebel als akzeptabel ansiehst.
Nützliche Links
- NautilusTrader — High-Performance Algorithmic Trading Platform
- Freqtrade — Free, open source crypto trading bot
- Almgren, R., Chriss, N. — Optimal Execution of Portfolio Transactions (2001)
- Lopez de Prado — Advances in Financial Machine Learning, Chapter 12: Backtesting
- Ernest Chan — Quantitative Trading: How to Build Your Own Algorithmic Trading Business
- Hexagonal Architecture (Ports and Adapters) — Alistair Cockburn
- Optuna — Hyperparameter Optimization Framework
Zitation
@article{soloviov2026backtestliveparity,
  author = {Soloviov, Eugen},
  title = {Backtest-live parity: why your bot trades differently from the backtest},
  year = {2026},
  url = {https://marketmaker.cc/ru/blog/post/backtest-live-parity},
  description = {Complete taxonomy of divergences between backtesting and live trading: from slippage and partial fills to codebase desynchronization. Architectural patterns for achieving parity and a production monitoring checklist.}
}


