用于多时间跨度组合预测的时序融合 Transformer
谷歌的时序融合 Transformer 如何为量化组合管理带来可解释的多时间跨度预测:基于注意力的变量选择、分位数输出,以及一条完整的 pytorch-forecasting 实战流程。
把深度学习应用到组合管理上,最让人头疼的就是黑盒问题。你训练出一个神经网络,它在回测里跑出了亮眼的夏普比率,但当策略上线后开始亏钱时,你完全不知道为什么。是哪些输入特征驱动了预测?哪些时间跨度才是关键?模型反应的是宏观信号,还是微观结构噪声?
谷歌研究院直接针对这个问题给出了答案——时序融合 Transformer(Temporal Fusion Transformer,TFT),这是一种基于注意力的架构,在提供强劲多时间跨度预测能力的同时,通过注意力权重和变量重要性得分内置了可解释性。在原始基准测试中,TFT 相比次优模型平均将分位数损失降低了 7%(P50)和 9%(P90),并在各测试数据集上相比最强竞争基线提升了 3% 至 26%。对量化组合经理来说,TFT 提供了一种难得的东西:一个既强大又透明的模型。
本文将拆解 TFT 架构,展示如何把它用于多时间跨度组合预测,借助 pytorch-forecasting 走一遍 Python 实现,并将其与 LSTM 和原始 Transformer 基线进行对比。
为什么多时间跨度预测对组合很重要
传统的单步预测只预测 时刻的一个值。但组合配置决策是同时跨多个时间跨度运作的。组合经理需要知道:
- 1 天跨度:用于日内再平衡和风险管理
- 1 周跨度:用于战术配置调整
- 1 个月跨度:用于战略配置和行业轮动
- 1 个季度跨度:用于宏观驱动的仓位布局
每个跨度都有不同的信噪比特性。短期收益由微观结构和订单流主导。中期收益对动量和均值回归作出反应。长期收益则由基本面和宏观体制驱动。
一个能同时在所有这些跨度上给出预测的模型——并在每个跨度上给出预测不确定性的分位数估计——从根本上就比为每个跨度单独建模更有用。这正是 TFT 所提供的:给定一段过去观测的编码器窗口,它会输出一组面向 步之后的分位数预测。
形式化地说,给定一个多元时间序列,其中实体 在时刻 的观测为 , 是目标, 是随时间变化的特征, 是静态元数据,TFT 学习的是:
其中 是分位数(从而支持概率性预测), 是回看窗口, 是预测跨度。
TFT 架构:完整堆栈
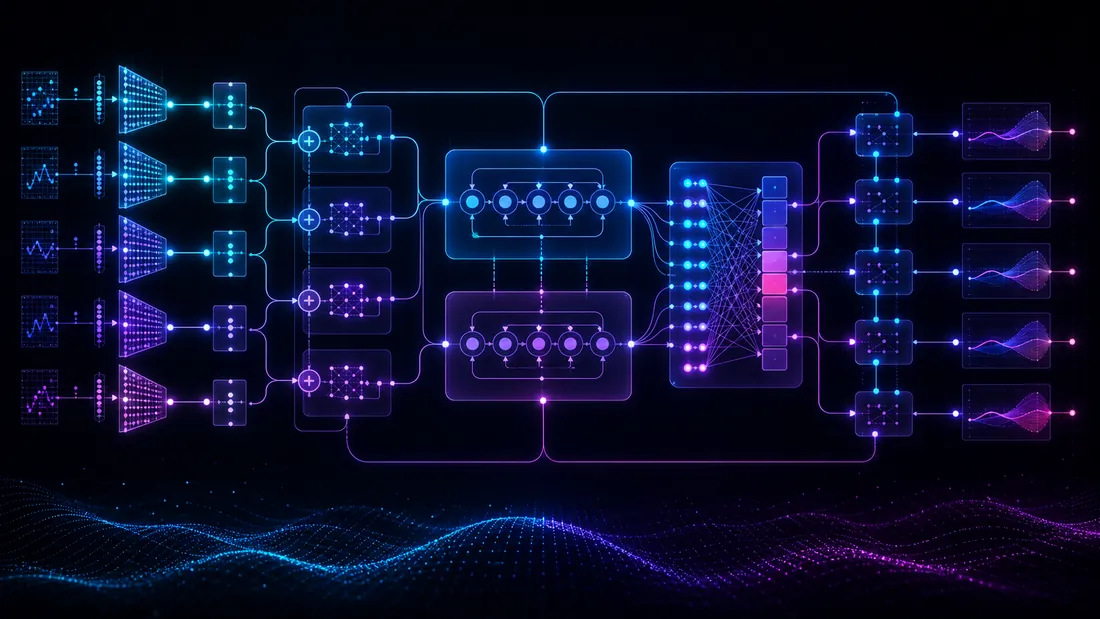
TFT 不是把一个通用 Transformer 硬套到时间序列上。它是一个专门构建的架构,包含五个专用组件,每个都针对时序预测中的某个具体难题。
1. 门控残差网络(GRN)
GRN 是 TFT 的基本构件,在架构中凡是需要非线性处理的地方都会用到。与标准前馈层不同,GRN 引入了跳跃连接和门控机制,使网络能够自适应地控制信息流。
给定主输入 和一个可选的上下文向量 ,GRN 计算:
其中:
门控线性单元(GLU)是关键的门控机制:
其中 是 sigmoid 函数, 表示逐元素相乘。sigmoid 门会学习抑制输入的哪些维度,从而在数据不需要时让模型完全跳过不必要的非线性处理。这对金融数据尤为关键,因为某些特征只在特定体制下才具有信息量。
2. 变量选择网络(VSN)
对组合类应用而言,这可以说是最有价值的组件。金融数据集出了名地嘈杂,潜在特征多达数十个——技术指标、基本面比率、宏观变量、情绪评分——其中许多在任意给定时刻都是冗余或无关的。
VSN 计算所有输入特征上的软选择权重:
其中 是时刻 所有经变换的输入特征展平后的向量, 是由静态元数据导出的上下文向量。每个单独的特征还会经过它自己的 GRN 处理:
最终被选中的表示是加权和:
在组合语境下, 直接告诉你:"在时刻 ,模型给特征 赋予了这么大的权重。"你可能会发现 RSI 在震荡市中占主导,而宏观收益率曲线特征在体制切换时占主导。这不是事后的解释——它是被烤进架构里的。
针对静态协变量、过去已观测的输入以及已知的未来输入,分别有各自独立的 VSN。这种分离尊重了预测问题的因果结构:你不能使用未来的观测,但你可以使用已知的未来事件(财报日期、FOMC 会议、期权到期、星期效应)。
3. 静态协变量编码器
在组合预测中,静态协变量代表不随时间变化的实体级元数据:资产类别、行业、交易所、市值分桶或地理区域。TFT 通过专用 GRN 处理这些数据,生成四个不同的上下文向量:
- —— 用于时序变量选择的上下文
- —— 用于对时序特征做静态富集的上下文(在 LSTM 之后应用)
- —— LSTM 的细胞状态初始化
- —— LSTM 的隐藏状态初始化
这就是 TFT 处理横截面信息的方式。当为一个含 500 只股票的组合做预测时,静态编码器让模型能够学到科技股和公用事业股具有从根本上不同的时序动态,而无需为它们分别建模。
4. 时序处理:LSTM + 可解释多头注意力
TFT 使用一条两阶段的时序处理流程,结合了循环架构与基于注意力架构各自的优势。
阶段 1:用 LSTM 做局部处理
一个序列到序列的 LSTM 编码器-解码器处理时间序列,以捕捉局部时序模式——短期动量、均值回归和自回归结构。编码器处理回看窗口;解码器处理已知的未来输入。两者都用静态上下文向量 (细胞状态)和 (隐藏状态)来初始化。
阶段 2:用可解释多头注意力捕捉长程依赖
在局部处理之后,TFT 应用一种改良的自注意力机制来学习长程依赖。关键的改动在于注意力头的聚合方式。标准多头注意力会拼接各头的输出:
TFT 则在各头之间共享值并对注意力权重取平均:
注意: 没有头的上标——所有头共享同一个值投影。这意味着每个头的注意力权重可以被有意义地平均,并被解释为时序重要性得分。对于某一次预测,你可以精确地可视化出模型关注的是哪些过去的时间步,以及不同头之间的注意力模式有何差异。
对组合预测而言,这能揭示模型究竟是在关注近期价格走势(动量)、久远的历史模式(季节性),还是特定的日历事件。每个头都可以专精于一种不同的时序模式。
5. 分位数输出层
最后一层输出多个分位数上的预测,用分位数损失进行优化:
其中 是目标分位数的集合(例如 )。这不仅给你一个点预测,还在每个跨度上给出预测区间的分位数估计。对组合风险管理而言,第 10 和第 90 百分位的预测可以为仓位规模和止损水平提供依据。
有一点值得开门见山地指出:最小化弹球损失(pinball loss)得到的是条件分位数估计,但它并不保证样本外覆盖率经过校准。在非平稳、体制切换的市场上,这些区间常常校准不良——名义上的 80% 区间,实际覆盖的实现值可能远少于(或多于)80%。请把这些分位数当作有待用覆盖率/可靠性检验来实证验证的估计,如果你需要覆盖率保证,就用保形预测(conformal prediction)来收紧它们。我们会在生产环节那一节再回到这一点。
TFT vs LSTM vs 原始 Transformer
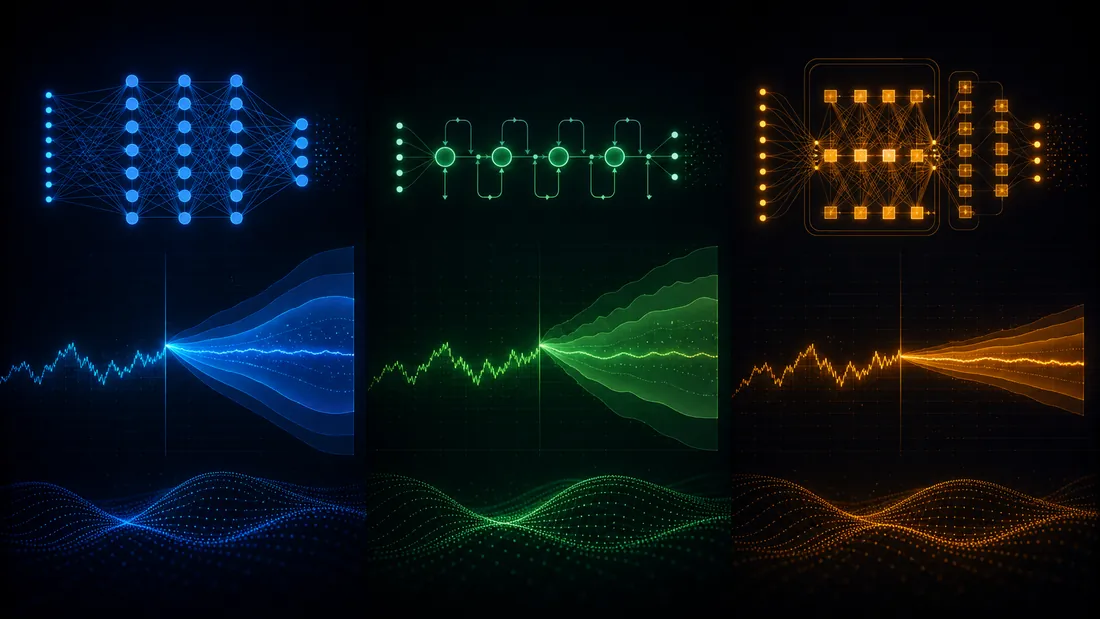
理解 TFT 相对于其他架构所处的位置,有助于决定何时该用它。
| 特性 | LSTM | 原始 Transformer | TFT |
|---|---|---|---|
| 长程依赖 | 有限(梯度消失) | 强(自注意力) | 强(LSTM + 注意力) |
| 变量选择 | 无(手工特征工程) | 无 | 内置 VSN |
| 可解释性 | 不透明 | 注意力权重(含噪) | 结构化注意力 + 变量重要性 |
| 静态协变量 | 临时拼接 | 临时拼接 | 专用编码流程 |
| 多时间跨度输出 | 自回归(误差累积) | 直接或自回归(取决于解码方式) | 直接(并行) |
| 已知未来输入 | 处理别扭 | 无原生区分 | 显式输入分离 |
| 概率性输出 | 需要改造 | 需要改造 | 原生分位数回归 |
| 训练稳定性 | 中等 | 在小数据上常不稳定 | 稳定(门控有帮助) |
LSTM 仍占上风的场景
在回看窗口很短、局部自回归结构占主导的极短期预测(逐笔级、亚分钟级)中,LSTM 仍然有竞争力。它们部署起来也更简单,推理延迟更低。对于一个需要亚毫秒级预测的做市机器人来说,LSTM 仍然是务实的选择。
原始 Transformer 力有不逮的场景
把标准 Transformer 不加改造地套到金融时间序列上,往往会过拟合。它们缺乏时序数据所需的归纳偏置——没有静态特征与时变特征的概念,没有变量选择,而且标准的拼接式多头注意力产生的注意力图很难做出有意义的解释。
TFT 大放异彩的场景
当你具备以下条件时,TFT 是最优选择:(1)有多种异质的输入类型,(2)有横截面数据(许多资产),(3)需要多时间跨度的概率性预测,以及(4)有模型可解释性的要求。这基本上描述了每一个机构级的组合预测问题。
用 PyTorch Forecasting 做 Python 实现
下面是一个用 pytorch-forecasting 库为多资产组合收益预测做 TFT 的实战实现。
数据准备
注意我们有意使用了真正的已知未来输入——day_of_week、days_to_earnings、is_fomc、days_to_expiry。这些是我们在预测窗口内提前就知道的值,把它们作为已知实数/类别量喂进去,正是这套架构所围绕构建的那种 TFT 能力。我们从已知实数中剔除了原始的 time_idx:add_relative_time_idx=True 已经注入了一个相对位置索引,而一个原始的单调递增计数器多半会泄露趋势。
import pandas as pd
import numpy as np
import lightning.pytorch as pl
from lightning.pytorch.callbacks import EarlyStopping, LearningRateMonitor
from lightning.pytorch.loggers import TensorBoardLogger

from pytorch_forecasting import (
    TimeSeriesDataSet,
    TemporalFusionTransformer,
    QuantileLoss,
    GroupNormalizer,
)

# --- 假设 `df` 是一个 DataFrame,包含以下列: ---
# asset_id: str(例如 "AAPL"、"MSFT")
# date: datetime
# time_idx: int(顺序时间索引)
# log_return: float(目标)
# rsi_14, macd, bb_width: float(技术指标)
# pe_ratio, earnings_yield: float(基本面特征)
# vix, yield_spread, dxy: float(宏观特征)
# day_of_week: str(已知未来类别量:"Mon".."Fri")
# is_fomc: str(已知未来类别量:FOMC 决议日为 "0"/"1")
# days_to_earnings: float(已知未来实数:距下次财报的交易日数)
# days_to_expiry: float(已知未来实数:距下次期权到期的交易日数)
# sector: str(静态类别量)
# market_cap_bucket: str(静态类别量 —— "large"、"mid"、"small")

# 定义预测问题
max_encoder_length = 60   # 回看 60 个交易日(约 3 个月)
max_prediction_length = 20 # 向前预测 20 个交易日(约 1 个月)

# 创建训练截断点
training_cutoff = df["time_idx"].max() - max_prediction_length

# 构建 TimeSeriesDataSet
training = TimeSeriesDataSet(
    df[lambda x: x.time_idx <= training_cutoff],
    time_idx="time_idx",
    target="log_return",
    group_ids=["asset_id"],
    min_encoder_length=max_encoder_length // 2,
    max_encoder_length=max_encoder_length,
    min_prediction_length=1,
    max_prediction_length=max_prediction_length,

    # 静态类别特征(实体级元数据)
    static_categoricals=["sector", "market_cap_bucket"],

    # 已知未来输入:我们在预测窗口内提前就知道的值
    time_varying_known_categoricals=["day_of_week", "is_fomc"],
    time_varying_known_reals=["days_to_earnings", "days_to_expiry"],

    # 只在当前之前已知的时变特征
    time_varying_unknown_reals=[
        "log_return",
        "rsi_14",
        "macd",
        "bb_width",
        "pe_ratio",
        "earnings_yield",
        "vix",
        "yield_spread",
        "dxy",
    ],

    target_normalizer=GroupNormalizer(
        groups=["asset_id"],
        transformation="softplus",
    ),
    add_relative_time_idx=True,
    add_target_scales=True,
    add_encoder_length=True,
)

# 创建验证集
validation = TimeSeriesDataSet.from_dataset(
    training, df, predict=True, stop_randomization=True
)

# DataLoaders
batch_size = 64
train_dataloader = training.to_dataloader(
    train=True, batch_size=batch_size, num_workers=4
)
val_dataloader = validation.to_dataloader(
    train=False, batch_size=batch_size * 4, num_workers=4
)
模型定义与训练
# 配置 TFT 模型
tft = TemporalFusionTransformer.from_dataset(
    training,
    learning_rate=1e-3,
    hidden_size=64,
    attention_head_size=4,
    dropout=0.1,
    hidden_continuous_size=32,
    output_size=7,  # 7 个分位数
    loss=QuantileLoss(quantiles=[0.02, 0.1, 0.25, 0.5, 0.75, 0.9, 0.98]),
    log_interval=10,
    optimizer="Ranger",
    reduce_on_plateau_patience=4,
)

print(f"Number of parameters: {tft.size() / 1e3:.1f}k")

# 训练
early_stop_callback = EarlyStopping(
    monitor="val_loss",
    min_delta=1e-4,
    patience=10,
    verbose=False,
    mode="min",
)

lr_logger = LearningRateMonitor()
logger = TensorBoardLogger("lightning_logs")

trainer = pl.Trainer(
    max_epochs=100,
    accelerator="auto",
    enable_model_summary=True,
    gradient_clip_val=0.1,
    callbacks=[lr_logger, early_stop_callback],
    logger=logger,
)

trainer.fit(
    tft,
    train_dataloaders=train_dataloader,
    val_dataloaders=val_dataloader,
)
提取可解释输出
可解释性调用有一个不太显眼的要求:interpret_output() 消费的是原始输出字典(带有 encoder_variables、decoder_variables、static_variables、encoder_attention 等键),而 predict() 只有在 mode="raw" 下才会产出它。算一次,然后把同一个对象复用于变量重要性和注意力两件事。
# 加载最佳模型
best_model_path = trainer.checkpoint_callback.best_model_path
best_tft = TemporalFusionTransformer.load_from_checkpoint(best_model_path)

# 原始预测携带了 interpret_output() 所需的那些字典。
raw_predictions, x = best_tft.predict(val_dataloader, mode="raw", return_x=True)

# --- 变量重要性 + 注意力(单个解释对象) ---
interpretation = best_tft.interpret_output(raw_predictions, reduction="sum")

# 绘制变量重要性(编码器/解码器/静态)和注意力。
best_tft.plot_interpretation(interpretation)
# 变量重要性显示模型给哪些特征赋予了最大权重:
#   例如 vix: 0.23, yield_spread: 0.18, rsi_14: 0.15, ...
# interpretation["attention"] 显示模型关注的是哪些过去的时间步,
#   揭示出回看模式 —— 在 t-1、t-5、t-21 处的强注意力表明
#   模型已经学到了日、周、月级别的结构。

# --- 带预测区间的逐资产预测 ---
# raw_predictions.output["prediction"] 的形状为:
#   (batch, prediction_length, n_quantiles)
# 分位数 0.1 和 0.9 给出 80% 预测区间;0.5 是中位数。
preds = raw_predictions.output["prediction"]
从预测到组合权重
def forecasts_to_portfolio_weights(
    predictions: dict,
    index: pd.DataFrame,
    risk_aversion: float = 2.0,
) -> pd.DataFrame:
    """
    用一个均值-方差-启发式(mean-variance-INSPIRED)的得分,把 TFT 的多时间跨度
    分位数预测转换为只做多的组合权重(这不是完整优化:这里没有协方差矩阵,
    只有一个逐资产的风险调整得分)。

    用中位数预测作为期望收益,用 (q90 - q10) 作为预测不确定性的代理。
    """
    # 提取分位数预测(形状:batch x horizon x quantiles)
    preds = predictions["prediction"]

    # 分位数索引:[0.02, 0.1, 0.25, 0.5, 0.75, 0.9, 0.98]
    median_return = preds[:, :, 3].mean(dim=1).numpy()  # 跨各跨度取平均
    q90 = preds[:, :, 5].mean(dim=1).numpy()
    q10 = preds[:, :, 1].mean(dim=1).numpy()
    forecast_uncertainty = q90 - q10  # 80% 预测区间的宽度

    # 风险调整得分:期望收益越高、不确定性越低越好
    scores = median_return / (risk_aversion * forecast_uncertainty + 1e-8)

    # 构建带资产映射的 DataFrame
    result = index[["asset_id"]].copy()
    result["score"] = scores
    result["raw_weight"] = np.maximum(scores, 0)  # 只做多

    # 在横截面上归一化,使权重之和为 1。
    # 注意:这里假设只有一个预测日期。对于多个日期,请带上一个
    # `date` 列,并使用 result.groupby("date")["raw_weight"].transform("sum")。
    total = result["raw_weight"].sum()
    result["weight"] = result["raw_weight"] / (total + 1e-8)

    return result[["asset_id", "weight", "score"]]
实践中的可解释性:TFT 揭示了市场的什么
TFT 的可解释性输出并不是学术上的猎奇——它们为组合经理提供了可付诸行动的情报。
跨体制的变量重要性
当你观察变量选择权重随时间的变化时,会浮现出一些与市场直觉相符的模式:
- 在 2022 年加息周期中:收益率曲线特征(yield_spread、fed_funds_rate)主导了变量重要性,占到选择权重的 35% 至 40%。技术指标则跌到 10% 以下。
- 在 2024 年由 AI 驱动的上涨中:动量特征(rsi_14、macd)的重要性飙升。由于这轮上涨高度集中于科技板块,行业级的静态协变量也变得显著。
- 在区间震荡期:均值回归指标(bb_width、relative_value)获得最高权重,而趋势跟踪特征则被门控机制压制。
这就是 GRN 门控在发挥作用。当动量特征不携带任何信号时,GLU 门会把它们的贡献推向零,模型便自动转向其他特征。(这些是来自探索性实验的示意性模式,并非经过基准测试的结果——请在你自己的数据上验证。)
时序注意力模式
注意力权重的可视化揭示了模型有效的记忆结构:
- 短期注意力峰值:在滞后 1 至 5 处的强注意力反映了自相关以及短期动量/反转效应。
- 周度模式:在滞后 5、10、15 处的注意力尖峰对应于周度日历效应。
- 月度模式:在滞后 21(一个交易月)附近一个稳定的注意力峰值,捕捉到了月度再平衡资金流和期权到期效应。
- 财报周期:对单只股票而言,注意力在约 63 天和 126 天滞后处显示出尖锐的尖峰,对应于季度财报日期。
这些模式提供了独立的佐证,表明模型学到的是有意义的时序结构,而不是在拟合噪声。
真实世界的表现与应用
基准结果
来自原始论文和后续研究,TFT 展现出强劲且有据可查的表现:
- 在论文的基准数据集(电力、交通、零售、波动率)上,相比次优模型,平均 P50 分位数损失降低 7%、P90 分位数损失降低 9%,并视数据集而定,相比最强竞争基线提升 3% 至 26%。具体的竞争对手因数据集而异——例如 DeepAR 在电力和交通上属于较弱的基线,但在零售和波动率上更具竞争力——所以那个标题性的数字是相对于次优模型的增益,而不是相对于某个固定基线。
- 在多时间跨度指标上始终优于经典的 ARIMA、ETS 和 Prophet 基线。
金融领域的研究方向
TFT 催生了一条活跃的金融专项研究线。这里列出几条有代表性的脉络,并附上它们实际报告的指标(在依赖其中任何一项之前,请引用并复现):
- **面向加密货币的自适应/多尺度 TFT。**诸如 Adaptive Temporal Fusion Transformers for Cryptocurrency Price Prediction(arXiv:2509.10542)之类的工作,报告在加密货币价格预测上相比固定长度的 TFT 和 LSTM 基线有所改进。请把其中的交易盈利能力数字当作论文特定、依赖体制的结果,而非普适结论——我们在此有意不引用一个绝对的夏普增量,因为文献里到处流传的那些数字常常把预测准确率与已实现夏普混为一谈。
- **夏普感知的目标函数。**MDPI Sensors 上那条"多传感器 TFT / 自适应夏普比率"的研究线,直接朝着夏普式的目标进行优化;请注意,它那个标题性的结果大致是夏普比率预测准确率提升约 18%,这与绝对夏普的提升是不同的量。
- **混合 TFT-GNN 模型。**将 TFT 与图神经网络结合以捕捉资产间依赖,据报道这类混合模型在横截面股票预测上优于单独的 TFT。
- **跨模态时序融合。**通过 Transformer 融合层将结构化价格数据与非结构化数据(新闻、财报电话会记录)整合起来,把 TFT 范式扩展到多模态金融数据。
这些方向都是真实存在的,但没有一个是即插即用的优势。在部署之前,请在你自己的标的池和成本下复现这些指标。
投产的实务考量
数据要求:TFT 需要大量训练数据。请计划每只资产至少有 2 至 3 年的日度数据,或 6 至 12 个月的小时级数据。横截面数据(许多资产)帮助很大——同时在 500 只股票上训练,比训练 500 个独立模型更有效。
特征工程:尽管 TFT 会自动进行变量选择,候选特征的质量仍然重要。请纳入一组涵盖技术、基本面、宏观和另类数据的多样化特征集。让 VSN 去判定什么有用。
计算成本:TFT 训练起来比 LSTM 更昂贵,但与原始 Transformer 相当。在单块 A100 GPU 上,用 3 年日度数据在 500 只股票上训练 100 个 epoch,量级在几个小时左右。推理很快——为整个标的池生成预测远在一秒以内。
**校准要验证,不要想当然。**在任何分位数被用来驱动仓位规模之前,请在样本外数据上检查经验覆盖率:名义上的 80% 区间是否真的包含了约 80% 的已实现收益?在非平稳市场上,它常常做不到。请逐跨度绘制可靠性图,并考虑用保形预测把模型包起来,以恢复覆盖率保证。
体制适应:TFT 不像 HMM 那样显式建模体制切换。然而,门控机制提供了隐式的体制适应。在实践中,用扩展窗口按月重训能有效地捕捉结构性变化。
过拟合缓解:金融数据嘈杂且非平稳。请使用激进的正则化:0.1 至 0.3 的 dropout、在 0.1 处做梯度裁剪、以 10 至 15 个 epoch 的耐心做早停。前向滚动(walk-forward)验证必不可少——绝不要在时间序列上使用随机的训练/测试划分。
把这一切串起来:一条基于 TFT 的组合流程
一条用于基于 TFT 的组合管理的生产流程长这样:
- 数据接入:每日采集 OHLCV、基本面、宏观和另类数据。计算特征(200 多个候选),包括一份真正的已知未来日历(财报、FOMC、到期、星期)。
- 特征库:维护一个归一化、按时间索引的特征库。处理缺失数据、公司行为(corporate actions)和幸存者偏差。
- 模型训练:用前向滚动方法按月重训 TFT。以扩展窗口使用最近 3 至 5 年的数据。
- 预测生成:每日推理,为整个资产池在 1、5、10、20 天跨度上生成分位数预测。
- 校准检查:逐跨度跟踪每个分位数区间的覆盖率。当覆盖率漂移时,重新校准(或应用保形调整)。
- 可解释性看板:可视化变量重要性和注意力权重。标记异常(例如特征重要性的突然变化)。
- 组合优化:用均值-方差、Black-Litterman 或风险平价把预测转换为权重,其中 TFT 分位数提供收益与不确定性输入。
- 风险叠加层:用第 2 和第 98 百分位的预测做尾部风险评估。当预测区间变宽时,缩小仓位规模。
- 执行:把目标权重传给执行引擎。监控目标组合与已实现组合之间的跟踪误差。
结论
时序融合 Transformer 代表了量化组合管理的一次真正进步。它不只是又一个被随意扔向金融数据的深度学习模型——它是一个从头开始、针对多时间跨度时序预测的具体挑战而设计的架构:异质输入、横截面结构、概率性输出,以及对可解释性的关键需求。
变量选择网络告诉你模型在关注什么。注意力权重告诉你它在何时观察。门控机制确保它优雅地处理无关特征和体制变化。而分位数输出为风险管理提供了不确定性估计——前提是你去验证它们的校准,而不是凭信仰接受。
TFT 不是万灵药。金融市场依然是对抗性环境,任何预测优势都是暂时的、依赖体制的。但 TFT 提供了一个有原则的框架,用以构建既强大又可理解的预测系统——而在生产交易中,理解你的模型为什么下这个注,与下注本身同样重要。
参考文献
- Lim, B., Arik, S.O., Loeff, N., & Pfister, T. (2021). "Temporal Fusion Transformers for Interpretable Multi-horizon Time Series Forecasting." International Journal of Forecasting, 37(4), 1748-1764. arXiv:1912.09363
- Oreshkin, B.N., Carpov, D., Chapados, N., & Bengio, Y. (2020). "N-BEATS: Neural basis expansion analysis for interpretable time series forecasting." ICLR 2020.
- Salinas, D., Flunkert, V., Gasthaus, J., & Januschowski, T. (2020). "DeepAR: Probabilistic forecasting with autoregressive recurrent networks." International Journal of Forecasting, 36(3), 1181-1191.
- pytorch-forecasting documentation —— 基于 PyTorch Lightning 的 TFT 实现。
- google-research/tft —— 原始 TFT 参考实现。