《自己动手做套利机器人》课程第 13 课。从这里进入世界 4:机器人能运行了,现在必须足够快,也要准备好展示。今天你会了解扫描器为什么会变慢,以及该怎么处理。
为什么速度在这里很重要
你读到的价格只在短暂的一刻有价值。第 11 课已经说明了这一点:其他机器人看到了同一个价差,较慢的扫描器到达时订单簿已经空了。需要两秒才能检查市场的扫描器,检查的是一个已经不存在的市场。
所以今天的问题很简单。机器人每秒能检查多少个环路,又怎样把这个数字变大?
直接的方法:三层循环
大多数人写的第一个扫描器,会检查每个由三种货币组成的环:把 A 换成 B,把 B 换成 C,再把 C 换回 A,并将这三个汇率相乘。如果乘积大于 1,钱就出现了。在代码里,这就是三层嵌套循环。
构建一个有 120 种货币的市场。汇率来自隐藏的数值,每次交易收取 0.2% 的费用,所以没有任何交易盈利。然后人为加入一个错误定价的交易对:把货币 7 换成货币 40 时,会比应有的数量多得到 2%。
import random, time
import numpy as np

random.seed(5)
N = 120
value = [random.uniform(1, 100) for _ in range(N)]
# rate[i][j] = how much of j you get for 1 of i, with a 0.2% fee on every trade
rate = [[value[i] / value[j] * 0.998 if i != j else 1.0 for j in range(N)] for i in range(N)]
rate[7][40] *= 1.02          # the planted mistake

def best_loops():
    best, arg = 0.0, None
    for i in range(N):
        for j in range(N):
            for k in range(N):
                if i == j or j == k or k == i:
                    continue
                m = rate[i][j] * rate[j][k] * rate[k][i]
                if m > best:
                    best, arg = m, (i, j, k)
    return best, arg

t = time.perf_counter(); b = best_loops(); print(round(b[0], 4), b[1], round(time.perf_counter() - t, 2), "s")
一次测试运行输出:
1.0139 (0, 7, 40) 0.55 s
扫描器找到了人为加入的错误:把 0 换成 7,把 7 换成 40,再把 40 换回 0,1 个单位变成 1.0139。2% 的人为偏差,扣掉三次各 0.2% 的费用后,剩下约 1.4%。
它用了 0.55 秒。作为演示这没有问题,对市场来说却远远太慢。环路数量随货币数量的立方增长:120 种货币约有 1.7 百万个环路,240 种约有 13.8 百万个,是原来的八倍。市场规模翻倍,循环就慢八倍。
思路 1:一次做很多乘法
计算机将两个各含百万个数字的列表相乘,远比 Python 循环逐对处理快。原因是 Python 循环的大部分时间花在管理工作上:这是什么类型,下一个元素在哪里。像 numpy 这样的库会把整个列表交给快速的编译代码,管理工作只做一次。
这个技巧有一个名字:向量化。你不再写“对每个元素做这个”,而是写“对所有元素做这个”。
我们的汇率是一张 120 行、120 列的表。在数学中它叫矩阵,三维表则是一叠这样的矩阵。每个三元组 (i, j, k) 需要的乘积是 rate[i][j] * rate[j][k] * rate[k][i]。创建同一张表的三个视图,让每个视图沿不同方向对齐,再把它们相乘:
def best_numpy():
    R = np.array(rate)
    # m[i, j, k] = R[i, j] * R[j, k] * R[k, i], all at once
    m = R[:, :, None] * R[None, :, :] * R.T[:, None, :]
    idx = np.arange(N)
    m[idx, idx, :] = 0; m[idx, :, idx] = 0; m[:, idx, idx] = 0   # drop triples with a repeat
    flat = int(m.argmax())
    return float(m.flat[flat]), np.unravel_index(flat, m.shape)

t = time.perf_counter(); b = best_numpy(); print(round(b[0], 4), tuple(int(x) for x in b[1]), round(time.perf_counter() - t, 3), "s")
怎样理解函数的第一行。R[:, :, None] 是加上一个空的第三方向后的表,因此它沿 i 和 j 变化。R[None, :, :] 沿 j 和 k 变化。R.T[:, None, :] 是转置后的表,行与列互换,因此它在 (i, k) 位置的条目是 R[k][i]。将形状为 120 × 120 × 1、1 × 120 × 120 和 120 × 1 × 120 的三个对象相乘,会得到一个 120 × 120 × 120 的立方体,每个单元格恰好保存一个乘积。接下来的几行会将索引重复的单元格置零,argmax 会找出最大的单元格。
一次测试运行输出:
1.0139 (0, 7, 40) 0.009 s
同一个答案,0.009 秒而不是 0.55 秒:约快 60 倍,用三行代码而不是一个循环。自己检查一下:如果答案和循环版不同,其中一个一定有 bug。
这个技巧的代价
这个立方体有 N × N × N 个单元格,每个单元格是一个 8 字节数字。对 120 种货币来说是 14 MB,没有问题。对 240 种货币是 110 MB,对 1000 种货币则是 8 GB,装不下。以下是一次测试运行的计时,只计算乘法:
60 numpy 0.001 s
120 numpy 0.007 s
240 numpy 0.105 s
规模翻倍仍会慢约 8 到 15 倍,因为立方体仍随 N 的立方增长。向量化改变的是常数,而不是增长形状。面对大市场,你需要减少工作量,不能只让工作变快。第 6 到 8 课讲的就是这个:Bellman-Ford 及其同类算法会跳过大部分环路。实际中要结合两者:用聪明的算法检查少量环路,用快速代码迅速检查每一个。
思路 2:可编译的语言
Rust 会在程序运行前将其变成机器码,它的循环每一步几乎没有额外成本。这样可以重新使用最简单的三层循环代码,也不必在内存中保留立方体。用 Python 把汇率保存到文本文件,每行一个行向量:
open("rates.csv", "w").write("\n".join(",".join(repr(x) for x in row) for row in rate))
接着是 Rust 程序:
use std::fs;
use std::time::Instant;

fn main() {
    let text = fs::read_to_string("rates.csv").expect("rates.csv");
    let rate: Vec<Vec<f64>> = text
        .lines()
        .map(|l| l.split(',').map(|x| x.parse().unwrap()).collect())
        .collect();
    let n = rate.len();
    let start = Instant::now();
    let (mut best, mut arg) = (0.0_f64, (0, 0, 0));
    for i in 0..n {
        for j in 0..n {
            if j == i { continue; }
            for k in 0..n {
                if k == i || k == j { continue; }
                let m = rate[i][j] * rate[j][k] * rate[k][i];
                if m > best { best = m; arg = (i, j, k); }
            }
        }
    }
    println!("rust {:.4} {:?} {:.3} s", best, arg, start.elapsed().as_secs_f64());
}
使用 rustc -O best.rs -o best && ./best 构建并运行。-O 标志会开启优化器,没有它程序会慢得多。一次测试运行输出:
rust 1.0139 (0, 7, 40) 0.005 s
0.005 秒:比 Python 循环快约 110 倍,比 numpy 略快,而且内存中没有大立方体。程序和第一个 Python 版本有同样的三层循环,改变的只有语言。
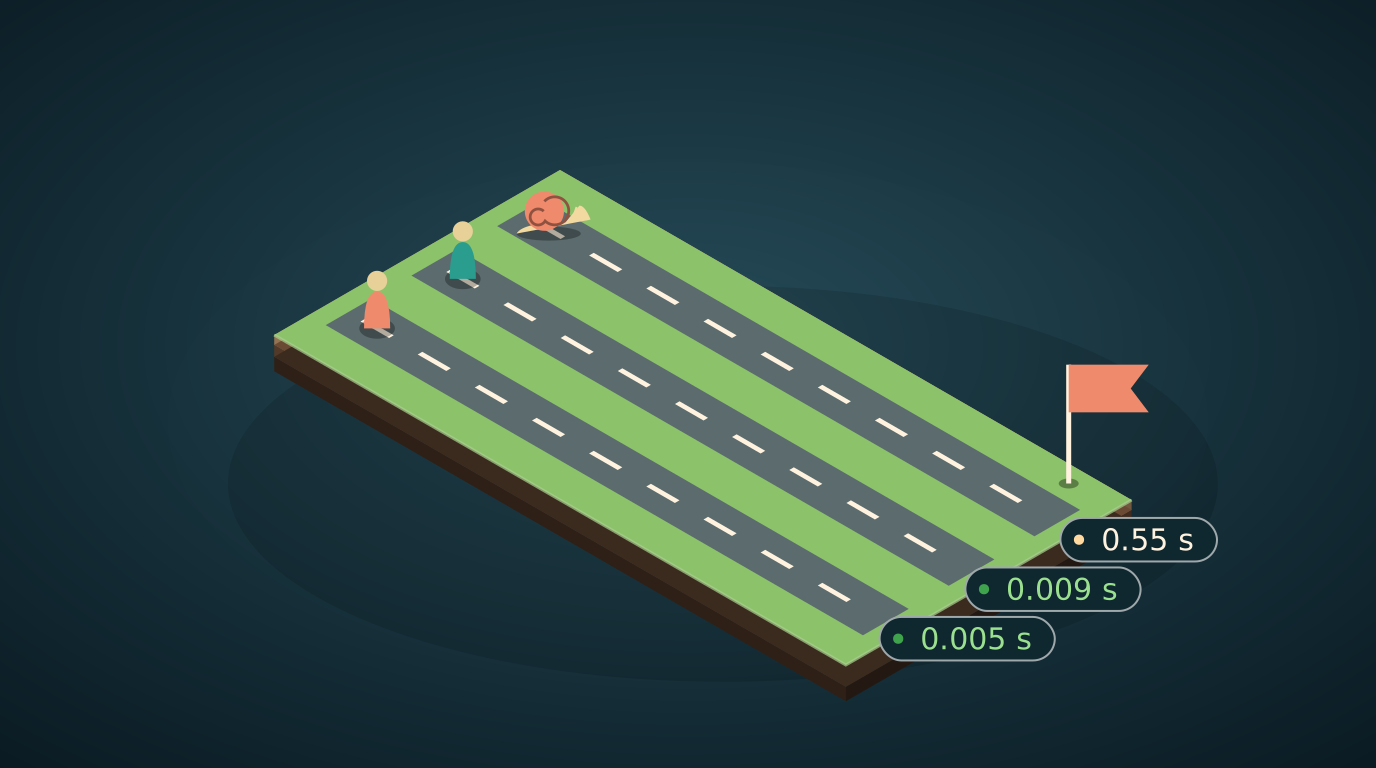
把三个结果并排比较:
| 版本 | 120 种货币的时间 | 付出的代价 |
|---|---|---|
| Python 循环 | 0.55 s | 没有,最容易读 |
| numpy 矩阵 | 0.009 s | 内存按 N³ 增长,技巧较难读 |
| Rust 循环 | 0.005 s | 第二种语言和一次编译步骤 |
为你的机器人选择什么
- 先在 Python 中做原型,让算法清晰且正确。先不要优化。
- 测量。用计时器找出最慢的部分,就像本课所做的那样。你对慢点的猜测出错的次数,比预想的更多。
- 如果慢的部分是数字上的大循环,先试 numpy。只需几行代码。
- 如果机器人必须在毫秒内反应,或者 numpy 耗尽内存,就把那一个函数移到 Rust,再从 Python 调用它,或者用 Rust 写热路径。机器人的其他部分,配置、日志和纸面交易,可以继续留在 Python。
- 更快的循环永远不能替代更好的算法。即使把检查 14 百万个环路的速度提高 100 倍,仍然比不上一个只检查 1000 个环路的算法。
让 AI 智能体编写并测试代码
一个含糊的请求:
让我的扫描器变快。
一个带有待匹配数字的请求:
编写 fast.py。按第 13 课的代码构建市场,seed 为 5,120 种货币,手续费为 0.2%,rate[7][40] 乘以 1.02。实现 best_loops 和 best_numpy,打印各自的结果和时间。两者都必须为环路 (0, 7, 40) 返回乘数 1.0139;如果不同,要说明并修复 bug。然后编写 best.rs,它从 rates.csv 读取汇率,用三层循环找出同一环路,用 rustc -O 构建并打印时间。不要更改市场的数字。
先确认三个答案完全一致,再看速度。快速的错误答案没有用。
练习
- 运行 Python 代码,确认两个版本都打印 1.0139 和环路 (0, 7, 40)。记下你的计时。
- 将 N 改为 60,再改为 200。循环版本的时间如何变化?与它按 N 的立方增长这一说法比较:200 / 120 的立方约为 4.6。
- 加入第二个错误,rate[50][90] *= 1.03,并修改函数,让它返回最好的三个环路,而不是只返回最好的一个。提示:用 np.argsort 排序立方体,或在循环中保留一个列表。
- 用 rustc 不带 -O 运行 Rust 版本,再带上 -O 运行。优化器将时间改变了多少?
接下来
现在你知道时间花在哪里,也知道怎样把它拿回来。第 14 课会加入第二种策略:期货对现货的资金费率策略,机器人从每隔数小时重复一次的小差异中赚钱,而不是从几秒内就会关闭的价差中赚钱。