課程「建立自己的套利機器人」的輔助課。第 15 課用 z-score 判斷兩枚幣何時偏離。這裡用十個數字來說明它。
關於一串數字的三個問題
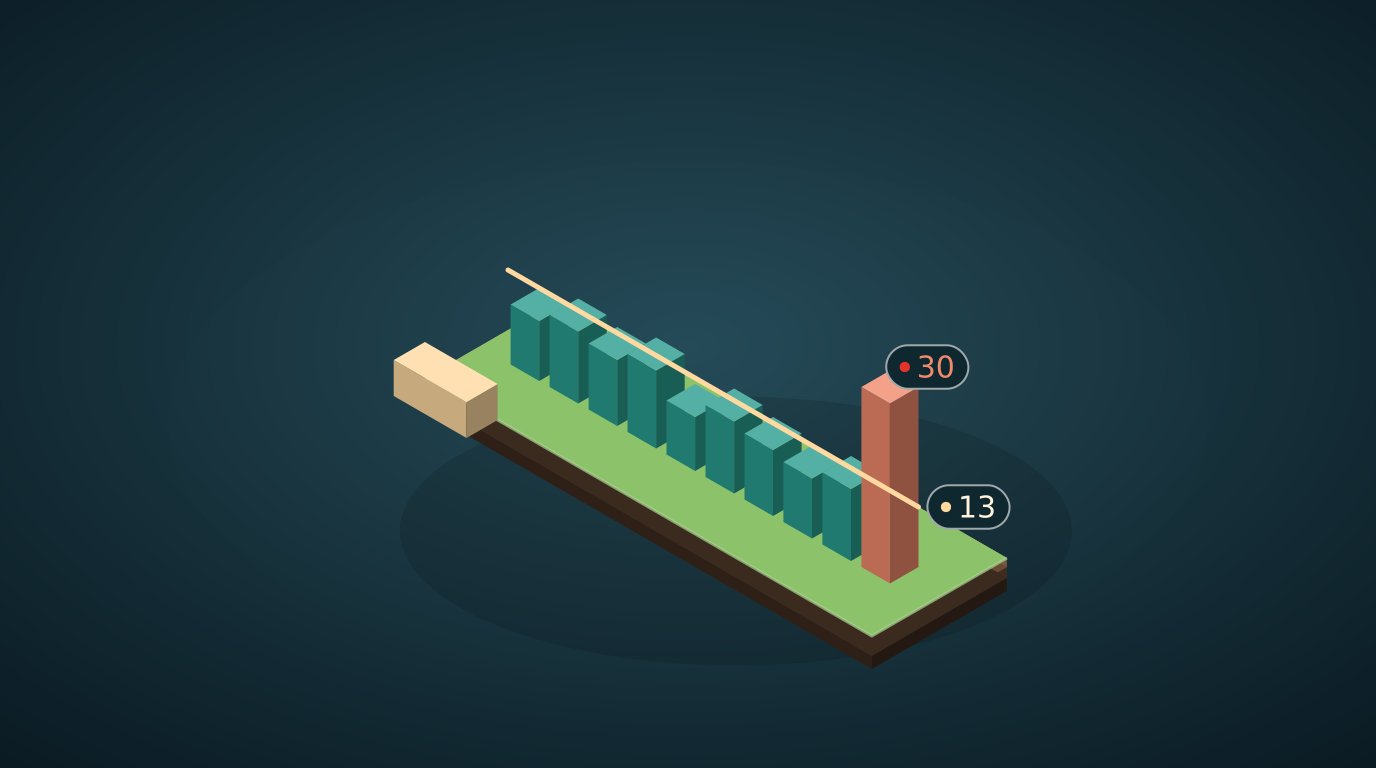
拿十天裡你的公車晚點的分鐘數舉例:10、12、11、13、9、12、11、10、12、30。
- 什麼是典型值?平均數:把所有數相加,再除以數量。
- 它們的變化有多大?標準差:到平均數的典型距離。
- 今天是否不尋常?z-score:一個數距離平均數有多少個標準差。
手算和程式碼中的步驟
import statistics
data = [10, 12, 11, 13, 9, 12, 11, 10, 12, 30]
mean = sum(data) / len(data)
print("mean", mean)
dev = [(x - mean) ** 2 for x in data]
var = sum(dev) / len(data)
print("variance", round(var, 2), "stdev", round(var ** 0.5, 2), "check", round(statistics.pstdev(data), 2))
for x in (11, 30):
    print(x, "z =", round((x - mean) / var ** 0.5, 2))
mean 13.0
variance 33.4 stdev 5.78
11 z = -0.35
30 z = 2.94
逐步來看:
- 平均數是 130 / 10 = 13。
- 對每個值,先取它到平均數的距離,再平方。這樣負數和正數不會抵消,較大的距離也會被更重地計入。把這些平方取平均,就是變異數 33.4。
- 變異數的平方根是標準差:5.78。
statistics.pstdev這一行給出的數相同,是一次核對。 - z-score 是(值 − 平均數)/ 標準差。11 分鐘這一天的 z = −0.35,接近正常。30 分鐘這一天的 z = 2.94,遠離正常。
一個異常值會改變一切
去掉 30 後重新計算其餘九天:平均數會變成 11.11,標準差會變成 1.2。現在 30 的 z-score 是 15.8,一個很大的數。當異常那天包含在清單裡時,平均數和離散程度都會增大,30 看上去只是有點異常(2.94)。對包含異常值的視窗取平均,會稍微掩蓋它。第 15 課的視窗是最近的 100 個值,它特意不包括今天。
經驗法則
對於自然界中的許多事物,大約 95 個值(共 100 個)位於平均數的 2 個標準差內。因此,z-score 高於 2 或低於 −2 的情況,在 100 天中只會出現幾天,這就是機器人把它當作訊號的原因。真實市場的尾部比這個規則所說的更厚,所以保留這個訊號,也要加上停損。
練習
- 執行程式碼。把 30 改成 14。平均數和標準差會發生什麼變化?
- 寫一串你自己的十個數字,例如通勤時間或每天的步數,然後手算最後一個數字的 z-score。
- 為什麼要把距離平方,而不是直接把它們相加?
回到課程:第 15 課(配對交易)。