Bộ nhớ đệm Parquet tổng hợp: Cách tăng tốc backtest đa khung thời gian lên hàng trăm lần
Cách tính trước các khung thời gian và chỉ báo từ nến phút, lưu vào parquet, và sử dụng chúng để kiểm thử hàng loạt chiến lược mà không cần tính toán lại thừa.
Chiến lược đa khung thời gian sử dụng nhiều khung thời gian đồng thời: khung ngày xác định hướng xu hướng, khung giờ xác định điểm vào lệnh, và khung 5 phút xác định chính xác thời điểm thực hiện. Mỗi khung thời gian yêu cầu các chỉ báo riêng: đường trung bình động, dao động, mức hỗ trợ/kháng cự.
Đối với một backtest đơn lẻ, mọi thứ khá đơn giản — tính lại các khung thời gian từ dữ liệu phút, tính các chỉ báo, chạy chiến lược. Nhưng trong quá trình tối ưu hóa hàng loạt — khi cần kiểm thử hàng nghìn tổ hợp tham số — việc tính lại khung thời gian và chỉ báo ở mỗi lần lặp trở thành nút thắt cổ chai. Một lần duyệt qua dữ liệu phút trong hai năm đồng nghĩa với việc xử lý hơn một triệu nến, và lặp lại điều này một nghìn lần là rất lãng phí.
Giải pháp: tính toán trước tất cả một lần và lưu vào file parquet.
Vấn đề: Tính toán thừa trong quá trình tối ưu hóa
Một pipeline backtest đa khung thời gian điển hình trông như thế này:
for params in parameter_grid:
    # 1. Load minute candles
    df_1m = load_candles("ETHUSDT", "1m", start, end)

    # 2. Resample to higher timeframes
    df_5m = resample_ohlcv(df_1m, "5m")
    df_1h = resample_ohlcv(df_1m, "1h")
    df_4h = resample_ohlcv(df_1m, "4h")
    df_1d = resample_ohlcv(df_1m, "D")

    # 3. Compute indicators for each timeframe
    ma_1h = compute_ma(df_1h["close"], length=params["ma_1h_len"])
    ma_4h = compute_ma(df_4h["close"], length=params["ma_4h_len"])
    ma_1d = compute_ma(df_1d["close"], length=params["ma_1d_len"])

    # 4. Run the strategy
    result = run_strategy(df_1m, ma_1h, ma_4h, ma_1d, params)
Ở mỗi lần lặp, các bước 1-3 đều được tính lại dù dữ liệu không thay đổi. Chỉ có các tham số ngưỡng của chiến lược thay đổi (bước 4). Giống như việc xây lại cả một ngôi nhà mỗi lần bạn chỉ muốn thử màu tường khác.
Ý tưởng: Tính một lần, lưu lại, tái sử dụng nhiều lần
Nhận xét chính: khung thời gian và chỉ báo chỉ phụ thuộc vào dữ liệu phút và tham số chỉ báo, không phụ thuộc vào tham số chiến lược. Nếu ta cố định tập hợp các chỉ báo cần thiết, ta có thể tính chúng một lần và lưu lại.
Sơ đồ:
Bước 1 (một lần):
  Nến phút -> Tái lấy mẫu khung thời gian -> Tính chỉ báo -> File Parquet

Bước 2 (nhiều lần):
  File Parquet -> Chiến lược với các tham số khác nhau -> Kết quả
Mô phỏng khung thời gian từ nến phút
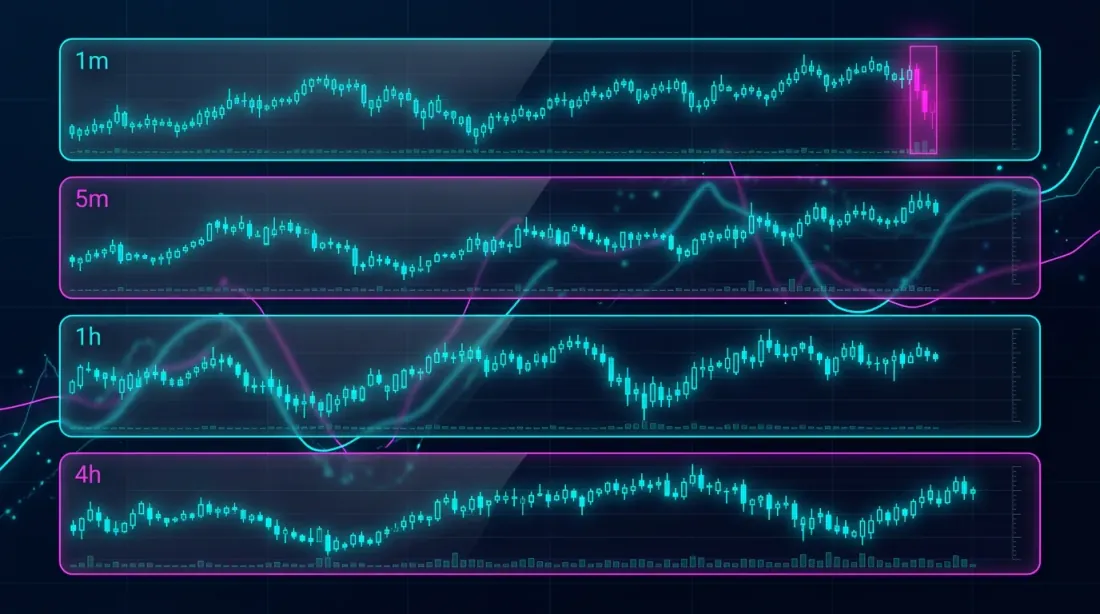
Chúng ta có toàn bộ kho lưu trữ nến phút. Từ đó, ta có thể tái tạo chính xác bất kỳ khung thời gian cao hơn nào. Nhưng có một điểm tinh tế: với resample thông thường, ta nhận được một hàng mỗi chu kỳ (một hàng mỗi giờ, một hàng mỗi 4 giờ, v.v.). Điều này không phù hợp cho backtest từng phút — ta cần biết giá trị chỉ báo tại mỗi phút.
Do đó, ta mô phỏng các giá trị khung thời gian cao hơn cho mỗi nến phút, mô hình hóa cách bot nhìn thấy dữ liệu theo thời gian thực:
- Bot nhận nến phút tiếp theo
- Cập nhật thanh hiện tại (chưa đóng) của khung thời gian cao hơn — tính lại High, Low, Close, Volume
- Tính lại chỉ báo trên tất cả các thanh đã đóng cộng với thanh một phần hiện tại
- Khi chu kỳ kết thúc — thanh được chốt và một thanh mới bắt đầu
Cách tiếp cận này đảm bảo rằng backtest nhìn thấy chính xác cùng dữ liệu như bot trong thời gian thực. Không nhìn vào tương lai — mỗi nến phút được xử lý nghiêm ngặt với dữ liệu đã có sẵn tại thời điểm đó.
class RunningCandleBuffer:
    """
    Emulates real-time updates of a higher timeframe bar
    using 1-minute candles.
    """
    def __init__(self, period_seconds: int):
        self.period = period_seconds  # 86400 for Daily, 3600 for 1h
        self.closed_bars = []
        self.current_bar = None

    def update(self, timestamp, open_, high, low, close, volume):
        bar_start = self._align_to_period(timestamp)

        if self.current_bar is None or bar_start != self.current_bar['start']:
            # New period — finalize the previous bar
            if self.current_bar is not None:
                self.closed_bars.append(self.current_bar)
            self.current_bar = {
                'start': bar_start,
                'open': open_, 'high': high,
                'low': low, 'close': close,
                'volume': volume,
            }
        else:
            # Update the current (unclosed) bar
            self.current_bar['high'] = max(self.current_bar['high'], high)
            self.current_bar['low'] = min(self.current_bar['low'], low)
            self.current_bar['close'] = close
            self.current_bar['volume'] += volume

        # All closed bars + current running bar
        return self.closed_bars + [self.current_bar]
Một RunningCandleBuffer riêng biệt được tạo cho mỗi khung thời gian cao hơn. Tại mỗi nến phút, tất cả các bộ đệm đều được cập nhật, cho ta trạng thái hiện tại của mỗi khung thời gian — như thể bot đang chạy theo thời gian thực.
Cấu trúc bộ nhớ đệm Parquet
Kết quả tính toán trước là một file parquet duy nhất, trong đó mỗi hàng tương ứng với một nến phút, và các cột chứa:
timestamp              — dấu thời gian nến phút
open, high, low,       — OHLCV nến phút
close, volume

close_5m               — Close của nến 5m mô phỏng tại thời điểm này
close_1h               — Close của nến 1h mô phỏng
close_4h               — Close của nến 4h mô phỏng
close_1d               — Close của nến ngày mô phỏng

ma_20_1h               — MA(20) trên 1h, tính lại tại phút này
ma_50_1h               — MA(50) trên 1h
ma_20_4h               — MA(20) trên 4h
ma_50_4h               — MA(50) trên 4h
ma_6_1d                — MA(6) trên Daily
ma_12_1d               — MA(12) trên Daily

cross_ma_1h            — Tín hiệu giao nhau MA trên 1h ('buy'/'sell'/None)
cross_ma_4h            — Tín hiệu giao nhau MA trên 4h
cross_ma_1d            — Tín hiệu giao nhau MA trên Daily

separation_1h          — Độ phân kỳ MA theo % trên 1h
separation_4h          — Độ phân kỳ MA theo % trên 4h
separation_1d          — Độ phân kỳ MA theo % trên Daily
Mỗi giá trị phản ánh trạng thái thực tế của chỉ báo tại thời điểm của nến phút tương ứng — tính đến các thanh chưa đóng của khung thời gian cao hơn.
Tính toán trước: Xây dựng bộ nhớ đệm
def precompute_cache(
    df_1m: pd.DataFrame,
    timeframes: dict[str, int],   # {"5m": 300, "1h": 3600, "4h": 14400, "D": 86400}
    indicators: dict,              # {"ma_20": 20, "ma_50": 50}
) -> pd.DataFrame:
    """
    Single pass through all minute candles.
    Returns a DataFrame with emulated timeframes and indicators.
    """
    # Create buffers for each timeframe
    buffers = {tf: RunningCandleBuffer(secs) for tf, secs in timeframes.items()}

    n = len(df_1m)
    result = {}

    for tf_name, buf in buffers.items():
        closes = np.zeros(n)
        ma_values = {name: np.full(n, np.nan) for name in indicators}

        for i in range(n):
            row = df_1m.iloc[i]
            bars = buf.update(
                df_1m.index[i],
                row['open'], row['high'], row['low'], row['close'], row['volume']
            )

            all_closes = [b['close'] for b in bars]
            closes[i] = all_closes[-1]

            # Compute indicators from emulated bars
            for ind_name, length in indicators.items():
                if len(all_closes) >= length:
                    ma_values[ind_name][i] = np.mean(all_closes[-length:])

        result[f'close_{tf_name}'] = closes
        for ind_name in indicators:
            result[f'{ind_name}_{tf_name}'] = ma_values[ind_name]

    cache_df = pd.DataFrame(result, index=df_1m.index)
    cache_df = pd.concat([df_1m[['open', 'high', 'low', 'close', 'volume']], cache_df], axis=1)

    return cache_df
# Build and save the cache
cache = precompute_cache(
    df_1m,
    timeframes={"5m": 300, "1h": 3600, "4h": 14400, "D": 86400},
    indicators={"ma_20": 20, "ma_50": 50, "ma_6": 6, "ma_12": 12},
)

cache.to_parquet("cache_ETHUSDT_2024_2026.parquet")
Sử dụng bộ nhớ đệm trong quá trình tối ưu hóa
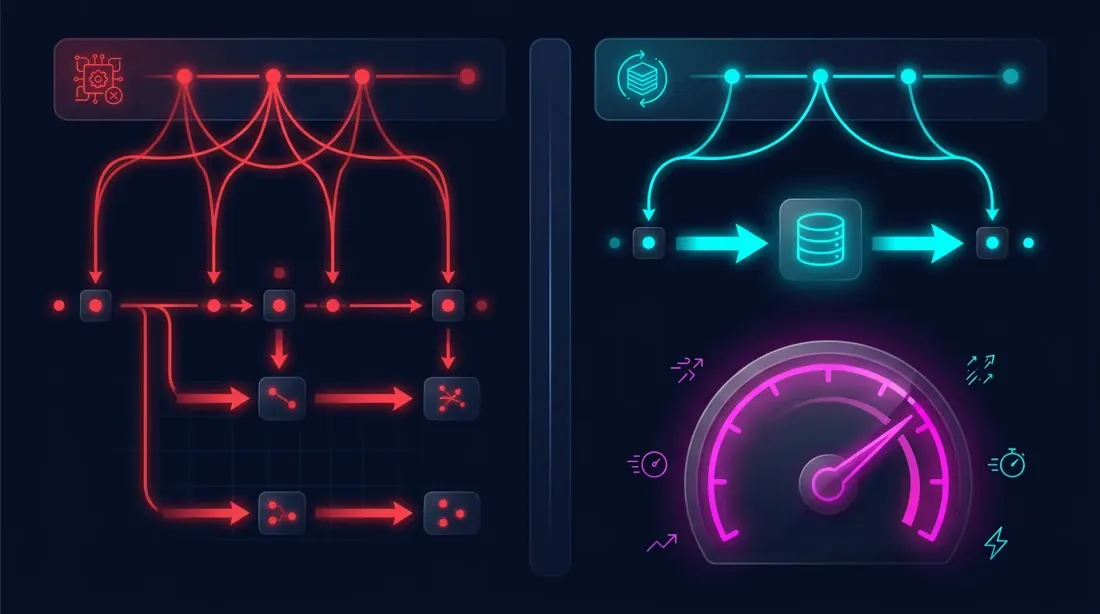
Bây giờ tối ưu hóa trông như thế này:
# Load the cache once
cache = pd.read_parquet("cache_ETHUSDT_2024_2026.parquet")

for params in parameter_grid:
    # No timeframe or indicator recalculations!
    # All data is already in the cache — only strategy logic remains
    result = run_strategy(cache, params)
Chiến lược làm việc với các cột đã được xây dựng trước — không có các lần duyệt lặp đi lặp lại qua hàng triệu nến, không tính lại MA, không mô phỏng khung thời gian. Chỉ đọc từ DataFrame và kiểm tra điều kiện vào/ra lệnh.
Tại sao lại là Parquet
Parquet là định dạng lưu trữ dữ liệu theo cột, tối ưu cho nhiệm vụ này:
- Nén. Parquet nén dữ liệu số 5-10 lần. Bộ nhớ đệm 1,1 triệu hàng với 30 cột chiếm ~50 MB thay vì ~500 MB ở định dạng CSV.
- Đọc theo cột. Nếu chiến lược chỉ sử dụng
ma_20_4hvàma_50_4h, parquet chỉ đọc những cột đó, bỏ qua phần còn lại. - Bảo toàn kiểu dữ liệu. Các kiểu dữ liệu (float64, int64, string) được bảo toàn không mất mát — không cần phân tích chuỗi khi tải.
- Tốc độ đọc. Tải parquet vào pandas mất hàng chục mili giây, nhanh hơn một bậc so với CSV.
Mở rộng bộ nhớ đệm: Thêm chỉ báo mới
Nếu chiến lược yêu cầu một chỉ báo mới (RSI, MACD, Bollinger Bands), chỉ cần:
- Tính lại chỉ báo mới từ cùng dữ liệu phút
- Thêm các cột vào file parquet hiện có
- Tất cả các cột đã tính trước đó vẫn không thay đổi
# Add RSI to the existing cache
cache = pd.read_parquet("cache_ETHUSDT_2024_2026.parquet")

# Compute only RSI (requires a pass through 1m data)
rsi_cols = compute_rsi_for_timeframes(df_1m, timeframes, length=14)

cache = pd.concat([cache, rsi_cols], axis=1)
cache.to_parquet("cache_ETHUSDT_2024_2026.parquet")
Tóm tắt: So sánh các cách tiếp cận
| Cách tiếp cận ngây thơ | Bộ nhớ đệm tổng hợp | |
|---|---|---|
| Tái lấy mẫu khung thời gian | Mỗi lần lặp | Một lần |
| Tính toán chỉ báo | Mỗi lần lặp | Một lần |
| Thời gian mỗi lần lặp | Vài phút | Dưới một giây |
| 1000 lần lặp | Hàng ngày | Vài phút |
| Mức tiêu thụ bộ nhớ | Tải 1m + tính lại | Một DataFrame duy nhất |
| Tương đồng backtest-live | Phụ thuộc vào cài đặt | Được đảm bảo (mô phỏng = thời gian thực) |
Kết luận
Cách tiếp cận bộ nhớ đệm parquet tổng hợp giải quyết đồng thời hai vấn đề:
-
Tính đúng đắn. Mô phỏng khung thời gian từ nến phút qua RunningCandleBuffer đảm bảo rằng backtest nhìn thấy cùng dữ liệu như bot trong thời gian thực — không nhìn vào tương lai và không có độ trễ nhân tạo.
-
Tốc độ. Các khung thời gian và chỉ báo được tính trước cho phép kiểm thử hàng nghìn tổ hợp tham số trong vài phút thay vì hàng ngày.
Ý tưởng rất đơn giản: tính một lần — tái sử dụng nhiều lần. Nến phút là dữ liệu nguồn. Mọi thứ khác đều là dẫn xuất và có thể được tính trước và lưu vào bộ nhớ đệm. Parquet làm cho bộ nhớ đệm này gọn gàng, nhanh chóng và tiện lợi.
Để biết thêm về cách cải thiện độ chính xác mô phỏng khớp lệnh bằng cách thu phóng thích ứng từ phút xuống giây và mili giây, xem bài viết Thu phóng thích ứng: backtest với độ chi tiết thay đổi.
Liên kết hữu ích
- Apache Parquet — định dạng lưu trữ dữ liệu
- pandas — làm việc với parquet
- Lopez de Prado — Advances in Financial Machine Learning
- Ernest Chan — Quantitative Trading
Trích dẫn
@article{soloviov2026parquetcache,
  author = {Soloviov, Eugen},
  title = {Aggregated Parquet Cache: How to Speed Up Multi-Timeframe Backtests by Hundreds of Times},
  year = {2026},
  url = {https://marketmaker.cc/vi/blog/post/parquet-cache-multitimeframe-backtest},
  description = {Cách tính trước các khung thời gian và chỉ báo từ nến phút, lưu vào parquet, và sử dụng chúng để kiểm thử hàng loạt chiến lược mà không cần tính toán lại thừa.}
}