दो-अक्षीय पैरामीटर स्पेस: आपके स्वीप का ज्यादातर हिस्सा लगभग मुफ्त क्यों होना चाहिए
सभी पैरामीटर खोजने में एक जैसे महंगे नहीं होते। स्ट्रैटेजी के पैरामीटर दो अक्षों में बंट जाते हैं: महंगा अक्ष (इंडिकेटर - पूरी सीरीज पर दोबारा गणना) और सस्ता अक्ष (डिसीजन थ्रेशोल्ड - पहले से गणना किए गए सिग्नलों पर एक O(n) पास)। चूंकि इंडिकेटर थ्रेशोल्ड से अपरिवर्तित रहते हैं, आप उन्हें एक बार गणना करके हजारों थ्रेशोल्ड कॉन्फिग ~5,600 cfg/s की रफ्तार से स्वीप कर सकते हैं - हर कॉन्फिग पर दोबारा गणना करने से करीब 1,600 गुना सस्ता। यह डाइमेंशनैलिटी के अभिशाप की कीमत का पुनर्मूल्यांकन है।
दो-अक्षीय पैरामीटर स्पेस: आपके स्वीप का ज्यादातर हिस्सा लगभग मुफ्त क्यों होना चाहिए
"बिना भ्रम के बैकटेस्ट" श्रृंखला का एक हिस्सा।
डाइमेंशनैलिटी का अभिशाप आमतौर पर एक चेतावनी की तरह सुनाया जाता है: हर नया पैरामीटर सर्च स्पेस को कई गुना बढ़ा देता है, इसलिए 18-डाइमेंशनल स्ट्रैटेजी को स्वीप करना नामुमकिन है। यह फ्रेमिंग चुपचाप मान लेती है कि हर डाइमेंशन का मूल्यांकन एक जैसा महंगा है। ऐसा नहीं है। हमारे डुअल/ट्रिपल-टाइमफ्रेम इंजन में दो-तिहाई पैरामीटर स्वीप करने में लगभग मुफ्त हैं, और एक-तिहाई पर ही करीब-करीब पूरा कंप्यूट बिल टिका है। एक बार यह विभाजन दिख जाए, तो "सर्च स्पेस बहुत बड़ा है" वाली शिकायत सही शिकायत नहीं रह जाती। सही सवाल यह है: आप किन डाइमेंशनों के लिए भुगतान कर रहे हैं?
वह डाइमेंशन जिसे दोबारा गणना की जरूरत ही नहीं थी
हमारा पैरामीटर-सर्च बेंचमार्क एक मल्टी-टाइमफ्रेम मोमेंटम स्ट्रैटेजी चलाता है: दो या तीन टाइमफ्रेम पर हल मूविंग एवरेज और उसका ट्रिपल-स्मूद्ड वेरिएंट (HMA3), साथ में एक डायरेक्शनल-सेपरेशन गेट जो तय करता है कि कोई क्रॉसओवर कब इतना "साफ" है कि उस पर कार्रवाई की जाए। ट्रिपल-TF वेरिएंट का पूरा सर्च स्पेस अठारह डाइमेंशन का है — हर टाइमफ्रेम के लिए पीरियड और HMA लंबाई, और साथ में हर टाइमफ्रेम पर एंट्री और एग्जिट के लिए सेपरेशन थ्रेशोल्ड का एक सेट।
इसे स्वीप करने का भोला तरीका एक अकेला लूप है: एक पैरामीटर वेक्टर चुनो, हर इंडिकेटर शून्य से बनाओ, सिमुलेशन चलाओ, स्कोर करो, दोहराओ। हमने वहीं से शुरुआत की थी। यह धीमा था, और धीमे होने की वजह ऐसी थी कि उसे नाम देते ही शर्मिंदगी होने लगी: पास-पास के अधिकांश ट्रायलों में हम उन इंडिकेटरों की दोबारा गणना कर रहे थे जो बदले ही नहीं थे।
एंट्री-सेपरेशन थ्रेशोल्ड को 0.03 से 0.035 तक खिसकाइए और दोबारा चलाइए। एक साल के 1-मिनट बारों पर हल MA पिछले ट्रायल से बिट-दर-बिट एक जैसा है — थ्रेशोल्ड उसकी परिभाषा में कहीं आता ही नहीं। फिर भी भोला लूप उसे हर बार नए सिरे से बनाता है — आधे मिलियन से ज्यादा बार, तीन टाइमफ्रेम की गहराई तक, हर एक बार। हम अपने कंप्यूट बजट का लगभग पूरा हिस्सा ऐसी मात्राओं को दोबारा निकालने में खर्च कर रहे थे जो उस पैरामीटर से अपरिवर्तित थीं जिसे हम असल में बदल रहे थे।
यही अवलोकन पूरा लेख है। जिस पल आप देख लेते हैं कि कुछ पैरामीटर इंडिकेटरों को बदलते हैं और कुछ सिर्फ स्थिर इंडिकेटरों पर लागू होने वाले निर्णय-नियम को बदलते हैं, उसी पल पैरामीटर स्पेस डाइमेंशनों का एक सपाट बादल नहीं रह जाता — वह दो नेस्टेड परतें बन जाता है, जिनकी कीमतों में जमीन-आसमान का फर्क है।
एक नहीं, दो अक्ष
पैरामीटरों को इस आधार पर बांटिए कि उन्हें दोबारा आंकने पर आपको क्या-क्या दोबारा गणना करनी पड़ती है:
-
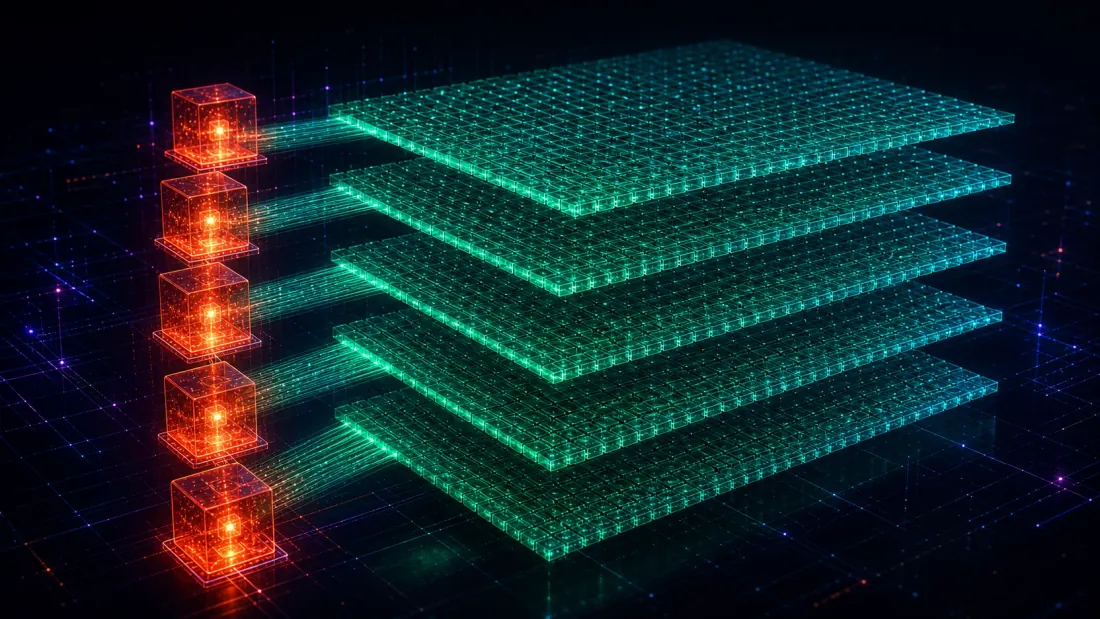
महंगा अक्ष — इंडिकेटर पैरामीटर। टाइमफ्रेम पीरियड और HMA लंबाई। इनमें से कोई भी बदलिए और आपको पूरी प्राइस सीरीज पर इंडिकेटर नए सिरे से बनाना पड़ेगा: ऊंचे टाइमफ्रेम को रीसैंपल करना, हल वेटिंग चलाना, क्रॉसओवर सीरीज और हर क्रॉस पर सेपरेशन की दोबारा गणना करना। यह इतिहास के हर बार पर एक O(n) स्वीप है, और हर अलग कॉम्बिनेशन के लिए आप इसकी पूरी कीमत चुकाते हैं। ट्रिपल-TF स्ट्रैटेजी में यह अक्ष छह पैरामीटरों का है: हाई, मिड और लो — हर टाइमफ्रेम के लिए
(period, hma_length)। -
सस्ता अक्ष — डिसीजन थ्रेशोल्ड। डायरेक्शनल-सेपरेशन गेट, जो पहले से गणना की गई क्रॉसओवर और सेपरेशन सीरीज के आधार पर तय करते हैं कि एंट्री लेनी है या एग्जिट। थ्रेशोल्ड बदलिए — कोई इंडिकेटर नहीं हिलता। आप सिर्फ पहले से गणना किए गए सिग्नलों पर एक O(n) पास दोबारा चलाते हैं: गेट जांचना और फिल दर्ज करना। ट्रिपल-TF स्ट्रैटेजी में यह अक्ष बारह पैरामीटरों का है (चार सेपरेशन थ्रेशोल्ड — एंट्री-बाय, एंट्री-सेल, एग्जिट-बाय, एग्जिट-सेल — तीनों टाइमफ्रेम में से हर एक पर)। डुअल-TF वेरिएंट में आठ हैं (दोनों टाइमफ्रेम में से हर एक पर चार थ्रेशोल्ड)।
तो स्पेस का असली आकार यह है: ट्रिपल-TF के लिए 6 महंगे + 12 सस्ते = 18, और डुअल-TF के लिए 4 महंगे + 8 सस्ते = 12। डाइमेंशनैलिटी का दो-तिहाई हिस्सा सस्ते अक्ष पर रहता है। और दोनों अक्ष सिर्फ गिनती में अलग नहीं हैं — इकाई लागत में वे परिमाण की तीन से ज्यादा कोटियों (orders of magnitude) से अलग हैं, और यही वह संख्या है जिसके बारे में इस लेख का बाकी हिस्सा है।
यह संरचना पूरी तरह नेस्टेड है। महंगे अक्ष का हर बिंदु — हर टाइमफ्रेम के लिए एक ठोस (period, hma_length) — स्थिर सिग्नल ऐरे का एक सेट परिभाषित करता है। उस स्थिर नींव के ऊपर सस्ते अक्ष की पूरी शीट बैठती है: हजारों थ्रेशोल्ड वेक्टर, जिनमें से हर एक उन्हीं ऐरे पर एक तेज पास है। नींव की कीमत आप एक बार चुकाते हैं और पूरी शीट पर उसे अमॉर्टाइज कर लेते हैं।
इंडिकेटर थ्रेशोल्ड से अपरिवर्तित क्यों रहते हैं
यह कैशिंग किसी सौभाग्यशाली इम्प्लीमेंटेशन डिटेल की वजह से नहीं, बल्कि एक गणितीय तथ्य की वजह से काम करती है, और उसे ठीक-ठीक बयान करना जरूरी है क्योंकि पूरा भार इसी धारणा पर टिका है। इंडिकेटर ऐरे केवल (period, hma_length) के फलन हैं। सेपरेशन थ्रेशोल्ड उनकी परिभाषा में कहीं भी नहीं आते।
ठोस रूप में, हर टाइमफ्रेम के लिए इंजन बेस इंडेक्स पर चार संरेखित ऐरे पहले से गणना कर लेता है: हल MA hma, उसका ट्रिपल-स्मूद्ड hma3, क्रॉसओवर सीरीज cross (+1 बाय / −1 सेल / 0), और हर क्रॉस पर separation प्रतिशत। इनमें से हर एक कीमतों और दो इंडिकेटर पैरामीटरों से निकाला गया है। थ्रेशोल्ड — वह संख्या जिससे आप separation की तुलना करते हैं — बाद में, निर्णय के समय लागू होता है। वह ऐरे को छूता तक नहीं।
यह कोई मामूली-सा सुरक्षित पुनर्विन्यास नहीं है। यह सिर्फ इसलिए सुरक्षित है क्योंकि हमने इस बात पर सावधानी बरती कि सूचना कब उपलब्ध होती है — यही इस श्रृंखला में अन्यत्र किए गए लुक-अहेड बायस वाले काम का विषय है। बेस बार i पर ऊंचे टाइमफ्रेम का इंडिकेटर बंद हो चुकी हायर-TF कैंडलों और एक बन रही कैंडल से गणना होता है, जिसका चालू क्लोज मौजूदा बेस क्लोज close[i] के बराबर है — एक ऐसा मान जो बार i पर ज्ञात है। भविष्य से कुछ भी रिसकर अंदर नहीं आता। इसलिए बार i पर पहले से गणना किया गया सिग्नल ठीक वही है जो एक लाइव बॉट बार i पर देखता, और आप बाद में उसके सामने चाहे जो थ्रेशोल्ड परखें, वह वैध बना रहता है। लीक वाले सिग्नल को कैश करना बस लीक को ही कैश करना है; कॉजल (causal) सिग्नल को कैश करना कुछ ऐसा कैश करना है जिस पर आप वाकई ट्रेड कर सकते हैं।
यह अपरिवर्तनीयता (invariance) हमें एक गुणनखंडन (factorization) देती है। एक पूरे पैरामीटर वेक्टर θ = (indicator_params, threshold_params) के मूल्यांकन को यों लिखिए:
signals   = build_indicators(indicator_params)      # EXPENSIVE, depends only on indicator_params
score     = simulate(signals, threshold_params)     # CHEAP, reuses signals across all thresholds
build_indicators कभी threshold_params को पढ़ता ही नहीं। यही अकेला तथ्य कैश की इजाजत देता है: indicator_params को स्थिर रखिए, threshold_params को आजादी से बदलिए, और signals एक स्थिरांक है जिसे आप एक बार गणना करते हैं।
आर्किटेक्चर: एक बार गणना, कई बार स्वीप
इंजन (scripts/engine_multitf.py, हमारे बैकटेस्टर में कमिट bfc8aaa) इस गुणनखंडन को दो हिस्सों से लागू करता है, जिनके नाम खुद बता देते हैं कि वे क्या करते हैं।
SignalCache — महंगा अक्ष, मेमोइज किया हुआ। यह (period_bars, hma_length) से की किया गया एक डिक्शनरी है। उससे किसी टाइमफ्रेम के सिग्नल मांगिए — अगर वह इंडिकेटर कॉम्बो पहले बन चुका है तो वह कैश किया हुआ TFSignals लौटा देता है, वरना एक बार बनाकर सहेज लेता है। चूंकि की में सिर्फ इंडिकेटर पैरामीटर हैं, एक इंडिकेटर कॉम्बो साझा करने वाला हर थ्रेशोल्ड कॉन्फिग — और घने थ्रेशोल्ड स्वीप में ऐसे हजारों होते हैं — उसी कैश एंट्री पर पहुंचता है। ऊंचे टाइमफ्रेम इसका खास इनाम देते हैं: मान लीजिए चार उम्मीदवार पीरियड गुणा मुट्ठी भर HMA लंबाइयों का एक मोटा ग्रिड — यानी गिनती के अलग-अलग महंगे बिल्ड, और हर एक बिल्ड उसके ऊपर खड़ी पूरी थ्रेशोल्ड शीट में दोबारा इस्तेमाल होता है।
sweep_separations — सस्ता अक्ष, बैच में। यह कैश किए हुए सिग्नल ऐरे और थ्रेशोल्ड वेक्टरों का एक मैट्रिक्स (sps, आकार [m, 12]) लेता है और उन सबको एक ही कंपाइल किए हुए कर्नेल से गुजारता है। हर पंक्ति एक O(n) पास है: बारों पर चलो, गेट लागू करो, open[i+1] पर लीक-रहित फिल दर्ज करो, PnL और पोजीशन-में-समय का हिसाब रखो। इस लूप के अंदर कोई इंडिकेटर दोबारा नहीं बनता — यह cross और separation सीधे कैश से पढ़ता है। भीतरी सिमुलेशन JIT-कंपाइल्ड (Numba) है, इसलिए एक बार गर्म होने के बाद प्रति-कॉन्फिग लागत में मुख्य हिस्सा बारों पर एक अकेले रैखिक स्कैन का होता है, Python के ओवरहेड का नहीं।
दोनों हिस्से मिलकर स्वाभाविक नेस्टेड खोज बनाते हैं: बाहरी लूप महंगे अक्ष पर चलता है (हर इटरेशन एक इंडिकेटर कॉम्बो बनाकर कैश करता है), और भीतरी लूप उन्हीं कैश किए हुए ऐरे पर सस्ते अक्ष के आर-पार एक चौड़ा बैच फैलाता है। कोड में आकार ठीक यही है — एक छोटा महंगा लूप, जिसके भीतर एक चौड़ा सस्ता बैच:
cache = SignalCache(base_close, base_ts)           # keyed by (period, hma_length)

for htf_p, htf_h, mtf_p, mtf_h, ltf_p, ltf_h in indicator_grid:   # EXPENSIVE axis (coarse)
    htf = cache.get(htf_p, htf_h)                  # built once, then a cache hit forever
    mtf = cache.get(mtf_p, mtf_h)
    ltf = cache.get(ltf_p, ltf_h)

    sps = sample_thresholds(m=4000)                # CHEAP axis: [m, 12] threshold vectors
    pnl, n_trades, bars_in_pos = sweep_separations(  # one compiled batch, no indicator work
        base_close, base_open, htf, ltf, sps, mtf=mtf)
महंगे बिल्डर को आप उतनी ही बार छूते हैं जितनी बार इंडिकेटर ग्रिड मजबूर करे, और भारी मात्रा का काम सस्ते स्वीप से करवाते हैं — कभी न हिलने वाले ऐरे के सामने हजारों sps पंक्तियां। बस यही पूरा ऑप्टिमाइजेशन है — कोई सन्निकटन नहीं, कोई खोई हुई सटीकता नहीं, सिर्फ उस चीज की दोबारा गणना से इनकार जो बदली ही नहीं।
"मुफ्त" की असली कीमत: आंकड़े
हमने दोनों अक्षों को डेमो वर्कलोड पर मापा: 1-मिनट ETHUSDT बारों का पूरा एक साल (~527k बार), ट्रिपल-TF, इंडिकेटर पहले से गर्म और JIT कंपाइलेशन को टाइमिंग से बाहर रखा गया।
सस्ते अक्ष पर sweep_separations लगातार ~5,600 थ्रेशोल्ड-कॉन्फिग प्रति सेकंड निभाता है। यानी हर कॉन्फिग के लिए एक पूरा सिमुलेशन — गेट, फिल, PnL, एक्सपोजर — आधे मिलियन से ज्यादा बारों पर, करीब 180 माइक्रोसेकंड प्रति कॉन्फिग की दर से। इतना तेज हो पाने की वजह यह है कि यह इंडिकेटर का शून्य काम करता है: हर कॉन्फिग वही कैश किए हुए cross और separation ऐरे पढ़ता है।
अब विकल्प की कीमत लगाइए। ट्रिपल-TF इंडिकेटर सेट को एक बार बनाने में कुछ सौ मिलीसेकंड (~0.3 s) की कोटि का समय लगता है — तीन टाइमफ्रेम की रीसैंपलिंग, हल वेटिंग, पूरे साल पर क्रॉसओवर और सेपरेशन निकालना। अगर आप कॉन्फिग लूप के अंदर इंडिकेटर दोबारा गणना करते — यानी भोला सिंगल-लूप डिजाइन — तो प्रति सेकंड उन 5,600 कॉन्फिगों में से हर एक को पूरा इंडिकेटर बिल्ड चुकाना पड़ता। प्रति-कॉन्फिग लागत ~180 माइक्रोसेकंड से फूलकर ~0.3 सेकंड हो जाती है:
| प्रति कॉन्फिग लागत | कॉन्फिग/सेकंड | |
|---|---|---|
| सस्ता अक्ष (कैश किए हुए सिग्नल) | ~180 µs | ~5,600 |
| हर कॉन्फिग पर इंडिकेटरों की दोबारा गणना | ~0.3 s | ~3.4 |
अनुपात है ~1,600 गुना। कैश किए हुए सिग्नलों पर सस्ते अक्ष को स्वीप करना उस भोले डिजाइन से करीब तीन कोटि सस्ता है जो हर थ्रेशोल्ड वेक्टर के लिए इंडिकेटर नए सिरे से बनाता है। ठोस शब्दों में: कुछ हजार थ्रेशोल्ड कॉन्फिगों का जो बैच कैश वाले रास्ते पर एक सेकंड से कम में निपट जाता है, वही — अगर हर कॉन्फिग अपने इंडिकेटर दोबारा बनाता — घंटे भर के करीब लेता। वही नतीजे, वही सटीकता, गणित में कोई शॉर्टकट नहीं — फर्क सिर्फ इतना कि एक डिजाइन एक अपरिवर्तनीय राशि की दोबारा गणना करता है और दूसरा नहीं।
यह अंत में छिड़क देने वाला कोई माइक्रो-ऑप्टिमाइजेशन नहीं है। यह बदल देता है कि कौन सी खोजें व्यवहार्य हैं। 5,600 cfg/s पर थ्रेशोल्ड अक्ष इतना घना हो जाता है कि उसे ढंग से खंगाला जा सके — हर इंडिकेटर कॉम्बो पर आप बारीक ग्रिड या लंबा रैंडम/QMC सैंपल झेल सकते हैं — जबकि महंगा अक्ष जान-बूझकर मोटे, गिनती के बिल्डों तक सीमित रहता है। कंप्यूट बजट वहीं बहता है जहां पैरामीटरों की वाकई कोई कीमत है।
डाइमेंशनैलिटी का अभिशाप, नई कीमत पर
उस फ्रेमिंग पर लौटिए जिससे यह लेख शुरू हुआ था। डाइमेंशनैलिटी का अभिशाप कहता है कि सर्च स्पेस पैरामीटरों की संख्या में घातांकीय रूप से बढ़ता है, इसलिए ज्यादा डाइमेंशन हर हाल में बदतर हैं। ग्रिड के आकार के बारे में यह सच है। उसे ढकने की लागत के बारे में यह भ्रामक है, क्योंकि यह हर डाइमेंशन की कीमत एक जैसी लगाता है।
अक्षों को अलग करते ही गिनती अलग पढ़ी जाती है। ट्रिपल-TF स्ट्रैटेजी 18-डाइमेंशनल है, पर उन डाइमेंशनों में से सिर्फ 6 महंगे हैं। बाकी 12 सस्ते-अक्ष के डाइमेंशन हैं, जो ग्रिड तो बढ़ाते हैं पर कंप्यूट बिल को किसी सार्थक तरीके से नहीं — उन पर आप कौड़ियों के भाव हजारों कॉन्फिग झोंक सकते हैं। डुअल-TF स्ट्रैटेजी 12-डाइमेंशनल है, जिसमें सिर्फ 4 महंगे और 8 सस्ते डाइमेंशन हैं। दोनों ही मामलों में "अभिशाप" का बड़ा हिस्सा उसी अक्ष पर केंद्रित है जिसे स्वीप करने की लागत लगभग शून्य है।
इसलिए खोज की लागत के बारे में ईमानदार सोच "कितने पैरामीटर" नहीं, बल्कि "कितने महंगे पैरामीटर, और उनका ग्रिड कितना मोटा रखा जा सकता है" है। घातांक की असली चोट महंगे अक्ष पर पड़ती है, और वहीं आपको छोटा, सोच-समझकर चुना हुआ ग्रिड चाहिए — कुछ उम्मीदवार पीरियड, HMA लंबाइयों की एक संयत रेंज — जिसे संभवतः मोटे-से-बारीक तरीके से परिष्कृत किया जाए, उसी भावना में जिस एडैप्टिव-रेजोल्यूशन ड्रिल-डाउन का इस्तेमाल हम अन्यत्र करते हैं। सस्ता अक्ष वह जगह है जहां आप दिल खोलकर खर्च कर सकते हैं, क्योंकि हर अतिरिक्त थ्रेशोल्ड कॉन्फिग की कीमत 180 माइक्रोसेकंड है।
यह पुनर्मूल्यन हमारी HMA स्ट्रैटेजी से कहीं आगे तक सामान्यीकृत होता है। यह पैटर्न — कुछ पैरामीटर फीचर बदलते हैं, ज्यादातर पैरामीटर स्थिर फीचरों पर लागू होने वाला नियम बदलते हैं — सिस्टमैटिक ट्रेडिंग में हर जगह दोहराया जाता है। इंडिकेटर लंबाइयां, रीसैंपलिंग आवृत्तियां और लुकबैक विंडो महंगे हैं; एंट्री/एग्जिट थ्रेशोल्ड, स्टॉप दूरियां, पोजीशन-साइजिंग गुणक और कन्फर्मेशन गेट सस्ते हैं। जब भी कोई पैरामीटर पहले से गणना किए गए सिग्नलों पर सिर्फ निर्णय-सीमा (decision boundary) का आकार बदलता है, वह सस्ते अक्ष का है, और उसे वहीं स्वीप करना चाहिए। इसी परिवार की मिलती-जुलती कैशिंग जीतें मल्टी-टाइमफ्रेम parquet कैशिंग और व्यापक इंजन स्पीड लैडर में दिखती हैं।
जहां मुफ्त की दावत का बिल आता है
सस्ता अक्ष कंप्यूट में सस्ता है। सांख्यिकी में सस्ता नहीं है, और इन दोनों को गड्डमड्ड करना ही वह तरीका है जिससे परफॉर्मेंस की जीत ओवरफिटिंग की मशीन बन जाती है।
आप जिस भी थ्रेशोल्ड कॉन्फिग का मूल्यांकन करते हैं वह एक ट्रायल है, और जब आप एक ही डेटासेट पर हजारों ट्रायल चलाते हैं, तो उनमें से सबसे अच्छा आंशिक रूप से किस्मत की वजह से अच्छा दिखता है। उन ट्रायलों को 1,600 गुना सस्ता कर देने से किस्मत गायब नहीं होती — उसे जमा करना और आसान हो जाता है। घना थ्रेशोल्ड स्वीप ठीक वही स्थिति है जहां मल्टीपल-टेस्टिंग की फुलावट सबसे बुरी तरह काटती है: बहुत सारे उम्मीदवार, एक इतिहास, और एक चयन नियम जो अधिकतम रिपोर्ट करता है। दुनिया का सबसे तेज इंजन भी खुशी-खुशी आपको ऐसा थ्रेशोल्ड वेक्टर थमा देगा जो आपकी टेस्ट विंडो के शोर पर खूबसूरती से फिट बैठता है और आउट-ऑफ-सैंपल फेल हो जाता है।
इसलिए अनुशासन को रफ्तार के साथ-साथ बढ़ना होगा। जिस पल एक ट्रायल की कंप्यूट लागत शून्य की ओर गिरती है, सांख्यिकीय हिसाब-किताब बाध्यकारी बंधन बन जाता है, और उसे आपको खुलकर चुकाना पड़ता है:
- ट्रायल गिनती के हिसाब से डिफ्लेट करें। विजेता का स्कोर इस हिसाब से आंकें कि आपने कितने कॉन्फिग आजमाए, शून्य के हिसाब से नहीं। डिफ्लेटेड शार्प रेशियो और बैकटेस्ट ओवरफिटिंग की प्रायिकता ठीक इसी के लिए मौजूद हैं — वे "हमने 4,000 थ्रेशोल्ड वेक्टर आजमाए" को रिपोर्ट किए गए एज पर कटौती में बदल देते हैं।
- आउट-ऑफ-सैंपल, हर फोल्ड पर सत्यापित करें। सस्ते स्वीप को भी ईमानदार वॉक-फॉरवर्ड विभाजन के भीतर ही चलाना होगा; जो थ्रेशोल्ड सिर्फ इन-सैंपल जीतता है वह बेकार है, चाहे आपने उसे कितनी भी तेजी से क्यों न खोजा हो। हमारा इंजन फिलों को लीक-रहित (
open[i+1]) ठीक इसीलिए रखता है ताकि सस्ता अक्ष भविष्य में झांककर परफॉर्मेंस न खरीद सके। - चोटियों के बजाय पठारों को तरजीह दें। चूंकि थ्रेशोल्ड अक्ष घना और तेज है, आप उसकी पूरी रिस्पॉन्स सरफेस का नक्शा बना सकते हैं, सिर्फ उसका argmax नहीं। थ्रेशोल्डों का एक चौड़ा इलाका जो पूरा-का-पूरा काम करता है, असली एज है; एक अकेला नुकीला अधिकतम एक फिट किया हुआ आर्टिफैक्ट है — यही पठार-बनाम-चोटी का भेद है, जिसे वही रफ्तार किफायती बनाती है जिसकी हम यहां बात कर रहे हैं।
दो-अक्षीय संरचना को सही तरीके से पढ़िए: यह आपको ज्यादा भरोसा नहीं खरीदकर देती, यह प्रति ट्रायल उसी भरोसे की लागत पर ज्यादा ट्रायल खरीदकर देती है। यह वाकई कीमती है — सस्ते अक्ष का घना कवरेज ही आपको पठार खोजने और सरफेस का चरित्र समझने देता है — पर सिर्फ तभी, जब आप सांख्यिकीय बहीखाता ईमानदार रखें। रफ्तार अच्छी तरह न खोजने का कंप्यूट वाला बहाना छीन लेती है; अच्छी तरह की गई खोज के नतीजों पर छूट लगाने की जिम्मेदारी नहीं छीनती।
अपनी खोज को कैसे संरचित करें
इसे अपनी स्ट्रैटेजी पर लागू करने के लिए काम ज्यादातर वर्गीकरण का है — अपने पैरामीटरों को सही अक्ष पर छांटना — और उसके बाद एक नेस्टेड लूप:
- हर पैरामीटर पर इस आधार पर लेबल लगाएं कि वह आपसे क्या दोबारा गणना करवाता है। अगर उसे बदलने से कोई इंडिकेटर/फीचर ऐरे बदलता है, तो वह महंगा है। अगर वह स्थिर ऐरे पर लागू होने वाली सिर्फ तुलना, थ्रेशोल्ड या साइजिंग नियम बदलता है, तो वह सस्ता है। शक हो तो पूछिए: क्या यह पैरामीटर इंडिकेटर की परिभाषा के अंदर कहीं आता है? अगर नहीं, तो वह सस्ता है।
- कैश की की (key) सिर्फ महंगे अक्ष पर रखें। फीचर निर्माण को उसके इंडिकेटर पैरामीटरों से मेमोइज करें (जैसे
SignalCache(period, hma_length)से करता है)। तब एक इंडिकेटर कॉम्बो साझा करने वाले पास-पास के ट्रायल वही ऐरे मुफ्त में दोबारा इस्तेमाल करते हैं। - सस्ते अक्ष को कैश किए हुए फीचरों पर बैच करें। थ्रेशोल्ड कॉन्फिगों को पहले से गणना किए गए सिग्नलों पर एक कसे हुए कंपाइल्ड लूप की तरह चलाएं, पूरे पुनर्मूल्यांकनों की तरह नहीं। आपका थ्रूपुट — और हमारे मामले में ~5,600 cfg/s — यहीं से आता है।
- लूपों को नेस्ट करें: महंगा बाहर, सस्ता भीतर। महंगे ग्रिड को छोटा और सोचा-समझा रखें (मोटा, या मोटे-से-बारीक); सस्ते स्वीप को घना रहने दें। बजट वहां खर्च करें जहां पैरामीटरों की कोई कीमत है।
- ट्रायलों का बजट घड़ी के नहीं, ओवरफिटिंग के हिसाब से तय करें। अब जब घड़ी सीमा नहीं रही, तो डिफ्लेटेड शार्प / PBO को सीमा बनने दें। तय करें कि सांख्यिकीय रूप से आप सस्ते अक्ष के कितने ट्रायल झेल सकते हैं, और विजेता को आउट-ऑफ-सैंपल सत्यापित करें।
इंजीनियरिंग का फायदा और सांख्यिकीय रेलिंग एक ही विचार के दो पहलू हैं: अक्षों को अलग करना आपको सस्ते डाइमेंशनों को छान मारने देता है, और ठीक इसीलिए फिर आपको इस बात पर छूट लगानी पड़ती है कि आपने कितनी बारीकी से छाना।
निष्कर्ष
- सभी डाइमेंशनों की कीमत एक जैसी नहीं होती। स्ट्रैटेजी के पैरामीटर एक महंगे अक्ष (इंडिकेटर — पूरी सीरीज पर दोबारा गणना) और एक सस्ते अक्ष (थ्रेशोल्ड — पहले से गणना किए गए सिग्नलों पर एक O(n) पास) में बंट जाते हैं। हमारे इंजन में यह ट्रिपल-TF के लिए 6 महंगे + 12 सस्ते है, डुअल-TF के लिए 4 + 8।
- इंडिकेटर थ्रेशोल्ड से अपरिवर्तित हैं, और यही अपरिवर्तनीयता पूरा ऑप्टिमाइजेशन है। फीचर निर्माण सिर्फ इंडिकेटर पैरामीटरों पर निर्भर है, इसलिए आप एक बार बनाते हैं,
(period, hma_length)से कैश करते हैं, और उस कॉम्बो को साझा करने वाले हर थ्रेशोल्ड कॉन्फिग में दोबारा इस्तेमाल करते हैं। - सस्ता अक्ष ~1,600 गुना सस्ता चलता है। कैश किए हुए सिग्नलों पर ~5,600 थ्रेशोल्ड-कॉन्फिग/सेकंड (~180 µs प्रत्येक), बनाम ~0.3 s प्रति कॉन्फिग अगर आप हर बार इंडिकेटर नए सिरे से बनाएं। वही सटीकता — फर्क सिर्फ एक अपरिवर्तनीय राशि की दोबारा गणना से इनकार का है।
- डाइमेंशनैलिटी का अभिशाप असल में महंगी डाइमेंशनैलिटी का अभिशाप है। पैरामीटर गिनती का ज्यादातर हिस्सा उस अक्ष पर रहता है जिसे स्वीप करना लगभग मुफ्त है। महंगे ग्रिड को मोटा रखें; सस्ते पर दिल खोलकर खर्च करें।
- रफ्तार बाध्यकारी बंधन को कंप्यूट से सांख्यिकी की ओर खिसका देती है। घना, तेज स्वीप एक मल्टीपल-टेस्टिंग मशीन है। ट्रायल गिनती के हिसाब से डिफ्लेट करें, हर फोल्ड पर सत्यापित करें, और चोटियों के बजाय पठारों को तरजीह दें — मुफ्त की दावत असली है, पर सांख्यिकीय बिल वैकल्पिक नहीं है।
पूरा इंजन — SignalCache, sweep_separations, लीक-रहित मल्टी-TF सिमुलेशन, और वह पैरिटी टेस्ट जो उसे लाइव रनिंग-कैंडल सिमैंटिक्स से बांधे रखता है — हमारे बैकटेस्टर में scripts/engine_multitf.py (कमिट bfc8aaa) में रहता है। अगली बार जब कोई कहे कि 18-पैरामीटर स्ट्रैटेजी खोज के लिए बहुत बड़ी है, तो उससे पूछिए कि उन पैरामीटरों में से कितने वाकई इंडिकेटरों को हिलाते हैं। आमतौर पर वे एक-तिहाई होते हैं, और बाकी लगभग मुफ्त हैं।