हमारे घरेलू एल्गोरिद्म के भीतर: Hull-White के साथ HRP + Long/Short + CVaR
Pipeline की गहराई से पड़ताल - वह समग्र एलोकेशन एल्गोरिद्म जिसे हमने HRP के ऊपर बनाया। आधार के रूप में Hierarchical Risk Parity, एजेंट सिग्नल और कॉन्फिडेंस से संचालित एक long/short ओवरले, और Hull-White वोलैटिलिटी एडजस्टमेंट के साथ CVaR के जरिए अंतिम रिस्क करेक्शन। हमारे स्पेक की पूरी गणित, साथ ही असली Rust इम्प्लीमेंटेशन।
📄 यह लेख एक रिसर्च पेपर में बदल गया। इस पाइपलाइन के केंद्र में मौजूद HRP एलोकेशन को ज्ञात कोवैरिएंस के तहत Markowitz, Ledoit–Wolf श्रिंकेज, और 1/N के मुकाबले एक नियंत्रित परीक्षण में परखा गया है (4,800 प्रयोग)। पेपर को ऑनलाइन (इंटरैक्टिव वर्शन + PDF) hrp.marketmaker.cc पर पढ़ें, कोड और डेटा github.com/suenot/hrp-validation पर।
हमारे ओवरव्यू «12 पोर्टफोलियो ऑप्टिमाइजेशन एल्गोरिद्म, तुलना» में हमने एक दर्जन एलोकेशन तरीकों को साथ-साथ दौड़ाया था। उनमें से ग्यारह टेक्स्टबुक क्लासिक हैं। बारहवाँ, Pipeline, हमारा अपना है — और उस पोस्ट में उसे ठीक एक बुलेट पॉइंट मिला। यह लेख उसकी गहराई से पड़ताल है: इसके भीतर क्या है, हर फॉर्मूला कहाँ से आता है, और स्पेसिफिकेशन Rust में कैसे बदलता है।
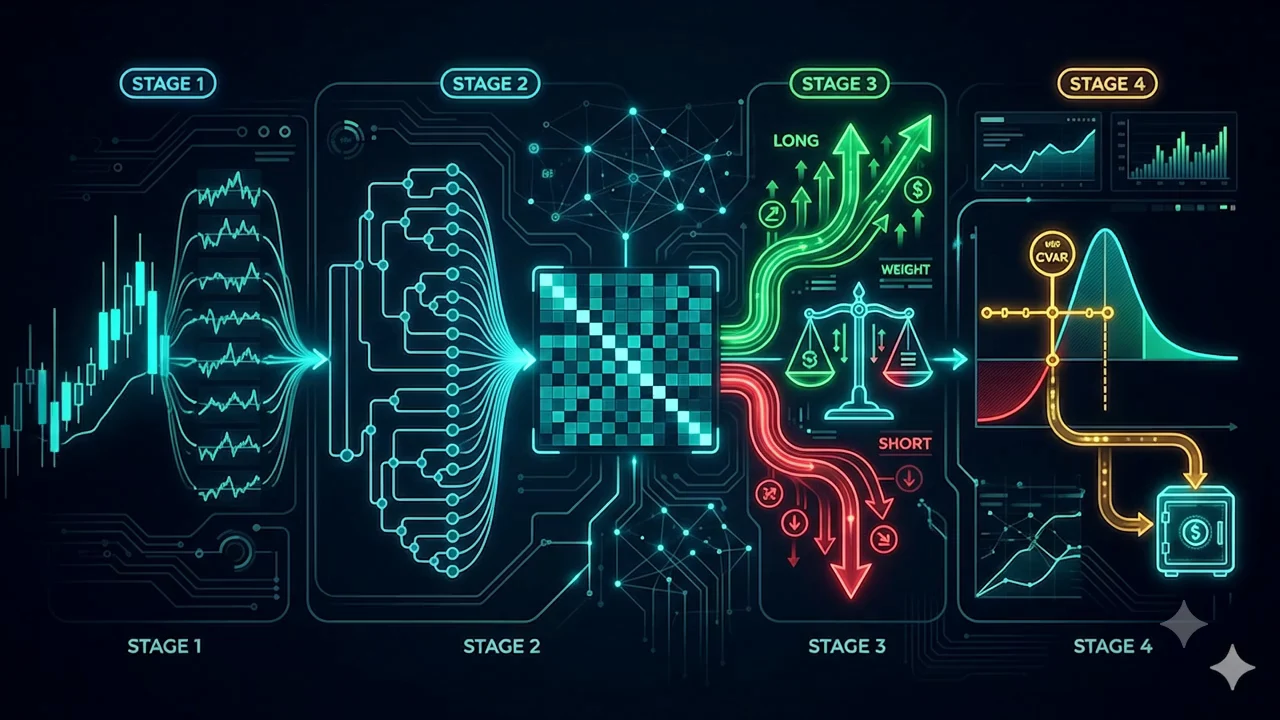
Pipeline वज़न निकालने का कोई नया तरीका नहीं गढ़ता। यह सबसे मज़बूत ज्ञात रेसिपी — Hierarchical Risk Parity (HRP) — को लेता है और उसे उन दो परतों में लपेट देता है जिनकी एक लाइव ट्रेडिंग खाते को वाकई ज़रूरत होती है लेकिन जो सादे HRP में नहीं होतीं: दिशा (रणनीति सिग्नल से long/short) और एक सख्त रिस्क बजट (मौजूदा वोलैटिलिटी रिजीम के अनुसार समायोजित CVaR)। इससे चार चरण बनते हैं।
चार चरण
- I — हर एसेट के लॉग रिटर्न।
- II — HRP से आधार वज़न।
- III — एजेंट सिग्नल से एक long/short विभाजन, जिसमें रिस्क हिस्सेदारी कॉन्फिडेंस के अनुसार तय होती है।
- IV — Hull-White वोलैटिलिटी के साथ CVaR करेक्शन; अतिरिक्त रिस्क कैश में चला जाता है।
आइए इन्हें क्रम से देखें।
चरण I. लॉग रिटर्न
सब कुछ कीमतों से लॉग रिटर्न की ओर बढ़ने से शुरू होता है:
जहाँ एसेट है और टाइम स्टेप। लॉग रिटर्न समय के साथ जुड़ते हैं और सादे प्रतिशत बदलावों की तुलना में अधिक सिमेट्रिक होते हैं — किसी भी कोवैरिएंस गणित के लिए मानक इनपुट।
चरण II. आधार के रूप में HRP
HRP, जिसे Marcos López de Prado ने 2016 में प्रस्तावित किया, Mean-Variance Optimization की केंद्रीय बीमारी — एक ill-conditioned कोवैरिएंस मैट्रिक्स को इनवर्ट करना — से बचता है। यह इसे बिल्कुल भी इनवर्ट नहीं करता। इसके बजाय यह सहसंबंधों की संरचना के साथ काम करता है।
कोवैरिएंस और सहसंबंध
रिटर्न से हम कोवैरिएंस मैट्रिक्स बनाते हैं और उसे सहसंबंध मैट्रिक्स में सामान्यीकृत करते हैं:
डिस्टेंस मैट्रिक्स
हम सहसंबंध को एक डिस्टेंस मेट्रिक में बदलते हैं, ताकि मजबूती से सहसंबद्ध एसेट "पास-पास" पड़ें:
जितना 1 के करीब होता है, उतना ही 0 के करीब होता है — और उन एसेट के एक ही क्लस्टर में होने की संभावना उतनी ही ज़्यादा होती है।
डेंड्रोग्राम और लीफ ऑर्डर
डिस्टेंस मैट्रिक्स से हम average linkage के ज़रिए एक क्लस्टर पदानुक्रम बनाते हैं और लीफ ऑर्डर निकालते हैं — एसेट का एक क्रमचय जिसमें समान एसेट एक-दूसरे से सटे होते हैं।
वैकल्पिक चरण: क्लस्टरों की इष्टतम संख्या सिल्हूट गुणांक से चुनी जा सकती है, जहाँ एक क्लस्टर के भीतर औसत दूरी है और निकटतम पड़ोसी क्लस्टर से औसत दूरी। बेस पास को इसकी ज़रूरत नहीं होती — रिकर्सिव बाइसेक्शन पहले से ही पदानुक्रम का सम्मान करता है।
क्वासी-डायगोनलाइज़ेशन
हम की पंक्तियों और स्तंभों को के अनुसार क्रमचयित करते हैं, जिससे बड़े मान विकर्ण के साथ इकट्ठा हो जाते हैं:
रिकर्सिव बाइसेक्शन
फिर रिकर्शन ऊपर से नीचे चलता है। हर चरण पर एक क्लस्टर को और में आधा-आधा बाँटा जाता है, और पूंजी को दोनों हिस्सों के बीच उनके वैरिएंस के व्युत्क्रमानुपाती आवंटित किया जाता है:
किसी क्लस्टर का वैरिएंस उसके कोवैरिएंस सब-ब्लॉक पर के रूप में गणना किया जाता है। यह अवरोहण तब तक जारी रहता है जब तक हर नोड में एक ही एसेट न रह जाए। वज़न long-only, गैर-नकारात्मक होते हैं, और 1.0 तक जुड़ते हैं।
हमारे इम्प्लीमेंटेशन में यह फंक्शन hrp_from_cov(cov) -> Vec<f64> है: सहसंबंध → डिस्टेंस → average linkage → लीफ ऑर्डर → क्वासी-डायगोनलाइज़ेशन → रिकर्सिव बाइसेक्शन। Pipeline इसे अपने आधार के रूप में बुलाता है — और बिना सिग्नल वाले केस के लिए यह पब्लिक optimize() भी है।
चरण III. Long/short ओवरले
सादा HRP एक "सिर्फ खरीदो" पोर्टफोलियो है। लेकिन एक रणनीति अक्सर सिर्फ कितना नहीं बल्कि किस दिशा में भी बताती है। चरण III एजेंट से प्रति-एसेट सिग्नल (Long/Short) लेता है और दो सब-पोर्टफोलियो बनाता है।
- सिग्नल के अनुसार एसेट को long और short बास्केट में बाँटा जाता है।
- हर बास्केट के भीतर, वज़न उसी HRP से (उन एसेट के कोवैरिएंस सब-ब्लॉक पर) निकाले जाते हैं, जो प्रति बास्केट 1 तक जुड़ते हैं।
- यदि एजेंट कॉन्फिडेंस भी देता है, तो दोनों पक्षों के बीच रिस्क हिस्सेदारी कुल कॉन्फिडेंस से तय होती है:
कॉन्फिडेंस न होने पर, हिस्सेदारी हर बास्केट में एसेट की संख्या पर वापस आ जाती है। अंतिम साइन्ड वज़न longs के लिए और shorts के लिए है, जिसके बाद पूरे ग्रॉस एक्सपोज़र को 1 पर सामान्यीकृत किया जाता है।
कोड के बारे में एक ईमानदार टिप्पणी। मूल स्पेक में करेक्शन फैक्टर , मौजूद हैं — लेकिन उन्हें "क्या हमें वाकई इस चरण की ज़रूरत है?" के साथ चिह्नित भी किया गया है। इम्प्लीमेंटेशन इन्हें लागू नहीं करता: दोनों पक्षों को सीधे रिस्क हिस्सेदारी से जोड़ा जाता है, जो ग्रॉस एक्सपोज़र को ठीक 1 पर बनाए रखता है और कोई छिपा हुआ लीवरेज नहीं बनाता। यह स्पेक का एक जानबूझकर किया गया सरलीकरण है, न कि कोई चूक।
चरण IV. Hull-White एडजस्टमेंट के साथ CVaR
HRP रिस्क को संरचनात्मक रूप से संतुलित करता है, लेकिन धन के रूप में जोखिम के पूर्ण स्तर के बारे में कुछ नहीं जानता। अंतिम चरण टेल रिस्क पर एक सख्त सीमा लगाता है — और इसे बाज़ार रिजीम में बदलाव के प्रति संवेदनशील बनाता है।
पोर्टफोलियो रिटर्न और EWMA वोलैटिलिटी
पहले हम वज़न को एक पोर्टफोलियो रिटर्न में समेटते हैं और EWMA से सशर्त वोलैटिलिटी का अनुमान लगाते हैं:
के साथ (क्लासिक RiskMetrics मान)। EWMA पूरे इतिहास पर औसत निकाली गई वोलैटिलिटी के बजाय "आज की" वोलैटिलिटी देता है।
Hull-White रीस्केलिंग
मुख्य विचार: पिछले रिटर्न को जस-का-तस नहीं लिया जा सकता — वे एक अलग वोलैटिलिटी के तहत हुए थे। Hull-White विधि हर पिछले रिटर्न को मौजूदा स्तर पर रीस्केल करती है:
एक शांत महीना "खिंच" जाता है, एक अशांत महीना "संकुचित" हो जाता है, और वितरण को मौजूदा रिजीम में लाया जाता है।
VaR और CVaR
रीस्केल किए गए वितरण पर हम लॉस क्वांटाइल और टेल में औसत लॉस लेते हैं:
CVaR (उर्फ Expected Shortfall) यह जवाब नहीं देता कि "एक सामान्य बुरा दिन कितना बुरा है" बल्कि यह कि "सबसे बुरे प्रतिशत में औसतन कितना बुरा है" — इसलिए यह सिर्फ किनारे को नहीं, टेल की मोटाई को देखता है।
रिस्क बजट और कैश
अगर CVaR स्वीकार्य सीमा से ज़्यादा हो जाता है, तो हर जोखिम भरी पोज़िशन को एक ही फैक्टर से घटा दिया जाता है, और मुक्त हुई पूंजी कैश में चली जाती है:
इस तरह पोर्टफोलियो खुद-ब-खुद रिस्क कम कर लेता है जब टेल रिस्क बढ़ता है, और शांत होने पर बाज़ार में फिर से प्रवेश करता है।
स्पेक से कोड तक
पूरा एल्गोरिद्म एक ही Rust क्रेट, portfolio-pipeline, में रहता है, और वर्कस्पेस के यूनिफ़ॉर्म कॉन्ट्रैक्ट का पालन करता है:
pub fn optimize(prices: &[Vec<f64>]) -> Vec<f64>
यह long-only प्रोजेक्शन है (बिना सिग्नल के चरण I, II, IV) — बाकी ग्यारह एल्गोरिद्म जैसा ही prices -> weights इंटरफेस, जिससे Pipeline उनमें से किसी का भी ड्रॉप-इन रिप्लेसमेंट बन जाता है। हर चरण वाला पूरा वर्शन एक अलग फंक्शन है:
pub fn run(
    prices: &[Vec<f64>],
    signals: Option<&[Side]>,      // Long / Short per asset
    confidence: Option<&[f64]>,    // agent confidence → risk shares λ
    cfg: &PipelineConfig,          // CVaR / Hull-White parameters
) -> PipelineResult                // signed weights + cash + cvar + σ
ओवरले डिफॉल्ट: टेल cvar_alpha = 0.05, बजट cvar_max = 0.05, EWMA ewma_lambda = 0.94, Hull-White विंडो hw_window = 0 (पूरा इतिहास)। इम्प्लीमेंटेशन में कोई बाहरी निर्भरता नहीं है और यह जानबूझकर डिफेंसिव है: छोटे इतिहास पर (4 से कम कीमत बिंदु) यह बराबर वज़न लौटाता है, और CVaR ओवरले सिर्फ ≥8 रिटर्न ऑब्ज़र्वेशन पर ही सक्रिय होता है — वरना टेल का अनुमान लगाने के लिए कुछ नहीं होता।
Rust क्यों: बैकटेस्ट और प्रोडक्शन दोनों के लिए एक ही डिटरमिनिस्टिक कोडबेस, बिना "रिसर्च में Python, प्रोड में कुछ और" वाले ड्रिफ्ट के, और कंपैरिज़न बैकएंड के ज़रिए एक ही रिक्वेस्ट में सभी बारह एल्गोरिद्म चलाने के लिए काफी तेज़।
समय में इसकी कीमत क्या है
"काफी तेज़" कितना तेज़ है? हमने HRP कोर (लॉग रिटर्न → कोवैरिएंस → average linkage → क्वासी-डायगोनलाइज़ेशन → रिकर्सिव वज़न) को एक स्टैंडअलोन बेंचमार्क में निकाला और बिल्कुल वही गणित सात भाषाओं में चलाया — C, C++, Rust, Zig, Python, Node.js और Bun — समान परिस्थितियों में: Apple Silicon, सिंगल थ्रेड, प्रति एसेट 365 दैनिक ऑब्ज़र्वेशन, सिंथेटिक कीमतें, एसेट संख्या 10 से 10,000 तक।
जटिलता के बारे में एक बात, क्योंकि यह पूरा आकार तय करती है। average linkage का टेक्स्टबुक वर्शन हर मर्ज पर निकटतम जोड़ी के लिए पूरे डिस्टेंस मैट्रिक्स को दोबारा स्कैन करता है — यह है और कुछ हज़ार एसेट पर बॉटलनेक बन जाता है। बेंचमार्क इसके बजाय nearest-neighbour-chain एल्गोरिद्म (Müllner 2011) का उपयोग करता है — वही जो SciPy के linkage(method='average') के पीछे है। इसके होने पर, क्लस्टरिंग अब प्रमुख चरण नहीं रहता: पर यह ~0.5 सेकंड के पास में से सिर्फ ~15 ms है। अब लागत कोवैरिएंस मैट्रिक्स, पर हावी है — वह एकमात्र चरण जिससे कोई भी HRP-शैली की विधि बच नहीं सकती।
रन क्या दिखाते हैं (हर भाषा की पूरी टेबल और एक-कमांड रीप्रोडक्शन स्क्रिप्ट प्रोजेक्ट रिपॉज़िटरी में मौजूद हैं):
- वास्तविक पोर्टफोलियो पर यह मुफ्त है। एक क्रिप्टो बास्केट में दर्जनों एसेट होते हैं, शायद ही कभी सौ से ज़्यादा। पर एक पूरा HRP पास Node में भी सिंगल-डिजिट मिलीसेकंड और Rust/C में माइक्रोसेकंड में हो जाता है। हर टिक पर वज़न फिर से निकालना कोई समस्या नहीं है।
- Rust, C के ~1.0–1.3× के भीतर है — वही मैग्निट्यूड ऑर्डर, दोनों कंपाइल्ड, और हज़ारों तक पहुँचने पर लगभग बराबर। कच्चे अंकगणित पर C थोड़ा तेज़ है, लेकिन Rust बिना गार्बेज कलेक्टर और बिना UB के वही प्रेडिक्टेबिलिटी देता है।
- यह हज़ारों एसेट तक स्केल करता है। linkage के साथ, कंपाइल्ड भाषाओं में पर एक पूरा पास ~0.5 सेकंड और पर कुछ सेकंड लेता है; इंटरप्रेटेड Node भी को दो सेकंड से कम में पार कर लेता है। अब जो सीमा तय करता है वह कोवैरिएंस चरण है, क्लस्टरिंग नहीं।
व्यावहारिक निष्कर्ष: हमारे पोर्टफोलियो आकारों पर, Rust चुनना "C को हराने" के बारे में नहीं है (यहाँ C थोड़ा तेज़ है) — यह रिसर्च और प्रोडक्शन दोनों के लिए एक डिटरमिनिस्टिक कोडबेस, बिना GC विराम, और वर्षों की परफॉर्मेंस हेडरूम के बारे में है। सात भाषाओं का पूरा बेंचमार्क, नतीजों और रीप्रोडक्शन स्क्रिप्ट के साथ, प्रोजेक्ट रिपॉज़िटरी में खुला है।
बारह में Pipeline कहाँ खड़ा है
एक ही (जानबूझकर सजाए गए) बास्केट पर हमारी तुलना में, Pipeline ने HRP जैसा व्यवहार किया — क्योंकि long-only optimize() एंट्री पॉइंट के ज़रिए यह CVaR ओवरले के साथ HRP ही है। इसकी दिशात्मक मशीनरी तभी जागती है जब आप इसे रणनीति सिग्नल देते हैं। यही पूरी बात है: Pipeline "वज़न बैकटेस्ट करने के लिए एक और ऑप्टिमाइज़र" नहीं है बल्कि रणनीति सिग्नल और असली ऑर्डर के बीच की एक्ज़ीक्यूशन लेयर है — यह आपके खरीद/बिक्री निर्णय लेता है, हर पक्ष के भीतर HRP से पूंजी बिछाता है, पक्षों को कॉन्फिडेंस से संतुलित करता है, और टेल रिस्क को एक तय बजट तक काट देता है।
पूरे संदर्भ के लिए — अन्य ग्यारह विधियाँ कौन सी हैं और वे कैसे अलग हैं — ओवरव्यू देखें, «12 पोर्टफोलियो ऑप्टिमाइजेशन एल्गोरिद्म, तुलना»। और आप यह सब लाइव portfolio-optimizer.marketmaker.cc पर आज़मा सकते हैं।
संदर्भ
- López de Prado, M. (2016). Building Diversified Portfolios that Outperform Out of Sample. The Journal of Portfolio Management.
- López de Prado, M. (2018). Advances in Financial Machine Learning. Wiley.
- Hull, J., & White, A. (1998). Incorporating Volatility Updating into the Historical Simulation Method for Value at Risk. Journal of Risk.
- Rockafellar, R. T., & Uryasev, S. (2000). Optimization of Conditional Value-at-Risk. Journal of Risk.
- RiskMetrics Group (1996). RiskMetrics — Technical Document. J.P. Morgan.
- Marketmaker.cc: marketmaker.cc
उद्धरण
@article{soloviov2026pipeline,
  author = {Soloviov, Eugen and Zhuravleva, Marina and Kiselev, Kirill},
  title = {Inside Our House Algorithm: HRP + Long/Short + CVaR with Hull-White Adjustment},
  year = {2026},
  url = {https://marketmaker.cc/hi/blog/post/portfolio-pipeline-hrp-cvar},
  description = {A deep dive into Pipeline, a composite portfolio allocation algorithm built on Hierarchical Risk Parity with a signal-driven long/short overlay and a Hull-White CVaR risk-budget correction, with the full specification and its Rust implementation.}
}