समन्वय अवरोहण बनाम बायेसियन अनुकूलन: बेहतर पैरामीटर कौन खोजता है
12+ पैरामीटरों के लिए संपूर्ण खोज असंभव क्यों है, समन्वय अवरोहण इंटरैक्शन को कैसे चूक जाता है, और TPE सैंपलर के साथ Optuna 500 इटरेशन में वह कैसे खोज लेता है जो OAT 96 में नहीं खोज पाता। व्यावहारिक कोड उदाहरण, सैंपलर तुलना, और मल्टी-ऑब्जेक्टिव अनुकूलन।
यह "बिना भ्रम के बैकटेस्ट" श्रृंखला का पांचवां लेख है। पिछले लेखों में हमने नुकसान-लाभ असममिति, मोंटे कार्लो बूटस्ट्रैप, फंडिंग रेट्स का प्रभाव, और तेज़ बैकटेस्ट के लिए Parquet कैश को कवर किया। अब बात करते हैं इष्टतम रणनीति पैरामीटर खोजने की प्रक्रिया की — एक ऐसा कार्य जहां अंतर्ज्ञान सबसे अधिक बार विफल होता है।
आपके पास 12 पैरामीटरों वाली एक रणनीति है। प्रत्येक पैरामीटर ~9 मान लेता है। आप सीमित ड्रॉडाउन के साथ PnL को अधिकतम करने वाला संयोजन खोजना चाहते हैं। आप यह कैसे करेंगे?
यदि आपका जवाब है "मैं सभी संयोजनों को आजमाता हूं" — तो आपको एक समस्या है। यदि आपका जवाब है "मैं एक बार में एक पैरामीटर बदलता हूं" — तो आपको एक अलग समस्या है। यह लेख इस बारे में है कि प्रत्येक दृष्टिकोण के पीछे कौन सी समस्याएं छिपी होती हैं और उन्हें कैसे हल किया जाए।
संपूर्ण खोज असंभव क्यों है
आयामीयता का अभिशाप
संपूर्ण खोज (ग्रिड सर्च) प्रत्येक पैरामीटर के लिए मानों के हर संयोजन का परीक्षण करती है। 9 मानों वाले दो पैरामीटरों के लिए, यह रन हैं — पूरी तरह से व्यावहारिक। तीन के लिए: — सहनीय।
लेकिन 12 पैरामीटरों वाली वास्तविक रणनीति के लिए:
दो सौ बयासी अरब रन। भले ही एक बैकटेस्ट में 1 सेकंड लगे (जो पहले से ही आशावादी है), संपूर्ण खोज में लगेगा:
यह घातीय वृद्धि है: प्रत्येक नया पैरामीटर खोज स्थान को 9 से गुणा कर देता है। एक 13वां पैरामीटर जोड़ें — और 9,000 वर्षों की बजाय आपको 80,000 चाहिए होंगे।
import math

def grid_search_cost(n_params: int, values_per_param: int, seconds_per_trial: float) -> dict:
    """Estimate the cost of exhaustive search."""
    total_trials = values_per_param ** n_params
    total_seconds = total_trials * seconds_per_trial
    return {
        "total_trials": total_trials,
        "total_hours": total_seconds / 3600,
        "total_years": total_seconds / (3600 * 24 * 365),
    }

# Real example: 12 parameters, 9 values each, 1 second per backtest
cost = grid_search_cost(12, 9, 1.0)
print(f"Trials: {cost['total_trials']:,.0f}")      # 282,429,536,481
print(f"Years:  {cost['total_years']:,.0f}")        # 8,950
पूर्व-गणना के साथ भी
Parquet कैश पर लेख में हमने दिखाया था कि टाइमफ्रेम और इंडिकेटरों की पूर्व-गणना एक बैकटेस्ट को ~1 सेकंड तक तेज़ कर देती है। लेकिन प्रति रन 0.1 सेकंड पर भी, 12 पैरामीटरों की संपूर्ण खोज के लिए 895 वर्ष चाहिए होंगे। पूर्व-गणना मदद करती है, लेकिन घातीय वृद्धि की मूलभूत समस्या का समाधान नहीं करती।
हमें ऐसी विधियां चाहिए जो संपूर्ण खोज की तुलना में पैरामीटर स्पेस को अधिक बुद्धिमानी से खोजें।
समन्वय अवरोहण और OAT: तेज़ लेकिन अंधा
एक ही विचार के दो रूप
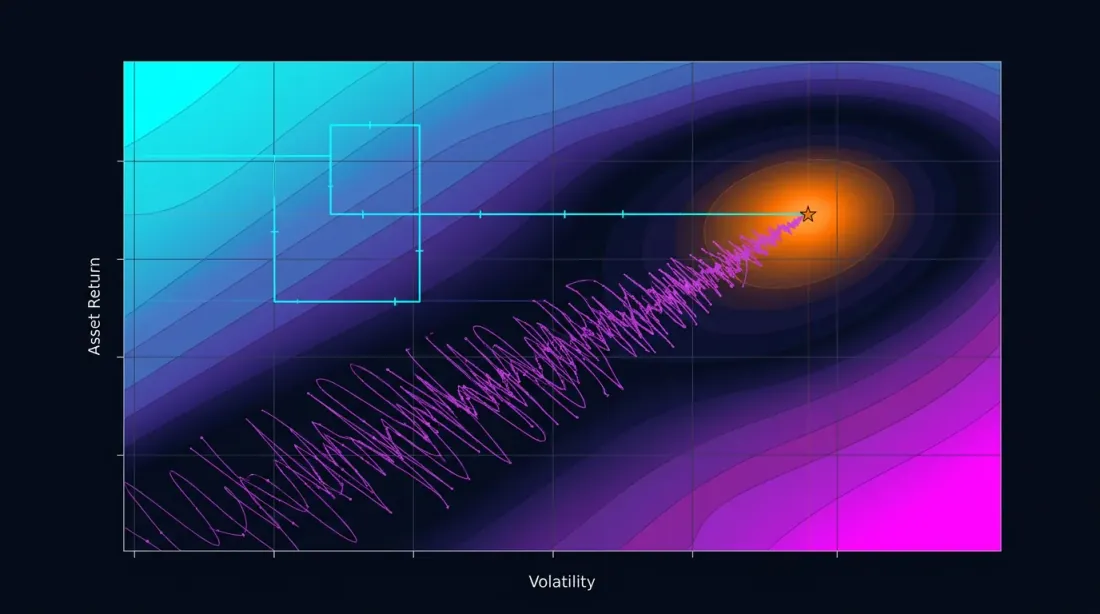
दो संबंधित दृष्टिकोण हैं — दोनों एक समय में एक पैरामीटर को अनुकूलित करते हैं, लेकिन पासों की संख्या में भिन्न होते हैं:
OAT (One-at-a-Time) स्वीप — सभी पैरामीटरों के माध्यम से एक ही पास। पहले पैरामीटर के मानों से गुजरें, सर्वश्रेष्ठ को तय करें, दूसरे पर जाएं — और इसी तरह। एक बार। तेज़ और सस्ता।
Coordinate Descent — मल्टी-पास। अंतिम पैरामीटर को अनुकूलित करने के बाद, पहले पर वापस लौटें और जांचें कि क्या इष्टतम बदल गया है (चूंकि संदर्भ बदल गया है — अन्य पैरामीटर मान अब अलग हैं)। अभिसरण तक राउंड दोहराए जाते हैं। अधिक महंगा, लेकिन अधिक सटीक — हर राउंड समाधान को परिष्कृत कर सकता है।
व्यवहार में, बैकटेस्ट के लिए OAT का अधिक उपयोग होता है: 12 पैरामीटरों के माध्यम से एक ही पास — 96 रन। 3-5 राउंड के साथ coordinate descent — 300-500 रन, जो पहले से ही Optuna के तुलनीय है, लेकिन इसके फायदों के बिना।
12 पैरामीटरों के लिए ~8 मानों के साथ:
ग्रिड सर्च के लिए से तुलना करें। OAT रैखिक है: के बजाय । यह इसका मुख्य लाभ और मुख्य समस्या दोनों है।
def oat_sweep(
    param_grid: dict[str, list],
    run_backtest_fn,
    initial_params: dict,
    metric: str = "effective_score",
) -> dict:
    """
    OAT sweep: single pass, optimizing one parameter at a time.

    param_grid: {"htf_entry_sell": [0.0, 0.005, ..., 0.05], ...}
    initial_params: starting values for all parameters
    metric: metric to optimize (effective_score recommended —
            PnL per active time extrapolated to a year)
    """
    best_params = initial_params.copy()
    best_score = run_backtest_fn(**best_params)[metric]

    for param_name, values in param_grid.items():
        param_best_val = best_params[param_name]
        param_best_score = best_score

        for val in values:
            candidate = best_params.copy()
            candidate[param_name] = val
            result = run_backtest_fn(**candidate)
            score = result[metric]

            if score > param_best_score:
                param_best_score = score
                param_best_val = val

        best_params[param_name] = param_best_val
        best_score = param_best_score
        print(f"{param_name}: best={param_best_val}, score={param_best_score:.4f}")

    return best_params
अनुकूलन के लिए कौन सा मेट्रिक चुनें? कच्चे PnL या PnL@MaxLev के बजाय, effective score — सक्रिय समय प्रति PnL का उपयोग करने की सिफारिश की जाती है, जिसे एक वर्ष तक एक्सट्रापोलेट किया गया हो। यह मेट्रिक पोजीशन में बिताए गए समय को ध्यान में रखता है और अलग-अलग ट्रेडिंग फ्रीक्वेंसी वाली रणनीतियों की सही तुलना की अनुमति देता है।
अंधा स्थान: पैरामीटर इंटरैक्शन
OAT मानता है कि प्रत्येक पैरामीटर का प्रभाव योगात्मक है — यानी, एक पैरामीटर का इष्टतम मान दूसरों के मानों पर निर्भर नहीं करता। यह धारणा कुछ पैरामीटरों के लिए सही है, लेकिन युग्मित पैरामीटरों के लिए टूट जाती है।
योगात्मक बनाम युग्मित पैरामीटर
अनुकूलन से पहले — पैरामीटरों को वर्गीकृत करना उपयोगी है:
योगात्मक (स्वतंत्र) — एक का इष्टतम मान दूसरे पर निर्भर नहीं करता। इन्हें सस्ते में एक बार में एक अनुकूलित किया जा सकता है:
htf_entry_sellऔरhtf_entry_buy— एक ही टाइमफ्रेम पर अलग-अलग दिशाओं (सेल/बाय) के लिए एंट्री थ्रेशोल्ड। सेल थ्रेशोल्ड शॉर्ट सिग्नल फ़िल्टर करता है, बाय थ्रेशोल्ड — लॉन्ग। ये ट्रेडों के गैर-अतिव्यापी उपसमुच्चयों पर काम करते हैं।tp_targetऔरbe_trigger— टेक-प्रॉफिट और ब्रेकईवन, यदि वे परस्पर विरोधी निकास शर्तें नहीं बनाते।
युग्मित (इंटरैक्टिव) — एक का इष्टतम मान दूसरे पर निर्भर करता है। संयुक्त अनुकूलन आवश्यक है:
htf_entry_sellऔरmtf_entry_sell— अलग-अलग टाइमफ्रेम पर समान दिशा (सेल) के लिए थ्रेशोल्ड। HTF तय करता है कि कौन से सिग्नल MTF तक पहुंचते हैं, और MTF थ्रेशोल्ड फ़िल्टरिंग प्रभावशीलता तय करता है। जब MTF बदलता है तो HTF इष्टतम बदल जाता है।ltf_entry_sell,mtf_entry_sell,htf_entry_sell— एक दिशा के लिए पूरी थ्रेशोल्ड चेन।partial_fracऔरtp_target— आंशिक क्लोज़ का आकार TP स्तर पर निर्भर करता है।
व्यावहारिक दृष्टिकोण: पहले योगात्मक पैरामीटरों को OAT के माध्यम से सस्ते में अनुकूलित करें। फिर युग्मित समूहों को Optuna के माध्यम से अनुकूलित करें। इससे बजट कम होता है: Optuna में 12 पैरामीटरों के बजाय, हम केवल 6-8 युग्मित पैरामीटर भेजते हैं, जबकि बाकी पहले से ही तय हैं।
उदाहरण: OAT एक इंटरैक्शन को कैसे चूक जाता है
दो युग्मित थ्रेशोल्ड पर विचार करें:
htf_entry_sell— उच्च टाइमफ्रेम पर थ्रेशोल्ड (सेल दिशा)mtf_entry_sell— मध्य टाइमफ्रेम पर थ्रेशोल्ड (सेल दिशा)
OAT mtf_entry_sell = 0.01 (प्रारंभिक मान) तय करता है और htf_entry_sell से गुजरता है। सर्वश्रेष्ठ मान पाता है: htf_entry_sell = 0.02। इसे तय करता है और अगले पैरामीटर पर जाता है — कभी वापस नहीं लौटता।
यहां वह है जो OAT चूक गया:
htf_entry_sell | mtf_entry_sell | PnL |
|---|---|---|
| 0.02 | 0.01 | +42% |
| 0.02 | 0.02 | +38% |
| 0.03 | 0.02 | +51% |
| 0.03 | 0.01 | +35% |
संयोजन (0.03, 0.02) PnL +51% देता है, लेकिन OAT इस पर कभी विचार नहीं करेगा क्योंकि निश्चित mtf_entry_sell = 0.01 के साथ, मान htf_entry_sell = 0.03 केवल +35% देता है। OAT स्थानीय इष्टतम (0.02, 0.01) में "फंस" गया है और वैश्विक इष्टतम (0.03, 0.02) को नहीं देख सकता।
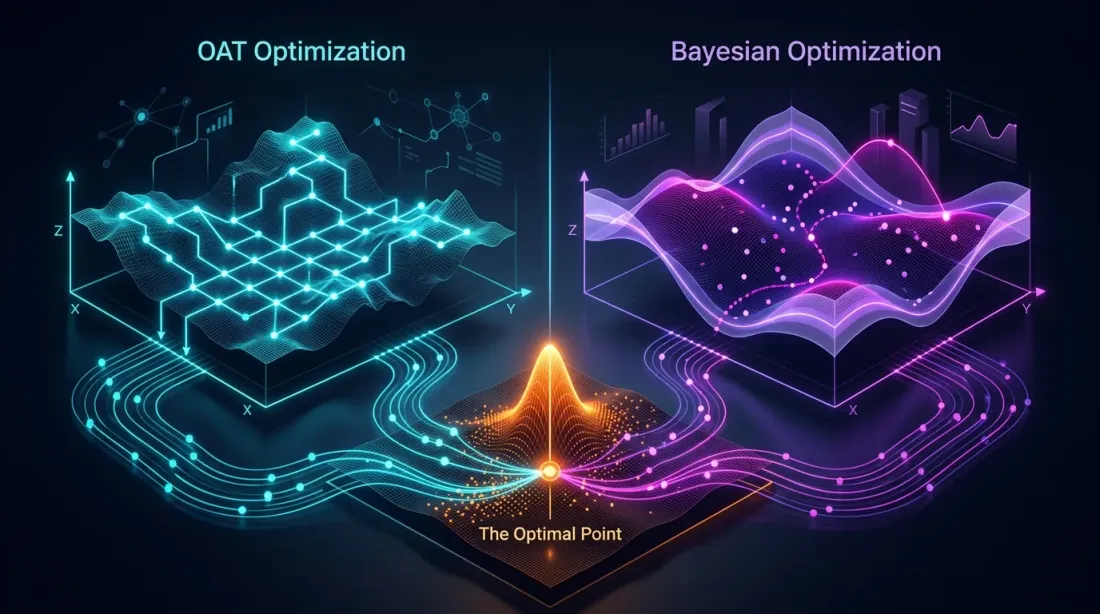
यह एक क्लासिक समस्या है: यदि ऑब्जेक्टिव फंक्शन परिदृश्य में विकर्ण कटक (diagonal ridges) शामिल हैं (जब एक पैरामीटर का इष्टतम दूसरे के बदलने के साथ स्थानांतरित होता है), तो OAT उन्हें चूक जाता है।
समस्या को औपचारिक बनाना
मान लें ऑब्जेक्टिव फंक्शन (PnL) है। OAT एक ऐसा बिंदु खोजता है जहां:
लेकिन यह वैश्विक इष्टतम के लिए एक आवश्यक शर्त है, पर्याप्त नहीं। यदि हेसियन मैट्रिक्स में महत्वपूर्ण ऑफ-डायगोनल तत्व हैं — तो OAT होने पर क्रॉस-डेरिवेटिव्स को ध्यान में नहीं रखता।
युग्मित पैरामीटरों (कई टाइमफ्रेम पर एक ही दिशा के थ्रेशोल्ड) के लिए — इंटरैक्शन नियम हैं, अपवाद नहीं। उच्च टाइमफ्रेम पर एंट्री थ्रेशोल्ड तय करता है कि कौन से सिग्नल मध्य तक पहुंचते हैं, और मध्य पर थ्रेशोल्ड निम्न पर फ़िल्टरिंग प्रभावशीलता तय करता है। योगात्मक पैरामीटरों (अलग-अलग दिशाएं, स्वतंत्र फ़िल्टर) के लिए क्रॉस-डेरिवेटिव्स शून्य के करीब होते हैं — और OAT अच्छी तरह काम करता है।
बायेसियन अनुकूलन: स्मार्ट खोज
विचार
अंधी गणना या लालची खोज के बजाय, बायेसियन अनुकूलन ऑब्जेक्टिव फंक्शन का एक सरोगेट मॉडल बनाता है और हर चरण में उस बिंदु का चयन करता है जहां अपेक्षित सुधार अधिकतम होता है।
एल्गोरिदम:
- कई यादृच्छिक बिंदु चुनें, ऑब्जेक्टिव फंक्शन का मूल्यांकन करें
- एक सरोगेट मॉडल बनाएं (देखे गए बिंदुओं से का सन्निकटन करता है)
- अधिकतम अपेक्षित सुधार (एक्विजिशन फंक्शन) वाला बिंदु खोजें
- उस बिंदु पर ऑब्जेक्टिव फंक्शन का मूल्यांकन करें
- सरोगेट मॉडल को अपडेट करें
- चरण 3-5 दोहराएं
OAT से मुख्य अंतर: बायेसियन अनुकूलन सभी पैरामीटरों पर एक साथ विचार करता है और पैरामीटर स्पेस में विकर्ण कटक (diagonal ridges) की खोज कर सकता है।
TPE (Tree-structured Parzen Estimator)
TPE Optuna में डिफ़ॉल्ट सैंपलर है। को सीधे मॉडल करने के बजाय, TPE दो वितरणों को मॉडल करता है:
- — उन पैरामीटरों का वितरण जहां ऑब्जेक्टिव फंक्शन थ्रेशोल्ड से बेहतर है
- — उन पैरामीटरों का वितरण जहां ऑब्जेक्टिव फंक्शन थ्रेशोल्ड से खराब है
TPE का एक्विजिशन फंक्शन — अनुपात:
TPE उन बिंदुओं को चुनता है जहां बड़ा है (पैरामीटर "अच्छे" के समान) और छोटा है (पैरामीटर "बुरे" के असमान)।
TPE बैकटेस्ट के लिए उपयुक्त क्यों है:
- पैरामीटरों के बीच सशर्त निर्भरताओं को संभालता है
- ऑब्जेक्टिव फंक्शन की निरंतरता की आवश्यकता नहीं है
- मध्यम बजट (100-1000 इटरेशन) के साथ कुशल
- श्रेणीबद्ध और असतत पैरामीटरों का समर्थन करता है
गॉसियन प्रोसेस (GP)
TPE का एक विकल्प — गॉसियन प्रोसेस। GP को एक बहुभिन्नरूपी सामान्य प्रक्रिया के रूप में मॉडल करता है और न केवल मान भविष्यवाणी प्रदान करता है, बल्कि प्रत्येक बिंदु पर अनिश्चितता भी प्रदान करता है।
जहां माध्य है, सहप्रसरण फंक्शन (कर्नेल) है।
GP अच्छा काम करता है जब:
- कुछ ही पैरामीटर हों (10-15 तक)
- ऑब्जेक्टिव फंक्शन स्मूथ हो
- हर रन महंगा हो (मिनट, घंटे)
पूर्व-गणना किए गए Parquet कैश के साथ बैकटेस्ट के लिए, जहां एक रन में ~1 सेकंड लगता है, आमतौर पर TPE को प्राथमिकता दी जाती है: यह मॉडल को तेज़ी से बनाता है और 500+ इटरेशन तक बेहतर स्केल करता है।
Optuna के साथ व्यावहारिक एकीकरण
पूर्ण कार्यशील उदाहरण
import optuna
from optuna.samplers import TPESampler
import numpy as np

# ─── Assumes data is precomputed (see article on Parquet cache) ───
# htf_pre, mtf_pre, ltf_pre — DataFrames with precomputed indicators

def run_backtest(htf_pre, mtf_pre, ltf_pre, **params) -> dict:
    """
    Runs a backtest with given parameters.
    Returns a dict with metrics: pnl, max_dd, n_trades, trading_time, sharpe.
    Uses precomputed Parquet cache — ~1 second per run.
    """
    # ... backtest implementation ...
    pass


def objective(trial: optuna.Trial) -> float:
    """Objective function for Optuna."""
    params = {
        # Entry thresholds — higher timeframe
        "htf_entry_sell": trial.suggest_float("htf_entry_sell", 0.0, 0.05, step=0.005),
        "htf_entry_buy":  trial.suggest_float("htf_entry_buy",  0.0, 0.05, step=0.005),

        # Entry thresholds — middle timeframe
        "mtf_entry_sell": trial.suggest_float("mtf_entry_sell", 0.0, 0.05, step=0.005),
        "mtf_entry_buy":  trial.suggest_float("mtf_entry_buy",  0.0, 0.05, step=0.005),

        # Entry thresholds — lower timeframe
        "ltf_entry_sell": trial.suggest_float("ltf_entry_sell", 0.0, 0.05, step=0.005),
        "ltf_entry_buy":  trial.suggest_float("ltf_entry_buy",  0.0, 0.05, step=0.005),

        # Exit thresholds
        "htf_exit_sell":  trial.suggest_float("htf_exit_sell",  0.0, 0.03, step=0.005),
        "htf_exit_buy":   trial.suggest_float("htf_exit_buy",   0.0, 0.03, step=0.005),
        "mtf_exit_sell":  trial.suggest_float("mtf_exit_sell",  0.0, 0.03, step=0.005),
        "mtf_exit_buy":   trial.suggest_float("mtf_exit_buy",   0.0, 0.03, step=0.005),

        # Additional parameters
        "min_hold_bars":  trial.suggest_int("min_hold_bars", 1, 20),
        "trail_pct":      trial.suggest_float("trail_pct", 0.001, 0.02, step=0.001),
    }

    result = run_backtest(htf_pre, mtf_pre, ltf_pre, **params)

    # Optuna minimizes, so we invert PnL
    return -result["pnl_at_max_lev"]


# Create a study with TPE sampler
study = optuna.create_study(
    sampler=TPESampler(seed=42),
    study_name="strategy_optimization",
    direction="minimize",
)

# Run optimization: 500 iterations
study.optimize(objective, n_trials=500, show_progress_bar=True)

# Results
print(f"Best PnL: {-study.best_value:.2f}%")
print(f"Best params: {study.best_params}")
print(f"Total trials: {len(study.trials)}")
प्रति बैकटेस्ट ~1 सेकंड पर (पूर्व-गणना किए गए कैश के साथ):
संपूर्ण खोज के 8,950 वर्षों की तुलना में आठ मिनट। और TPE 500 इटरेशन में ऐसे संयोजन खोज लेता है जिन्हें OAT 96 में चूक जाता है, क्योंकि यह एक समय में एक अक्ष के बजाय पैरामीटर स्पेस को एक साथ खोजता है।
एक स्टडी को सहेजना और फिर से शुरू करना
import optuna

# Save to SQLite — can resume after restart
study = optuna.create_study(
    storage="sqlite:///optuna_study.db",
    study_name="strategy_v2",
    sampler=TPESampler(seed=42),
    direction="minimize",
    load_if_exists=True,  # continue if study already exists
)

# First run: 300 iterations
study.optimize(objective, n_trials=300)

# ... script restart ...

# Continuation: 200 more iterations using previous results
study.optimize(objective, n_trials=200)
बाधाएं जोड़ना
सभी पैरामीटर संयोजन मान्य नहीं होते। उदाहरण के लिए, निकास थ्रेशोल्ड एंट्री थ्रेशोल्ड से अधिक नहीं होना चाहिए:
def objective_with_constraints(trial: optuna.Trial) -> float:
    htf_entry = trial.suggest_float("htf_entry_sell", 0.0, 0.05, step=0.005)
    htf_exit  = trial.suggest_float("htf_exit_sell",  0.0, 0.03, step=0.005)

    # Constraint: exit threshold <= entry threshold
    if htf_exit > htf_entry:
        raise optuna.TrialPruned()

    # ... remaining parameters and backtest ...
    result = run_backtest(htf_pre, mtf_pre, ltf_pre, **params)
    return -result["pnl_at_max_lev"]
सैंपलर तुलना
Optuna कई सैंपलरों का समर्थन करता है। हर एक की अपनी ताकत है।
TPESampler (डिफ़ॉल्ट)
sampler = optuna.samplers.TPESampler(
    n_startup_trials=20,  # random trials before modeling begins
    seed=42,
)
- सिद्धांत: Tree-structured Parzen Estimator
- ताकत: मिश्रित पैरामीटर प्रकारों के लिए अच्छा, 1000+ इटरेशन तक स्केल करता है
- कमजोरी: मजबूत पैरामीटर इंटरैक्शन के साथ कम कुशल हो सकता है
- कब उपयोग करें: डिफ़ॉल्ट रूप से, यदि दूसरा चुनने का कोई कारण नहीं है
CmaEsSampler
sampler = optuna.samplers.CmaEsSampler(seed=42)
- सिद्धांत: Covariance Matrix Adaptation Evolution Strategy — एक इवोल्यूशनरी एल्गोरिदम जो सहप्रसरण मैट्रिक्स को अनुकूलित करता है
- ताकत: निरंतर पैरामीटरों के बीच इंटरैक्शन खोजने में उत्कृष्ट, सहसंबंधों को ध्यान में रखता है
- कमजोरी: श्रेणीबद्ध पैरामीटरों का समर्थन नहीं करता, इनिशियलाइज़ेशन के लिए अधिक इटरेशन चाहिए
- कब उपयोग करें: यदि सभी पैरामीटर निरंतर हैं और आपको मजबूत इंटरैक्शन का संदेह है
GPSampler
sampler = optuna.samplers.GPSampler(seed=42)
- सिद्धांत: एक्विजिशन फंक्शन के साथ गॉसियन प्रोसेस
- ताकत: सर्वश्रेष्ठ सैंपल दक्षता (अच्छे परिणाम के लिए कम इटरेशन), अनिश्चितता अनुमान प्रदान करता है
- कमजोरी: इटरेशन गिनती में — होने पर धीमा
- कब उपयोग करें: यदि एक बैकटेस्ट महंगा है (मिनट) और बजट 100-200 इटरेशन तक सीमित है
RandomSampler (बेसलाइन)
sampler = optuna.samplers.RandomSampler(seed=42)
- सिद्धांत: एकसमान यादृच्छिक सैंपलिंग
- ताकत: स्थानीय इष्टतम में नहीं फंसता, पूर्ण स्पेस कवरेज
- कमजोरी: पिछले परिणामों का उपयोग नहीं करता
- कब उपयोग करें: तुलना के लिए बेसलाइन के रूप में, या खोजपूर्ण विश्लेषण के लिए
QMCSampler
sampler = optuna.samplers.QMCSampler(seed=42)
- सिद्धांत: Quasi-Monte Carlo (Sobol/Halton अनुक्रम) — यादृच्छिक सैंपलर की तुलना में स्पेस को अधिक समान रूप से भरता है
- ताकत: RandomSampler से बेहतर स्पेस कवरेज, पुनरुत्पादनीयता
- कमजोरी: परिणामों के अनुकूल नहीं होता
- कब उपयोग करें: TPE पर स्विच करने से पहले पहले 50-100 इटरेशन के लिए
सारांश तालिका
| सैंपलर | प्रकार | इंटरैक्शन | श्रेणीबद्ध | सर्वोत्तम बजट |
|---|---|---|---|---|
| TPE | बायेसियन | आंशिक | हां | 100-1000 |
| CmaEs | इवोल्यूशनरी | हां | नहीं | 200-2000 |
| GP | बायेसियन | हां | सीमित | 50-200 |
| Random | यादृच्छिक | नहीं | हां | कोई भी (बेसलाइन) |
| QMC | अर्ध-यादृच्छिक | नहीं | नहीं | 50-500 |
व्यावहारिक बेंचमार्क
import optuna
import time

def benchmark_sampler(sampler, n_trials=300):
    """Compare samplers on the same task."""
    study = optuna.create_study(sampler=sampler, direction="minimize")

    start = time.time()
    study.optimize(objective, n_trials=n_trials, show_progress_bar=False)
    elapsed = time.time() - start

    return {
        "best_value": -study.best_value,
        "elapsed_sec": elapsed,
        "best_trial": study.best_trial.number,
    }

samplers = {
    "TPE":    optuna.samplers.TPESampler(seed=42),
    "CmaEs":  optuna.samplers.CmaEsSampler(seed=42),
    "GP":     optuna.samplers.GPSampler(seed=42),
    "Random": optuna.samplers.RandomSampler(seed=42),
    "QMC":    optuna.samplers.QMCSampler(seed=42),
}

for name, sampler in samplers.items():
    result = benchmark_sampler(sampler, n_trials=300)
    print(f"{name:8s}: best PnL={result['best_value']:.2f}%, "
          f"found at trial #{result['best_trial']}, "
          f"time={result['elapsed_sec']:.1f}s")
12 पैरामीटरों वाली रणनीति के लिए विशिष्ट परिणाम:
| सैंपलर | सर्वश्रेष्ठ PnL | इटरेशन पर पाया गया | सैंपलर ओवरहेड |
|---|---|---|---|
| TPE | ~51% | ~180 | कम |
| CmaEs | ~49% | ~250 | मध्यम |
| GP | ~48% | ~90 | होने पर उच्च |
| Random | ~42% | ~270 | न्यूनतम |
| QMC | ~43% | ~200 | न्यूनतम |
TPE और CmaEs अंतिम PnL में यादृच्छिक खोज से लगातार 15-20% बेहतर प्रदर्शन करते हैं। GP पहले अच्छे परिणाम खोजता है लेकिन बड़ी संख्या में इटरेशन के साथ एक कम्प्यूटेशनल सीमा से टकराता है।
मल्टी-ऑब्जेक्टिव अनुकूलन: PnL बनाम MaxDD
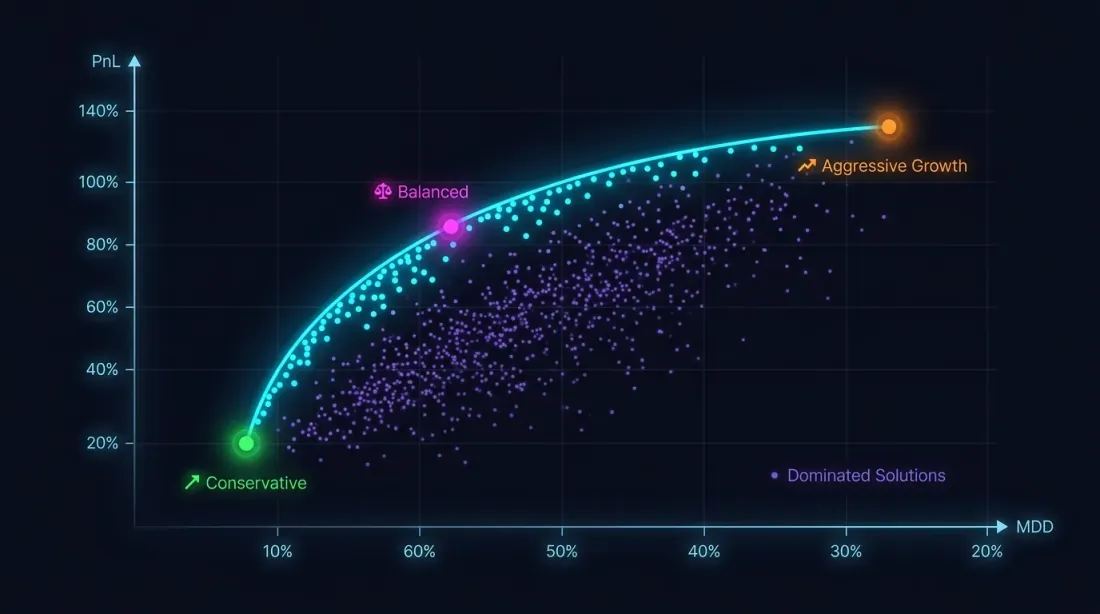
एकल मानदंड पर्याप्त क्यों नहीं है
ड्रॉडाउन बाधाओं के बिना PnL को अधिकतम करना तबाही की ओर एक रास्ता है। नुकसान-लाभ असममिति के कारण, PnL +80% और MaxDD -30% वाली रणनीति, PnL +50% और MaxDD -5% वाली रणनीति की तुलना में काफी अधिक जोखिम भरी है।
अनुकूलन समस्या वास्तव में मल्टी-ऑब्जेक्टिव है:
ये लक्ष्य परस्पर विरोधी हैं: आक्रामक पैरामीटर PnL और ड्रॉडाउन दोनों को बढ़ाते हैं। समाधान एक बिंदु नहीं, बल्कि एक पैरेटो फ्रंट है: समाधानों का एक सेट जहां आप दूसरे को बिगाड़े बिना एक मेट्रिक को बेहतर नहीं कर सकते।
Optuna में NSGA-II / NSGA-III
import optuna

def multi_objective(trial: optuna.Trial) -> tuple[float, float]:
    """Multi-objective function: (PnL, MaxDD)."""
    params = {
        "htf_entry_sell": trial.suggest_float("htf_entry_sell", 0.0, 0.05, step=0.005),
        "htf_entry_buy":  trial.suggest_float("htf_entry_buy",  0.0, 0.05, step=0.005),
        "mtf_entry_sell": trial.suggest_float("mtf_entry_sell", 0.0, 0.05, step=0.005),
        "mtf_entry_buy":  trial.suggest_float("mtf_entry_buy",  0.0, 0.05, step=0.005),
        "ltf_entry_sell": trial.suggest_float("ltf_entry_sell", 0.0, 0.05, step=0.005),
        "ltf_entry_buy":  trial.suggest_float("ltf_entry_buy",  0.0, 0.05, step=0.005),
        "htf_exit_sell":  trial.suggest_float("htf_exit_sell",  0.0, 0.03, step=0.005),
        "htf_exit_buy":   trial.suggest_float("htf_exit_buy",   0.0, 0.03, step=0.005),
        "mtf_exit_sell":  trial.suggest_float("mtf_exit_sell",  0.0, 0.03, step=0.005),
        "mtf_exit_buy":   trial.suggest_float("mtf_exit_buy",   0.0, 0.03, step=0.005),
        "min_hold_bars":  trial.suggest_int("min_hold_bars", 1, 20),
        "trail_pct":      trial.suggest_float("trail_pct", 0.001, 0.02, step=0.001),
    }

    result = run_backtest(htf_pre, mtf_pre, ltf_pre, **params)

    pnl = result["pnl"]          # maximize
    max_dd = result["max_dd"]    # minimize (already a negative number)

    return pnl, max_dd  # Optuna: both directions are set in create_study


# NSGA-III — better than NSGA-II with 3+ criteria
study = optuna.create_study(
    directions=["maximize", "minimize"],
    sampler=optuna.samplers.NSGAIIISampler(seed=42),
    study_name="multi_objective_strategy",
)

study.optimize(multi_objective, n_trials=500)

# Pareto front
pareto_trials = study.best_trials
print(f"Pareto front: {len(pareto_trials)} solutions")

for t in pareto_trials[:5]:
    print(f"  PnL={t.values[0]:.2f}%, MaxDD={t.values[1]:.2f}%")
पैरेटो फ्रंट पर एक बिंदु चुनना
पैरेटो फ्रंट कई समाधान देता है। एक कैसे चुनें?
def select_from_pareto(
    pareto_trials: list,
    max_dd_limit: float = -5.0,
    min_pnl: float = 20.0,
) -> list:
    """
    Filter the Pareto front by constraints.

    max_dd_limit: maximum acceptable drawdown (e.g., -5%)
    min_pnl: minimum acceptable PnL (%)
    """
    filtered = []
    for trial in pareto_trials:
        pnl, max_dd = trial.values
        if max_dd >= max_dd_limit and pnl >= min_pnl:
            # Calculate MaxLev (as in the article on asymmetry)
            max_lev = min(50 / abs(max_dd), 100) if max_dd != 0 else 100
            pnl_at_max_lev = pnl * max_lev
            filtered.append({
                "trial": trial,
                "pnl": pnl,
                "max_dd": max_dd,
                "max_lev": max_lev,
                "pnl_at_max_lev": pnl_at_max_lev,
            })

    # Sort by PnL at maximum leverage
    filtered.sort(key=lambda x: x["pnl_at_max_lev"], reverse=True)
    return filtered
ध्यान दें: अधिकतम लीवरेज पर PnL की गणना करते समय, फंडिंग रेट्स को ध्यान में रखना आवश्यक है, अन्यथा वास्तविक बाज़ार में सैद्धांतिक रूप से उच्च लीवरेज नुकसान में बदल जाएगा। इसके अतिरिक्त, अंतिम PnL एक एकल-बिंदु अनुमान है, और परिणाम की स्थिरता का आकलन करने के लिए मोंटे कार्लो बूटस्ट्रैप की आवश्यकता होती है।
उदाहरण: पैरेटो फ्रंट पर तीन रणनीतियां
| रणनीति | PnL | MaxDD | MaxLev | PnL@MaxLev | ट्रेडिंग समय |
|---|---|---|---|---|---|
| रणनीति A | ~55% | ~0.9% | ~55x | ~3025% | ~15% |
| रणनीति B | ~25% | ~0.75% | ~66x | ~1650% | ~5% |
| रणनीति C | ~300% | ~17% | ~3x | ~900% | ~45% |
+300% के प्रभावशाली PnL वाली रणनीति C उच्च ड्रॉडाउन के कारण PnL@MaxLev के अनुसार सबसे कम आकर्षक साबित होती है। रणनीति A नेट लीवरेज्ड रिटर्न में आगे है, लेकिन सक्रिय समय प्रति PnL को ध्यान में रखते हुए, रणनीति B बेहतर हो सकती है — मुक्त समय का 95% अन्य रणनीतियों से भरा जा सकता है।
कंटूर प्लॉट और पैरामीटर महत्व
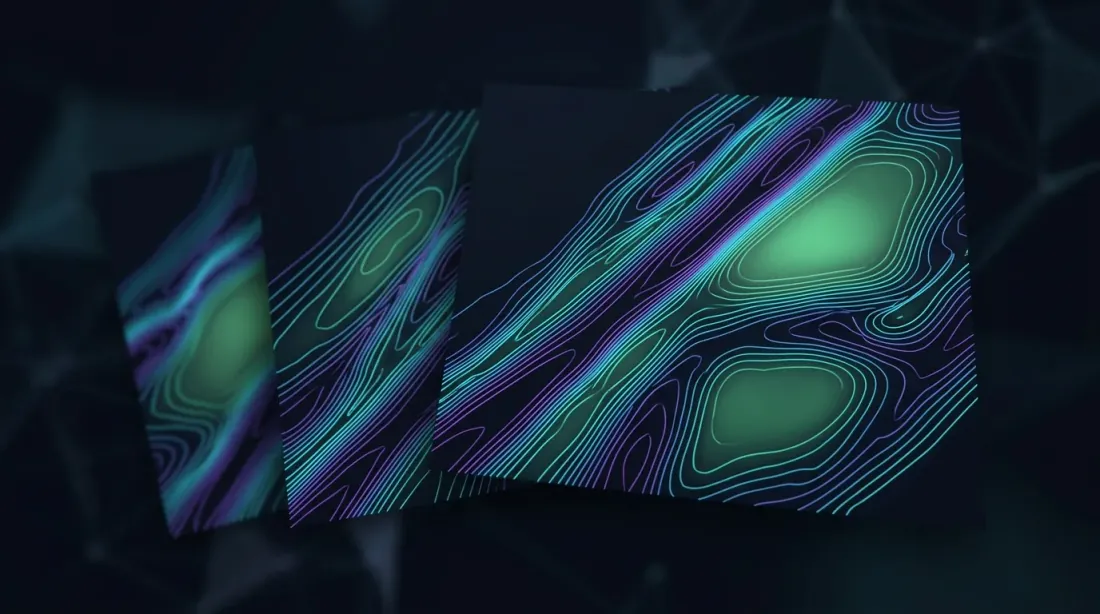
परिदृश्य विज़ुअलाइज़ेशन
अनुकूलन के बाद — विज़ुअलाइज़ेशन। Optuna अंतर्निहित उपकरण प्रदान करता है:
import optuna.visualization as vis

# Contour plot: how a pair of parameters affects the objective function
fig_contour = vis.plot_contour(
    study,
    params=["htf_entry_sell", "mtf_entry_sell"],
)
fig_contour.show()

# Importance: which parameters matter most
fig_importance = vis.plot_param_importances(study)
fig_importance.show()

# Optimization history: how the result improved
fig_history = vis.plot_optimization_history(study)
fig_history.show()

# Parallel coordinate plot: visualizing dependencies
fig_parallel = vis.plot_parallel_coordinate(
    study,
    params=["htf_entry_sell", "mtf_entry_sell", "ltf_entry_sell"],
)
fig_parallel.show()

# Slice plot: how each parameter affects the result
fig_slice = vis.plot_slice(study)
fig_slice.show()
कंटूर प्लॉट: इंटरैक्शन पढ़ना
एक कंटूर प्लॉट पैरामीटरों की एक जोड़ी के लिए ऑब्जेक्टिव फंक्शन का दो-आयामी क्रॉस-सेक्शन बनाता है। यदि आइसोलाइन एक अक्ष के समानांतर हैं — तो पैरामीटर इंटरैक्ट नहीं करते, और OAT ने वही इष्टतम पाया होता। यदि आइसोलाइन विकर्ण हैं — तो एक इंटरैक्शन है, और OAT चूक जाएगा।
# Build contour plots for all pairs of key parameters
key_params = ["htf_entry_sell", "mtf_entry_sell", "ltf_entry_sell",
              "htf_entry_buy",  "mtf_entry_buy",  "ltf_entry_buy"]

for i, p1 in enumerate(key_params):
    for p2 in key_params[i+1:]:
        fig = vis.plot_contour(study, params=[p1, p2])
        fig.write_image(f"contour_{p1}_vs_{p2}.png")
यदि एक कंटूर प्लॉट एक पठार (plateau) दिखाता है — एक क्षेत्र जहां ऑब्जेक्टिव फंक्शन बहुत कम बदलता है — तो यह एक अच्छा संकेत है। एक पठार का मतलब है कि परिणाम छोटे पैरामीटर विचलनों के प्रति मजबूत है। पठार विश्लेषण और ओवरफिटिंग से इसके संबंध के बारे में अधिक जानकारी — आगामी लेख पठार विश्लेषण में।
पैरामीटर महत्व
# fANOVA-based importance
importance = optuna.importance.get_param_importances(study)
for param, imp in importance.items():
    print(f"{param:20s}: {imp:.4f}")
विशिष्ट आउटपुट:
htf_entry_sell      : 0.2841
mtf_entry_sell      : 0.2103
ltf_entry_sell      : 0.1567
trail_pct           : 0.1204
htf_entry_buy       : 0.0892
...
0.01 से कम महत्व वाले पैरामीटरों को उनके डिफ़ॉल्ट मान पर तय किया जा सकता है — यह समस्या की आयामीयता को कम करता है और अनुकूलन को तेज़ करता है। लेकिन सावधान रहें: कम महत्व का मतलब यह भी हो सकता है कि पैरामीटर केवल अन्य के साथ इंटरैक्शन में महत्वपूर्ण है। कंटूर प्लॉट के माध्यम से सत्यापित करें।
पूर्व-गणना किया गया कैश: प्रति बैकटेस्ट 1 सेकंड सब कुछ क्यों बदल देता है
एक बैकटेस्ट की गति यह तय करती है कि आप कौन सी अनुकूलन विधि वहन कर सकते हैं।
| बैकटेस्ट समय | 96 OAT | 500 TPE | 2000 CmaEs |
|---|---|---|---|
| 60 सेकंड | 1.6 घंटे | 8.3 घंटे | 33 घंटे |
| 10 सेकंड | 16 मिनट | 83 मिनट | 5.5 घंटे |
| 1 सेकंड | 1.5 मिनट | 8 मिनट | 33 मिनट |
| 0.1 सेकंड | 10 सेकंड | 50 सेकंड | 3.3 मिनट |
प्रति बैकटेस्ट 60 सेकंड पर, 500 TPE इटरेशन में 8 घंटे लगते हैं। अभी भी सहनीय, लेकिन इटरेट करना (ऑब्जेक्टिव फंक्शन बदलना, पुनः प्रारंभ करना) महंगा है। 1 सेकंड पर — 8 मिनट, और आप प्रतिदिन दर्जनों प्रयोग चला सकते हैं।
यही सटीक कारण है कि Parquet कैश में पूर्व-गणना केवल एक गति अनुकूलन नहीं है, बल्कि उपलब्ध विधियों के स्थान का विस्तार है। कैश के बिना आप OAT या 100 GP इटरेशन तक सीमित हैं। कैश के साथ — आप 2000 CmaEs इटरेशन या एक पूर्ण मल्टी-ऑब्जेक्टिव NSGA-III वहन कर सकते हैं।
import pyarrow.parquet as pq
import time

# Load precomputed cache — once
t0 = time.time()
htf_pre = pq.read_table("cache/htf_indicators.parquet").to_pandas()
mtf_pre = pq.read_table("cache/mtf_indicators.parquet").to_pandas()
ltf_pre = pq.read_table("cache/ltf_indicators.parquet").to_pandas()
print(f"Cache loaded in {time.time() - t0:.2f}s")  # ~0.3s

# Backtest uses precomputed data — only threshold application
t1 = time.time()
result = run_backtest(htf_pre, mtf_pre, ltf_pre, htf_entry_sell=0.02, ...)
print(f"Backtest in {time.time() - t1:.2f}s")  # ~1.0s
व्यावहारिक सिफारिशें
OAT कब उपयोग करें
निम्नलिखित मामलों में OAT उचित है:
-
खोजपूर्ण विश्लेषण। आप अभी एक रणनीति की खोज शुरू कर रहे हैं और यह समझना चाहते हैं कि कौन से पैरामीटर परिणाम को प्रभावित करते हैं। 1.5 मिनट में 96 रन — एक उत्कृष्ट शुरुआती बिंदु।
-
योगात्मक पैरामीटर। ट्रेडों के गैर-अतिव्यापी उपसमुच्चयों पर काम करने वाले पैरामीटरों के लिए (सेल बनाम बाय दिशाएं, विभिन्न उपकरण), OAT तेज़ी से एक सही परिणाम देगा।
-
बहुत महंगा बैकटेस्ट। यदि एक रन में 10+ मिनट लगते हैं और तेज़ नहीं किया जा सकता, तो 96 रन (16 घंटे) वाला OAT 500 TPE इटरेशन (3.5 दिन) की तुलना में बेहतर है।
Optuna कब उपयोग करें
अधिकांश मामलों में Optuna बेहतर है:
-
3 से अधिक पैरामीटर। इंटरैक्शन व्यावहारिक रूप से निश्चित हैं — OAT इष्टतम को चूक जाएगा।
-
मल्टी-टाइमफ्रेम रणनीतियां। विभिन्न टाइमफ्रेम पर थ्रेशोल्ड लगभग हमेशा आपस में जुड़े होते हैं।
-
अंतिम अनुकूलन। जब रणनीति ने मोंटे कार्लो बूटस्ट्रैप पास कर लिया है और आप इसकी मजबूती को लेकर आश्वस्त हैं — Optuna सर्वश्रेष्ठ पैरामीटर खोजेगा।
-
मल्टी-ऑब्जेक्टिव समस्याएं। PnL बनाम MaxDD बनाम ट्रेडिंग समय — OAT सिद्धांत रूप से इस समस्या को हल नहीं कर सकता।
हाइब्रिड दृष्टिकोण: योगात्मक के लिए OAT + युग्मित के लिए Optuna
आपको OAT और Optuna के बीच चुनने की जरूरत नहीं है — इन्हें संयोजित करना बेहतर है:
-
पैरामीटरों को वर्गीकृत करें। योगात्मक (स्वतंत्र) और युग्मित (इंटरैक्टिव) में विभाजित करें। 12 पृथक्करण पैरामीटरों के लिए उदाहरण:
- योगात्मक:
htf_entry_sell<->htf_entry_buy,mtf_entry_sell<->mtf_entry_buy,ltf_entry_sell<->ltf_entry_buy(सेल/बाय — अलग-अलग दिशाएं, गैर-अतिव्यापी ट्रेडों पर काम करती हैं) - युग्मित समूह सेल:
htf_entry_sell,mtf_entry_sell,ltf_entry_sell(फ़िल्टरिंग चेन: सेल सिग्नल के लिए HTF -> MTF -> LTF) - युग्मित समूह बाय:
htf_entry_buy,mtf_entry_buy,ltf_entry_buy
- योगात्मक:
-
योगात्मक के लिए OAT। सेल और बाय समूहों को स्वतंत्र रूप से अनुकूलित करें। यदि सेल पैरामीटर बाय ट्रेडों को प्रभावित नहीं करते — तो OAT मिनटों में एक सही परिणाम देगा।
-
युग्मित के लिए Optuna। प्रत्येक समूह के भीतर (सेल: एंट्री+एग्ज़िट के 6 पैरामीटर) TPE का उपयोग करें। 12 के बजाय 6 पैरामीटर — बजट आधा हो जाता है।
# Step 1: OAT for additive pairs
sell_params = oat_sweep(sell_param_grid, run_backtest, initial_params)

# Step 2: Optuna for the coupled sell group
def objective_sell(trial):
    params = sell_params.copy()
    params["htf_entry_sell"] = trial.suggest_float("htf_entry_sell", 0.0, 0.05, step=0.005)
    params["mtf_entry_sell"] = trial.suggest_float("mtf_entry_sell", 0.0, 0.05, step=0.005)
    params["ltf_entry_sell"] = trial.suggest_float("ltf_entry_sell", 0.0, 0.05, step=0.005)
    # exit parameters for sell are also coupled with entry
    params["htf_exit_sell"] = trial.suggest_float("htf_exit_sell", 0.0, 0.02, step=0.001)
    params["mtf_exit_sell"] = trial.suggest_float("mtf_exit_sell", 0.0, 0.02, step=0.001)
    params["ltf_exit_sell"] = trial.suggest_float("ltf_exit_sell", 0.0, 0.02, step=0.001)
    return -run_backtest(**params)["effective_score"]

study = optuna.create_study(sampler=optuna.samplers.TPESampler())
study.optimize(objective_sell, n_trials=300)  # 6 parameters → 300 is enough
पूर्ण अनुकूलन पाइपलाइन
1. Precompute Parquet cache (once)
2. Classify parameters: additive vs coupled
3. OAT for additive (~50 runs, ~1 min) → fix
4. Optuna TPE for coupled groups (300 iterations x 2 groups, ~10 min)
5. Optuna NSGA-III for meta-parameters (500 iterations, ~8 min) → Pareto front
6. Contour plots → visualize interactions
7. Monte Carlo bootstrap of best points → confidence intervals
8. Walk-Forward → out-of-sample validation
चरण 8 — walk-forward अनुकूलन — ओवरफिटिंग से सुरक्षा के लिए महत्वपूर्ण है। इसके बारे में अधिक जानकारी आगामी लेख Walk-Forward में।
अनुकूलन के जोखिम
ओवरफिटिंग। जितने अधिक पैरामीटर और जितना सटीक अनुकूलन — रणनीति को ऐतिहासिक डेटा में फिट करने का जोखिम उतना ही अधिक। 12 पैरामीटरों के साथ 500 Optuna इटरेशन एक ऐसा संयोजन खोजेंगे जो ट्रेनिंग सेट पर पूरी तरह से काम करता है, लेकिन नए डेटा पर बेकार है।
सुरक्षा:
- डेटा को ट्रेन/टेस्ट (70/30) में विभाजित करें
- स्थिरता का आकलन करने के लिए मोंटे कार्लो बूटस्ट्रैप का उपयोग करें
- walk-forward के माध्यम से सत्यापित करें
- पठारों पर समाधानों को प्राथमिकता दें (इसके बारे में अधिक जानकारी पठार विश्लेषण में)
बहु-तुलना समस्या। यदि आप 500 संयोजनों का परीक्षण करते हैं, तो यादृच्छिक रूप से एक "अच्छा" परिणाम खोजने की संभावना बढ़ जाती है। Bonferroni सुधार या FDR (False Discovery Rate) नियंत्रण मदद करते हैं, लेकिन आसान दृष्टिकोण आउट-ऑफ-सैंपल सत्यापन है।
अपर्याप्त बजट। 12 पैरामीटरों के लिए 50 इटरेशन वाला TPE बहुत कम है। पहले 20 इटरेशन यादृच्छिक (स्टार्टअप) होते हैं, जिससे मॉडलिंग के लिए केवल 30 बचते हैं। न्यूनतम बजट: 12 पैरामीटरों के लिए इटरेशन, अनुशंसित: ।
Freqtrade: यह एक उत्पादन फ्रेमवर्क में कैसे काम करता है
Freqtrade — लोकप्रिय एल्गो-ट्रेडिंग फ्रेमवर्कों में से एक — Hyperopt मॉड्यूल के माध्यम से अंदरूनी रूप से Optuna का उपयोग करता है। इसका अनुभव हमारी सिफारिशों की पुष्टि करता है:
- सैंपलर: TPE (डिफ़ॉल्ट), GP, CmaEs, NSGA-II, QMC — सभी कॉन्फ़िगरेशन के माध्यम से उपलब्ध
- लॉस फंक्शन: 12 अंतर्निहित लॉस फंक्शन, जिनमें ShortTradeDurHyperOptLoss, SharpeHyperOptLoss, MaxDrawDownHyperOptLoss शामिल हैं
- मल्टी-ऑब्जेक्टिव: कई मेट्रिक्स के एक साथ अनुकूलन के लिए NSGA-II और NSGA-III का समर्थन
- कस्टम सैंपलर: किसी भी Optuna-संगत सैंपलर को प्लग करने की क्षमता
Freqtrade इकोसिस्टम से एक प्रमुख सबक: अंतर्निहित लॉस फंक्शन विशिष्ट परिदृश्यों को कवर करते हैं, लेकिन गंभीर अनुकूलन के लिए आपको एक कस्टम ऑब्जेक्टिव फंक्शन की आवश्यकता है जो आपकी रणनीति की विशिष्टताओं को ध्यान में रखता है — सक्रिय समय, फंडिंग लागत, सटीक फिल सिमुलेशन के लिए अनुकूली ड्रिल-डाउन।
निष्कर्ष
Coordinate Descent (OAT) एक तेज़ और सहज विधि है। 12 पैरामीटरों के लिए इसे केवल 96 रन चाहिए और यह डेढ़ मिनट में समाप्त हो जाता है। लेकिन यह पैरामीटर इंटरैक्शन के प्रति अंधा है — और मल्टी-टाइमफ्रेम रणनीतियों में, इंटरैक्शन लगभग हमेशा मौजूद होते हैं।
Optuna (TPE, GP, CmaEs) के माध्यम से बायेसियन अनुकूलन समग्र रूप से पैरामीटर स्पेस की खोज करता है। पूर्व-गणना किए गए Parquet कैश के साथ 8 मिनट में 500 इटरेशन — ऐसे संयोजन खोजते हैं जो OAT के लिए अदृश्य हैं।
मल्टी-ऑब्जेक्टिव अनुकूलन (NSGA-III) "PnL को अधिकतम करें" की समस्या को "PnL बनाम MaxDD का पैरेटो फ्रंट बनाएं" की समस्या में बदल देता है — और विभिन्न जोखिम-रिटर्न ट्रेडऑफ के साथ समाधानों का एक सेट प्रदान करता है।
लेकिन अनुकूलन पाइपलाइन का केवल एक हिस्सा है। पाए गए पैरामीटरों को मोंटे कार्लो बूटस्ट्रैप के माध्यम से मान्य किया जाना चाहिए, फंडिंग रेट्स के लिए सही किया जाना चाहिए, सक्रिय समय को ध्यान में रखते हुए पुनर्गणना की जानी चाहिए, और walk-forward सत्यापन से गुजरना चाहिए। श्रृंखला के आगामी लेखों में इस पर अधिक जानकारी।
उपयोगी लिंक
- Optuna: A Next-generation Hyperparameter Optimization Framework (Akiba et al., 2019)
- Algorithms for Hyper-Parameter Optimization (Bergstra et al., 2011) — the original TPE paper
- Optuna Documentation — Samplers
- Optuna Visualization Module
- Hansen, N. — The CMA Evolution Strategy: A Tutorial
- Deb, K. et al. — NSGA-II: A Fast and Elitist Multiobjective Genetic Algorithm (2002)
- Snoek, J. et al. — Practical Bayesian Optimization of Machine Learning Algorithms (2012)
- Freqtrade Documentation — Hyperopt
- Marcos Lopez de Prado — Advances in Financial Machine Learning, Chapter 12
- Bergstra, J. & Bengio, Y. — Random Search for Hyper-Parameter Optimization (2012)
उद्धरण
@article{soloviov2026optuna,
  author = {Soloviov, Eugen},
  title = {Coordinate Descent vs Bayesian Optimization: Which Finds Better Parameters},
  year = {2026},
  url = {https://marketmaker.cc/en/blog/post/optuna-vs-coordinate-descent},
  description = {Why exhaustive search is impossible for 12+ parameters, how coordinate descent misses interactions, and how Optuna with a TPE sampler finds in 500 iterations what OAT cannot find in 96.}
}


