फिडेलिटी गेट: कोर्स-टू-फाइन बैकटेस्टिंग आपको और तेज़ी से बेवकूफ बनाती है, जब तक कि सस्ता प्रॉक्सी वैसे ही रैंक न करे जैसे महंगा वाला करता है
ड्रिल-डाउन / मल्टी-फिडेलिटी सर्च (ASHA, successive halving, Hyperband) हज़ारों कॉन्फ़िग्स को सस्ते में स्क्रीन करती है और केवल बचे हुए (survivors) को महंगे फुल इवैल्यूएशन के लिए आगे बढ़ाती है। यह एक असली स्पीडअप है - लेकिन अगर लो-फिडेलिटी रैंकिंग हाई-फिडेलिटी रैंकिंग से असहमत हो, तो यह चुपचाप ध्वस्त हो जाती है। हमने फोल्ड-रैंक कोरिलेशन को मापा: एक फोल्ड पर Spearman ρ 0.03 तक हो सकता है (लगभग रैंडम रैंकिंग), और जैसे-जैसे फोल्ड्स बढ़ते हैं यह 0.43, 0.67, 0.78, 0.91 तक चढ़ता जाता है। इसका समाधान एक अनिवार्य गेट है - पहले ρ(cheap, full) मापें, और न्यूनतम फिडेलिटी को ऑटोमैटिक रूप से उस पहले रंग (rung) तक बढ़ा दें जहाँ ρ ≥ 0.5 हो।
"बिना भ्रम के बैकटेस्ट" श्रृंखला की एक कड़ी।
हर गंभीर पैरामीटर सर्च एक ही दीवार से टकराता है: स्पेस बेहद विशाल होता है, और हर ईमानदार मूल्यांकन महंगा होता है। एक दर्जन थ्रेशोल्ड और तीन इंडिकेटर पीरियड्स वाली मल्टी-टाइमफ्रेम स्ट्रैटेजी, जिसका मूल्यांकन मल्टी-फोल्ड वॉक-फॉरवर्ड स्प्लिट पर किया जाता है, प्रति कॉन्फ़िगरेशन कुछ सेकंड ले सकती है। दस हज़ार कॉन्फ़िगरेशन का मतलब है कई घंटे। इसलिए आप एक शॉर्टकट ढूंढते हैं, और वह शॉर्टकट हमेशा एक ही विचार होता है: सस्ते में मूल्यांकन करो, केवल बचे हुए (survivors) को ही महंगे टेस्ट के लिए आगे बढ़ाओ। दस हज़ार कॉन्फ़िग्स को एक फोल्ड पर स्क्रीन करें, टॉप कुछ सौ को रखें, और उन्हें सभी फोल्ड्स पर चलाएं। ऑवरली कैंडल्स पर स्क्रीन करें, और केवल फाइनलिस्ट्स के लिए 1-सेकंड तक ड्रिल डाउन करें।
यह कोर्स-टू-फाइन सर्च है — ड्रिल-डाउन, मल्टी-फिडेलिटी, successive halving, Hyperband, ASHA — और यह ऑप्टिमाइज़ेशन के वाकई अच्छे विचारों में से एक है। यह एक दिन के कंप्यूट को एक घंटे में बदल सकता है। हम इसका इस्तेमाल करते हैं। लेकिन यह एक ऐसा जाल छुपाए रखता है जो इतना खामोश है कि इसे इस्तेमाल करने वाले ज़्यादातर लोग कभी इसकी जांच ही नहीं करते, और वह जाल यह है: पूरी विधि यह मान लेती है कि आपका सस्ता प्रॉक्सी कॉन्फ़िगरेशनों को उसी तरह रैंक करता है जैसे महंगा मूल्यांकन करता है। अगर ऐसा नहीं है, तो आप तेज़ी से सर्च नहीं कर रहे। आप अपने भावी विजेताओं को पहले ही गेट पर फेंक रहे हैं और शोर (noise) को आगे बढ़ा रहे हैं — आप बस खुद को और तेज़ी से मूर्ख बना रहे हैं।
यह लेख उस एक माप के बारे में है जो आपको बताता है कि आपका ड्रिल-डाउन असली है या महज़ भ्रम। हमने इसे अपनी ही मल्टी-टाइमफ्रेम सर्च पर चलाया, और जवाब असहज करने वाला था: सबसे सस्ती फिडेलिटी पर, हमारा प्रॉक्सी कॉन्फ़िगरेशनों को लगभग रैंडम रैंक कर रहा था (Spearman ρ ≈ 0.03)। अगर हमने उस फिडेलिटी पर आक्रामक तरीके से प्रूनिंग की होती — जैसा कि हर ऑफ-द-शेल्फ ASHA डिफ़ॉल्ट आपको करने के लिए उकसाता है — तो हम अंततः जीतने वालों को पहले ही राउंड में बाहर कर देते। इसका समाधान एक अनिवार्य गेट है जो सर्च से पहले चलता है: रैंक कोरिलेशन मापें, और उस फिडेलिटी से नीचे प्रून करने से इनकार करें जहाँ यह भरोसेमंद न हो।
मल्टी-फिडेलिटी सर्च असल में क्या है
इन तरीकों के पूरे परिवार का एक ही ढांचा है। आप एक फिडेलिटी (जिसे resource या बजट भी कहा जाता है) परिभाषित करते हैं: एक सस्ते-से-महंगे डायल के रूप में, जो अपने अधिकतम स्तर पर असली ऑब्जेक्टिव देता है। फिर आप कॉन्फ़िगरेशनों को लो फिडेलिटी पर चलाते हैं, उन्हें रैंक करते हैं, सबसे अच्छे हिस्से को रखते हैं, और केवल उन बचे हुए (survivors) को ऊँची फिडेलिटी पर फिर से चलाते हैं — यह तब तक दोहराया जाता है जब तक थोड़े से फाइनलिस्ट्स का फुल फिडेलिटी पर मूल्यांकन नहीं हो जाता।
Successive halving (Jamieson & Talwalkar, 2016) इसका मूल है: N कॉन्फ़िग्स को न्यूनतम रिसोर्स पर शुरू करें, टॉप 1/η को रखें, रिसोर्स को η से गुणा करें, और दोहराएं। Hyperband (Li et al., 2018) successive halving को एक बाहरी लूप में लपेट देता है जो अलग-अलग शुरुआती रिसोर्सेज़ के बीच हेज करता है, ताकि आपको यह अंदाज़ा न लगाना पड़े कि कितनी आक्रामकता से प्रून करना है। ASHA (Li et al., 2020) इसका असिंक्रोनस, पैरेलल-फ्रेंडली संस्करण है। एलिमिनेशन रेट η ही वह एक नॉब है जो ये सब साझा करते हैं; कैनोनिकल डिफ़ॉल्ट है η = 3 — हर रंग (rung) पर टॉप एक-तिहाई को रखें, बजट को तिगुना करें।
फिडेलिटी खुद लगभग कुछ भी हो सकती है जो सस्ते से महंगे की ओर जाकर सच्चाई की ओर अभिसरित (converge) होती हो:
- वॉक-फॉरवर्ड फोल्ड्स की संख्या। 1 फोल्ड पर मूल्यांकन करें, फिर 2, फिर 3, K तक। यह वही फिडेलिटी है जिसका अध्ययन हम आगे करेंगे, क्योंकि यह रोलिंग आउट-ऑफ-सैंपल स्प्लिट वाले बैकटेस्ट के लिए स्वाभाविक फिडेलिटी है।
- कैंडल रिज़ॉल्यूशन। 1-घंटे के बार्स पर स्क्रीन करें, 1-मिनट पर आगे बढ़ाएं, और केवल फाइनलिस्ट्स के लिए 1-सेकंड या रॉ ट्रेड्स तक ड्रिल डाउन करें। यह अडैप्टिव ड्रिल-डाउन का वही विचार है जिसे फिल सिमुलेशन की बजाय सर्च पर लागू किया गया है।
- इतिहास की लंबाई, epochs, डेटासेट सबसैंपल — ये क्लासिक ML फिडेलिटीज़ हैं।
बैकटेस्ट में, फोल्ड्स और रिज़ॉल्यूशन ही वो दो चीज़ें हैं जो मायने रखती हैं, और — यही पूरे लेख का मुख्य बिंदु है — वे समान रूप से सुरक्षित नहीं हैं। इनमें से एक में एक बायस है जो, आप चाहे इसे कितनी भी सावधानी से गेट करें, चुपचाप गलत पैरामीटर चुन लेता है।
वह एक धारणा जिस पर सब कुछ टिका है
जरा लिख लीजिए कि successive halving को सही होने के लिए असल में क्या चाहिए। इसे ऐसा नहीं चाहिए कि सस्ती फिडेलिटी सही ऑब्जेक्टिव वैल्यू दे — किसी को इस बात की परवाह नहीं कि एक फोल्ड, छह फोल्ड्स से अलग Sharpe रिपोर्ट करता है। इसे कुछ कमज़ोर लेकिन कहीं ज़्यादा खास चीज़ चाहिए: सस्ती फिडेलिटी को कॉन्फ़िगरेशनों को उसी तरह रैंक करना चाहिए जैसे महंगी वाली करती है। अगर कॉन्फ़िग A, फुल फिडेलिटी पर कॉन्फ़िग B को हरा देता है, तो A को लो फिडेलिटी पर भी B को हराने की प्रवृत्ति दिखानी चाहिए। बस इतना ही। और यही सब कुछ भी है।
औपचारिक रूप से, वह मात्रा जो यह तय करती है कि ड्रिल-डाउन काम करता है या नहीं, वह है कॉन्फ़िगरेशन स्पेस भर में लो-फिडेलिटी और हाई-फिडेलिटी ऑब्जेक्टिव के बीच का रैंक कोरिलेशन। अगर वह कोरिलेशन ऊँचा है, तो सस्ते राउंड में बचे हुए (survivors) वही कॉन्फ़िग्स हैं जो महंगे राउंड में भी जीतते, और आपने कंप्यूट मुफ़्त में बचा लिया। अगर यह कम है, तो सस्ता राउंड एक रैंडम फ़िल्टर है: यह अच्छे कॉन्फ़िग्स को हटाता है और बुरों को आगे बढ़ाता है, और आपने अपना बजट एक बदतर जवाब की ओर तेज़ी से बढ़ने में खर्च कर दिया। η की कोई बीच वाली सेटिंग आपको नहीं बचाती — एक खराब प्रॉक्सी को हल्के से प्रून करने पर भी विजेता लीक होते रहते हैं; आक्रामक तरीके से प्रून करने पर वे बहा दिए जाते हैं।
यह विफलता हमेशा की तरह अदृश्य होती है। सर्च पूरी होती है, एक चैंपियन रिपोर्ट करती है, और चैंपियन इन-सैंपल में ठीक-ठाक दिखता है। कोई एरर नहीं आता। आपको तभी पता चलता है कि प्रॉक्सी झूठ बोल रहा था जब चैंपियन आउट-ऑफ-सैंपल में बिखर जाता है — और तब तक आप इस विफलता का दोष स्ट्रैटेजी को दे चुके होते हैं, न कि उस सर्च को जिसने इसे चुना था। इसलिए अनुशासन वही है जिस पर यह सीरीज़ बार-बार पहुँचती है: विधि जिस चीज़ को मान लेती है, उसे भरोसा करने से पहले नापें। ड्रिल-डाउन के लिए, नापने वाली चीज़ रैंक कोरिलेशन है, और यह माप सस्ती होती है।
इसे नापना: फिडेलिटी गेट
गेट एक छोटा-सा प्रयोग है जिसे आप असली सर्च शुरू करने से पहले, ठीक उसी स्पेस पर एक बार चलाते हैं जिसे आप सर्च करने वाले हैं। प्रक्रिया यह है:
- पैरामीटर स्पेस से रैंडम तरीके से कुछ सौ कॉन्फ़िगरेशन चुनें (हम ~200 इस्तेमाल करते हैं — एक स्थिर Spearman अनुमान के लिए पर्याप्त, और इतना सस्ता कि वहन किया जा सके)।
- हर एक को हर फिडेलिटी रंग (rung) पर मूल्यांकित करें: 1 फोल्ड पर, 2 फोल्ड्स पर, … पूरे K फोल्ड्स तक। फोल्ड-काउंट फिडेलिटी के लिए यह लगभग मुफ़्त है, क्योंकि जो फोल्ड्स आप सस्ते रंगों (rungs) के लिए कंप्यूट करते हैं वे महंगे वाले में दोबारा इस्तेमाल हो जाते हैं — एक क्युमुलेटिव औसत।
- हर रंग
rके लिए, उन ~200 कॉन्फ़िग्स भर में r-फोल्ड रैंकिंग और फुल K-फोल्ड रैंकिंग के बीच Spearman रैंक कोरिलेशन निकालें। - वह पहला रंग जहाँ ρ एक थ्रेशोल्ड को पार करता है (हम ρ ≥ 0.5 इस्तेमाल करते हैं) वही सबसे उथली फिडेलिटी है जिस पर आपको प्रून करने की अनुमति है। इससे नीचे, रैंकिंग भरोसे लायक होने के लिए बहुत शोरगुल भरी (noisy) है; वहाँ कॉन्फ़िग्स को खत्म नहीं करना चाहिए।
पूरी चीज़ बस दो दर्जन लाइनों की है। इसका मूल हिस्सा:
def fidelity_check(cache, n_probe, seed=7):
    """Spearman ρ: cumulative mean over the first r folds (in FOLD_ORDER)
    vs the full K-fold objective, on n_probe random configs."""
    rng = np.random.default_rng(seed)
    k = len(FOLDS)
    per_fold = np.empty((k, n_probe))
    order_win = np.array([list(FOLDS[fi]) for fi in FOLD_ORDER], np.int64)
    for j in range(n_probe):
        p = _unit_to_params(rng.random(len(PNAMES)))       # random config
        scores, *_ = eval_group(cache, p, _sp_of(p)[None, :], order_win, False)
        per_fold[:, j] = scores[0]                          # score on each fold
    cums = np.cumsum(per_fold, axis=0) / np.arange(1, k + 1)[:, None]  # r-fold mean
    rhos = []
    for r in range(1, k):
        rho = spearmanr(cums[r - 1], cums[-1]).statistic    # r folds vs all K
        rhos.append(0.0 if math.isnan(rho) else rho)
    return rhos
एक जानबूझकर रखी गई डिटेल पर ध्यान दें: फोल्ड्स को FOLD_ORDER में लिया जाता है, जो एक इंटरलीव्ड (interleaved) क्रम है जो कैलेंडर के शुरुआती और आखिरी स्लाइस को बारी-बारी से लेता है (फोल्ड 0, फिर एक बीच का फोल्ड, फिर फोल्ड 1, फिर एक बाद का फोल्ड, …)। यह बात बहुत मायने रखती है और आगे के एक सेक्शन का विषय है: इसका मतलब है कि "1 फोल्ड" इतिहास के बीच में फैला एक स्लाइस है, और "2 फोल्ड्स" एक शुरुआती और एक आखिरी स्लाइस है — कभी भी हाल का लगातार (contiguous) विंडो नहीं। सस्ती फिडेलिटी कम फोल्ड्स इस्तेमाल करके सस्ती होती है, ज़्यादा हाल की फोल्ड्स इस्तेमाल करके नहीं।
नतीजे: एक फोल्ड लगभग रैंडम रैंक करता है
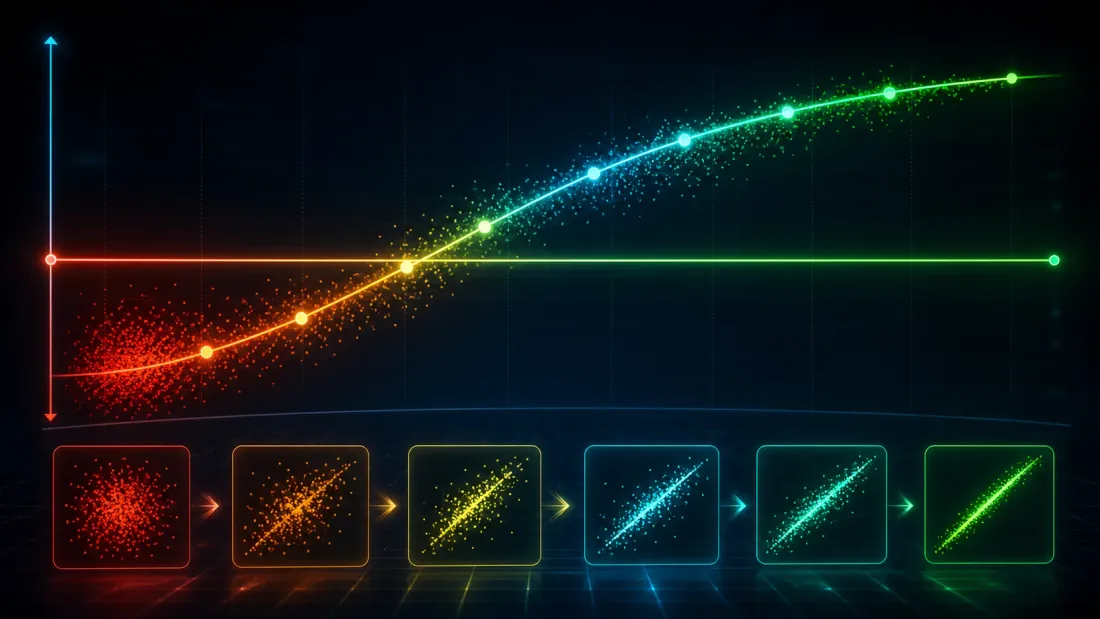
यहाँ बताया गया है कि हमारे दो मल्टी-टाइमफ्रेम सेटअप्स पर चलाए जाने पर गेट ने क्या रिपोर्ट किया। यह संख्या ~200 रैंडम कॉन्फ़िग्स भर में r-फोल्ड रैंकिंग और फुल K-फोल्ड रैंकिंग के बीच Spearman ρ है — यानी सस्ती-फिडेलिटी रैंक कितनी ईमानदारी से फुल-फिडेलिटी रैंक की भविष्यवाणी करती है।
फोल्ड्स r | मल्टी-TF रन | एक कठिन रिजीम |
|---|---|---|
| 1 | +0.43 | +0.03 |
| 2 | +0.67 | +0.43 |
| 3 | +0.78 | +0.78 |
| 4 | +0.82 | — |
| 5 | +0.91 | +0.91 |
पहले कठिन-रिजीम वाला कॉलम पढ़िए, क्योंकि वही चिंताजनक है। एक फोल्ड पर, ρ = 0.03 है। यह कोई कमज़ोर कोरिलेशन नहीं है; यह कोई कोरिलेशन ही नहीं है — दो सौ कॉन्फ़िगरेशनों की एक-फोल्ड रैंकिंग, उन्हें फेंटने (shuffle) से सांख्यिकीय रूप से अलग नहीं पहचानी जा सकती। एक successive-halving रन जो min_resource = 1 पर प्रूनिंग शुरू करने के लिए कॉन्फ़िगर किया गया है (जैसा कि डिफ़ॉल्ट रूप से ज़्यादातर होते हैं), इस रिजीम में अपना पहला और सबसे आक्रामक कट एक सिक्का-उछाल पर करेगा। जो कॉन्फ़िग्स अंततः फुल फिडेलिटी पर जीतते, उनके पास पहले ही राउंड में बचने का महज़ 50/50 मौका है। जब तक आप उस फिडेलिटी तक पहुँचते हैं जहाँ रैंकिंग का कोई मतलब होता है (तीन फोल्ड्स पर ρ = 0.78), तब तक उनमें से ज़्यादातर पहले ही जा चुके होते हैं।
मल्टी-TF कॉलम थोड़ा हल्का है लेकिन वही बात अलग तरीके से बताता है। वहाँ भी, एक फोल्ड ρ = 0.43 देता है — जो हमारे 0.5 गेट से नीचे है। यह एक ठीक-ठाक कोरिलेशन जैसा दिखता है, और असल खतरा यही है: 0.43 इतना ऊँचा है कि आपको बहला दे, और इतना नीचा है कि आपके सबसे अच्छे कॉन्फ़िग्स को लीक कर दे। रैंकिंग केवल दो फोल्ड्स पर (ρ = 0.67) भरोसेमंद बनती है।
इससे दो बातें सामान्यीकृत होती हैं। पहली, एक फोल्ड पर ρ रिजीम पर निर्भर और अविश्वसनीय है — हमने अलग-अलग सेटअप्स में 0.03 से लेकर 0.43 तक मापा, और किसी भी मामले में एक अकेला फोल्ड मानक को पार नहीं कर पाया। दूसरी, ρ लगातार और तेज़ी से बढ़ता है: तीन फोल्ड्स तक दोनों सेटअप्स 0.78 पर पहुँच जाते हैं, और पाँच तक वे 0.91 पर अभिसरित (converge) हो जाते हैं। सिग्नल वहाँ मौजूद है; आपको बस इसे देखने के लिए पर्याप्त फिडेलिटी खर्च करनी होती है। गेट का काम यह है कि वह ठीक वही रंग (rung) ढूंढे जहाँ से "पर्याप्त" शुरू होता है — और उससे नीचे प्रूनिंग को वर्जित करे।
एक अकेला फोल्ड इतना शोरगुल भरा (noisy) क्यों होता है
यह शोर (noise) हमारे फोल्ड निर्माण में कोई बग नहीं है; यह इंट्रिंसिक है, और यह समझना कि क्यों, आपको इसे गलत तरीके से "ठीक" करने से बचाता है। एक अकेला वॉक-फॉरवर्ड फोल्ड एक छोटी विंडो है — एक मार्केट रिजीम के कुछ हफ्ते। उस विंडो पर किसी स्ट्रैटेजी का स्कोर मुख्य रूप से इस बात से तय होता है कि उसके पैरामीटर संयोगवश उस रिजीम में कितनी अच्छी तरह फिट बैठते हैं, जिसका इस बात से बहुत ढीला संबंध है कि वे कितनी अच्छी तरह सामान्यीकृत (generalize) होते हैं। दो कॉन्फ़िग्स जो गुणवत्ता में वाकई अलग हैं, एक अकेले फोल्ड पर सिर्फ इसलिए जगह बदल सकते हैं क्योंकि उनमें से एक ने वह ट्रेंड पकड़ लिया जो संयोगवश उस फोल्ड में मौजूद था। एक फोल्ड पर ऑब्जेक्टिव, उस असली ऑब्जेक्टिव का एक हाई-वेरिएंस एस्टिमेटर है जिसकी आपको वाकई परवाह है, और रैंक कोरिलेशन वही चीज़ है जिसे हाई वेरिएंस सबसे पहले नष्ट करता है — आप किसी एस्टिमेटर के मीन को बचाए रख सकते हैं जबकि उसकी रैंकिंग शुद्ध शोर (noise) हो।
फोल्ड्स जोड़ने से यह वेरिएंस औसतन घट जाता है। हर फोल्ड मार्केट कंडीशंस का आंशिक रूप से स्वतंत्र नमूना (draw) है; r-फोल्ड मीन एक कम-वेरिएंस एस्टिमेटर है, और इसकी रैंकिंग फुल-फिडेलिटी रैंकिंग की ओर अभिसरित होती है। यही वह ठीक-ठीक ρ = 0.03 → 0.43 → 0.78 → 0.91 वाली चढ़ाई है: यह ऑब्जेक्टिव के बदलने की वजह से नहीं, बल्कि इसके रैंक-एस्टिमेट के स्थिर होने की वजह से है, क्योंकि रिजीम-विशिष्ट किस्मत औसत में निकल जाती है। इससे सीख यह मिलती है कि बैकटेस्ट के लिए फिडेलिटी, बुनियादी रूप से इस बारे में है कि आपने कितने स्वतंत्र रिजीम का नमूना लिया है — और रैंक करने के लिए एक लगभग कभी पर्याप्त नहीं होता।
यह यह भी बताता है कि कठिन रिजीम 0.03 से क्यों शुरू होता है जबकि मल्टी-TF रन 0.43 से। कठिन रिजीम में अकेला फोल्ड ज़्यादा रिजीम-विशिष्ट (idiosyncratic) होता है — कॉन्फ़िग्स के एक-फोल्ड स्कोर ज़्यादा किस्मत से और कम टिकाऊ बढ़त (edge) से तय होते हैं, इसलिए वे रैंडम के ज़्यादा करीब रैंक करते हैं। गेट उस अंतर को अपने आप पढ़ लेता है और प्रून करने से पहले ज़्यादा फोल्ड्स की मांग करके प्रतिक्रिया देता है। आपको पहले से यह जानने की ज़रूरत नहीं है कि आप किस रिजीम में हैं; आप इसे नापते हैं।
कोड में गेट: न्यूनतम फिडेलिटी को ऑटो-रेज़ करना
गेट का आउटपुट एक अकेला इंटीजर है: min_resource, यानी सबसे उथली फिडेलिटी जिस पर ASHA को प्रून करने की अनुमति है। नियम यांत्रिक (mechanical) है — रंगों (rungs) में से गुज़रें, और उस पहले रंग को चुनें जिसका ρ थ्रेशोल्ड को पार करता है:
RHO_GATE = 0.5
min_res = len(FOLDS)                      # default: pruning OFF (full fidelity)
rhos = fidelity_check(cache, n_probe=200) # [ρ@1, ρ@2, …, ρ@(K-1)]
passing = [r for r, rho in enumerate(rhos, 1) if rho >= RHO_GATE]
if passing:
    min_res = passing[0]                  # first rung that clears the gate

pruner = SuccessiveHalvingPruner(min_resource=min_res, reduction_factor=3)
इसे दोनों रनों में ट्रेस करके देखिए। मल्टी-TF सेटअप में, ρ@1 = 0.43 गेट में फेल हो जाता है लेकिन ρ@2 = 0.67 इसे पार कर जाता है, इसलिए min_resource को ऑटोमैटिक रूप से बढ़ाकर 2 कर दिया जाता है: ASHA हर कॉन्फ़िग को कम से कम दो फोल्ड्स पर चलाता है इससे पहले कि उसे कुछ भी खत्म करने की अनुमति मिले, फिर वहाँ से सामान्य रूप से प्रून करता है। कठिन रिजीम में, ρ@1 = 0.03 और ρ@2 = 0.43 दोनों फेल होते हैं; ρ@3 = 0.78 पहला है जो पार करता है, इसलिए min_resource 3 बन जाता है। और सबसे अहम फॉलबैक: अगर कोई भी रंग 0.5 तक नहीं पहुँचता, तो passing खाली रहता है और min_resource, K पर ही बना रहता है — प्रूनिंग पूरी तरह बंद कर दी जाती है, और सर्च एक तेज़ लेकिन गलत सर्च होने की बजाय शालीनता से एक सादे फुल-फिडेलिटी सर्च में बदल जाती है। एक ऐसा ड्रिल-डाउन जो अपने प्रॉक्सी को साबित नहीं कर सकता, वह बस प्रून करने से इनकार कर देता है।
यह पूरी फिलॉसफी कंट्रोल-फ्लो की एक लाइन में समाई है। हर successive-halving लाइब्रेरी का डिफ़ॉल्ट है "min_resource = 1 से प्रून करो, सस्ते रंग पर भरोसा करो।" गेट इसकी जगह यह कहता है: "उस पहले रंग से प्रून करो जिसे डेटा भरोसेमंद बताता है, और अगर कोई नहीं है, तो प्रून ही मत करो।" इसकी कीमत पहले से एक ~200-कॉन्फ़िग प्रोब है, और यह ड्रिल-डाउन को एक अंधश्रद्धा (act of faith) से बदलकर एक नापा हुआ फैसला बना देता है। एलिमिनेशन रेट η = 3 वैसा ही रहता है; गेट यह नहीं छूता कि आप कितनी सख्ती से प्रून करते हैं, केवल यह कि आपको कितनी जल्दी शुरू करने की अनुमति है।
ऊपर के कोड में दिखने वाला एक ईमानदार नोट: min_resource को बढ़ाना स्पीडअप में से कुछ खा जाता है। 1 की बजाय 3 फोल्ड्स पर प्रून करने का मतलब है कि हर कॉन्फ़िग — यहाँ तक कि वे भी जिन्हें आप बाद में हटा देंगे — तीन फोल्ड्स की कीमत चुकाता है। यही सही होने की कीमत है, और यह सही सौदा (trade) है: एक ऐसी सर्च पर 2× छोटा स्पीडअप जो असली विजेता ढूंढती है, उस सर्च पर 6× स्पीडअप से बेहतर है जो उन्हें ही हटा देती है। गेट उस सौदे को छुपाने की बजाय स्पष्ट रूप से करता है।
गलत सस्ता एक्सिस: छोटा इतिहास एक जाल है
एक ऐसी सस्ती फिडेलिटी है जो लुभावनी, स्पष्ट, और बायस्ड है, और इसका नाम लेकर बताना ज़रूरी है क्योंकि हर कोई सबसे पहले इसी की ओर बढ़ता है: छोटा इतिहास। पिछले महीने पर कॉन्फ़िग्स को स्क्रीन करें, बचे हुओं (survivors) को पूरे दो साल पर आगे बढ़ाएं। यह मामूली रूप से सस्ता है और कम फोल्ड्स जैसे ही विचार जैसा महसूस होता है। लेकिन यह वैसा नहीं है।
कम फोल्ड्स और छोटा इतिहास एक निर्णायक तरीके से अलग हैं। एक फोल्ड-काउंट फिडेलिटी, अगर सही ढंग से की जाए, तब भी पूरे कैलेंडर को फैलाती है — यह बस इसे ज़्यादा मोटे तौर पर सैंपल करती है। एक छोटी-इतिहास फिडेलिटी कैलेंडर के एक उप-अंतराल (sub-interval) को घनत्व से सैंपल करती है। और मार्केट इतिहास का एक उप-अंतराल एक विशिष्ट रिजीम है। जब आप पिछले महीने पर कॉन्फ़िग्स को रैंक करते हैं, तो आपको उनके फुल-पीरियड रैंक का शोरगुल-भरा-मगर-निष्पक्ष (unbiased) अनुमान नहीं मिल रहा; आपको एक बायस्ड अनुमान मिल रहा है जो व्यवस्थित रूप से उन कॉन्फ़िग्स के पक्ष में जाता है जो पिछले महीने के रिजीम पर ट्यून किए गए हैं। सैंपल साइज़ को जितना चाहें बढ़ा लें — ज़्यादा कॉन्फ़िग्स, ज़्यादा ट्रायल्स पर औसत निकाल लें — बायस कम नहीं होगा, क्योंकि यह वेरिएंस नहीं है। आप उन्हीं कॉन्फ़िग्स को आगे बढ़ाएंगे जो स्क्रीनिंग विंडो में सबसे अच्छी तरह फिट बैठते हैं, और वे ठीक वही हैं जिनके एक क्षणिक रिजीम पर ओवरफिट होने की सबसे ज़्यादा संभावना है।
यही वजह है कि हमारी फिडेलिटी फोल्ड्स में कालानुक्रमिक (chronologically) क्रम की बजाय एक इंटरलीव्ड क्रम में चलती है। पूरे इतिहास में फैले K फोल्ड्स के साथ, "1 फोल्ड" बीच के पास का एक अकेला स्लाइस है, "2 फोल्ड्स" एक शुरुआती और एक आखिरी स्लाइस है, "3 फोल्ड्स" शुरुआती/बीच के/आखिरी में फैलता है — हर फिडेलिटी स्तर, यहाँ तक कि सबसे सस्ता भी, पूरे कैलेंडर भर में सैंपल करता है। सस्ता प्रॉक्सी पूरे पीरियड का एक मोटा (coarse) दृश्य है, कभी भी उसके एक स्लाइस का तीखा (sharp) दृश्य नहीं। यही इंटरलीविंग है जो फोल्ड-काउंट फिडेलिटी को केवल शोरगुल-भरा (जिसे गेट से ठीक किया जा सकता है) बनाती है, न कि बायस्ड (जिसे कोई गेट ठीक नहीं कर सकता — एक बायस्ड टारगेट के खिलाफ ऊँचा ρ बस यह प्रमाणित करता है कि आप भरोसेमंद तरीके से रिजीम-फिट कॉन्फ़िग को ही चुनेंगे)। अगर किसी फिडेलिटी को सस्ता बनाने का आपका एकमात्र तरीका उसे और हाल का बनाना है, तो आपके पास कोई वैध फिडेलिटी नहीं है। इसकी बजाय इसे ज़्यादा मोटा (coarser) बनाएं।
रिज़ॉल्यूशन एक ईमानदार सस्ता एक्सिस के रूप में
दूसरा सस्ता एक्सिस बायस से पूरी तरह बचता है, और यह उस अडैप्टिव ड्रिल-डाउन का स्वाभाविक साथी है जिसका वर्णन हमने फिल सिमुलेशन के लिए किया था: कैंडल रिज़ॉल्यूशन। पूरे स्पेस को 1-घंटे के बार्स पर स्क्रीन करें, बचे हुओं (survivors) को 1-मिनट पर आगे बढ़ाएं, और केवल मुट्ठी भर फाइनलिस्ट्स के लिए 1-सेकंड या रॉ ट्रेड्स तक ड्रिल डाउन करें। उसी पूरे इतिहास पर मोटी (coarser) कैंडल्स का मूल्यांकन करना सस्ता होता है — कम बार्स, तेज़ इंडिकेटर पास, तेज़ सिमुलेशन — और, एक छोटी विंडो के विपरीत, पूरे कैलेंडर का मोटा दृश्य निष्पक्ष (unbiased) होता है: यह हर रिजीम को देखता है, बस इंट्राबार डिटेल कम के साथ।
रिज़ॉल्यूशन और फोल्ड्स एक-दूसरे के पूरक फिडेलिटी एक्सिस हैं, और फिडेलिटी गेट दोनों पर लागू होता है। 1-घंटे की स्क्रीन पर भरोसा करने से पहले, वही प्रोब चलाएं: ~200 कॉन्फ़िग्स लें, उन्हें 1h और 1m पर स्कोर करें, और रैंक कोरिलेशन नापें। अगर ρ(1h, 1m) ऊँचा है, तो घंटों पर स्क्रीनिंग सुरक्षित है और आपने ईमानदारी से एक बड़ा स्पीडअप हासिल किया है। अगर यह कम है — जो तब होता है जब स्ट्रैटेजी की बढ़त (edge) उस इंट्राबार संरचना में रहती है जिसे ऑवरली कैंडल्स धुंधला कर देती हैं — तो उस स्ट्रैटेजी के लिए ऑवरली स्क्रीनिंग एक रैंडम फ़िल्टर है, और गेट आपको बताता है कि ज़्यादा बारीक (finer) से शुरुआत करें। नियम कभी नहीं बदलता: आपको किसी फिडेलिटी पर प्रून करने की अनुमति तभी है जब आपने नाप लिया हो कि उसकी रैंकिंग सच्चाई से सहमत है।
दोनों एक्सिस विपरीत तरीकों से भी विफल होते हैं, जो उपयोगी है। मोटा (coarse) रिज़ॉल्यूशन इंट्राबार जानकारी खोता है; कम फोल्ड्स क्रॉस-रिजीम जानकारी खोते हैं। डेली होराइज़न वाली एक मोमेंटम स्ट्रैटेजी ऑवरली कैंडल्स पर परफेक्ट रैंक कर सकती है लेकिन रिजीम-किस्मत को औसत में निकालने के लिए उसे कई फोल्ड्स चाहिए हो सकते हैं; एक स्कैल्पिंग स्ट्रैटेजी कम फोल्ड्स पर ठीक रैंक कर सकती है लेकिन 1-सेकंड रिज़ॉल्यूशन से ऊपर बिखर सकती है। हर एक्सिस पर अलग से चलाया गया गेट आपको बताता है कि इस विशेष स्ट्रैटेजी के लिए आप किस फिडेलिटी पर सस्ता होना अफोर्ड कर सकते हैं — न कि उस जवाब को मान लेना जो संयोगवश सुविधाजनक लगता है।
बचत असल में कहाँ से आती है
एक चेतावनी जो ड्रिल-डाउन को ईमानदार बनाए रखती है: एक फिडेलिटी कंप्यूट तभी बचाती है जहाँ लागत असल में मौजूद हो। हमारे मल्टी-टाइमफ्रेम इंजन में महंगा हिस्सा है इंडिकेटर्स को प्रीकंप्यूट करना — मल्टी-टाइमफ्रेम HMA और सेपरेशन सिग्नल्स — जिसकी कीमत प्रति कॉन्फ़िगरेशन एक बार, किसी भी फोल्ड के चलने से पहले चुकाई जाती है। कैश्ड सिग्नल्स पर प्रति-फोल्ड सिमुलेशन तुलनात्मक रूप से सस्ता है। इसलिए फोल्ड काउंट पर प्रूनिंग केवल सिमुलेशन लागत बचाती है, उस इंडिकेटर लागत को नहीं जो हावी रहती है; फोल्ड-काउंट फिडेलिटी असली है लेकिन इसकी सीमा (ceiling) उतनी ऊँची नहीं है जितना कच्चा फोल्ड अनुपात बताता प्रतीत होता है।
इसके उलट, रिज़ॉल्यूशन एक्सिस हावी लागत पर सीधे हमला करता है: मोटी कैंडल्स का मतलब है कि इंडिकेटर्स को कंप्यूट करने के लिए उन पर कम बार्स हैं, इसलिए महंगा प्रीकंप्यूट और सस्ता सिमुलेशन दोनों एक साथ घट जाते हैं। यह कोई मामूली डिटेल नहीं है — यह तय करता है कि कौन-सा ड्रिल-डाउन बनाने लायक है। किसी मल्टी-फिडेलिटी सर्च में निवेश करने से पहले, पूछें कि आपके सेकंड्स कहाँ जा रहे हैं। अगर 90% फोल्ड्स भर में साझा किया गया इंडिकेटर प्रीकंप्यूट है, तो फोल्ड-काउंट फिडेलिटी आपको बहुत कम देती है और रिज़ॉल्यूशन फिडेलिटी बहुत ज़्यादा देती है। पहले प्रोफाइल करें; सही सस्ता एक्सिस वही है जो उस लागत को हटाए जो आपके पास असल में है, और उसे फिर भी गेट पार करना होगा।
यह कहाँ जुड़ता है
फिडेलिटी गेट इस सीरीज़ की बैकटेस्ट हाइजीन की श्रृंखला में एक खास जगह पर बैठता है:
- यह ओवरफिटिंग नियंत्रण से अपस्ट्रीम है। एक ऐसा ड्रिल-डाउन जो एक खराब प्रॉक्सी पर प्रून करता है, ओवरफिट करने का एक नया तरीका है — आप एक शोरगुल-भरे शुरुआती रंग को अपने फाइनलिस्ट्स चुनने दे रहे हैं। चैंपियन को अब भी Deflated Sharpe और PBO से बचना होगा, और इन गेट्स को फीड करने वाली ट्रायल्स की गिनती में हर प्रून की गई ट्रायल शामिल होनी चाहिए, न कि केवल बचे हुए (survivors) — प्रूनिंग किसी ट्रायल को मल्टीपल-टेस्टिंग लेजर से मुक्त नहीं कर देती।
- यह अपना दुश्मन पठार विश्लेषण के साथ साझा करता है: एक कॉन्फ़िग जो एक फोल्ड या एक स्क्रीनिंग विंडो में जीतता है और कहीं और नहीं, वही रिजीम-फिट आर्टिफैक्ट है जिसे रोकने के लिए दोनों टूल मौजूद हैं। गेट ऐसे फोल्ड पर चुनने से इनकार करता है; पठार विश्लेषण एक ऐसे चैंपियन पर भरोसा करने से इनकार करता है जो अकेले एक फोल्ड पर टिका हो।
- यह नीचे एक ईमानदार वॉक-फॉरवर्ड स्प्लिट मान लेता है — फोल्ड्स जो पूरे कैलेंडर में फैले हों, आउट-ऑफ-सैंपल अलग रखा गया हो — और यह उस ड्रिल-डाउन का सर्च-टाइम समकक्ष है जो हमने फिल सिमुलेशन के लिए बनाया था: वही कोर्स-टू-फाइन सिद्धांत, लेकिन किन कॉन्फ़िग्स का मूल्यांकन करना है पर लागू, न कि उन्हें कितनी सटीकता से फिल करना है पर।
- और यह पूरी तरह इस बात पर निर्भर करता है कि फिडेलिटी हर रंग पर लीक-फ्री हो। अगर सस्ते रंग में लुक-अहेड बायस है जो महंगे वाले में नहीं है, तो ρ एक दूषित (contaminated) टारगेट के साथ सहमति नापता है और गेट एक लीक को प्रमाणित कर देता है। रैंक कोरिलेशन नापें, हाँ — लेकिन एक ईमानदार ऑब्जेक्टिव पर।
एकीकृत विचार, फिर से, वही है जिसे यह सीरीज़ दोहराना बंद नहीं करेगी: एक बैकटेस्ट एक सांख्यिकीय प्रयोग है, और इसमें हर शॉर्टकट एक परिकल्पना (hypothesis) है जिसे आप परखने के लिए बाध्य हैं। ड्रिल-डाउन की परिकल्पना है "सस्ती रैंक ≈ महंगी रैंक।" यह ~200 कॉन्फ़िग्स में परखने योग्य है। इसे परखें।
मुख्य निष्कर्ष
- कोर्स-टू-फाइन सर्च एक धारणा पर टिकी है: सस्ता प्रॉक्सी कॉन्फ़िग्स को उसी तरह रैंक करता है जैसे महंगा वाला करता है। एक जैसी वैल्यू नहीं — एक जैसी रैंकिंग। अगर रैंक कोरिलेशन कम है, तो आक्रामक प्रूनिंग आपके भावी विजेताओं को हटा देती है और शोर (noise) को आगे बढ़ा देती है। आप एक बदतर जवाब की ओर तेज़ी से सर्च करते हैं।
- भरोसा करने से पहले इसे नापें। ~200 रैंडम कॉन्फ़िग्स चुनें, उन्हें हर फिडेलिटी रंग पर स्कोर करें, और हर सस्ते रंग तथा फुल-फिडेलिटी रैंकिंग के बीच Spearman ρ निकालें। यह बस दो दर्जन लाइनें और एक सस्ता प्रोब है।
- एक फोल्ड लगभग रैंडम रैंक करता है। हमने रिजीम के आधार पर ρ@1 को 0.03 (सिक्का-उछाल) से लेकर 0.43 (फिर भी भरोसे से कम) तक मापा; जैसे-जैसे फोल्ड्स बढ़ते हैं यह 0.67, 0.78, 0.82, और 0.91 तक चढ़ता है। हर ऑफ-द-शेल्फ ASHA का डिफ़ॉल्ट
min_resource = 1, बैकटेस्ट के लिए, आमतौर पर गलत है। - न्यूनतम फिडेलिटी को ऑटोमैटिक रूप से उस पहले रंग तक बढ़ाएं जहाँ ρ ≥ 0.5 हो, और अगर कोई भी पार नहीं करता, तो बिल्कुल प्रून न करें। एक सेटअप के लिए गेट
min_resource = 2बना, और एक कठिन सेटअप के लिए3; फॉलबैक शालीनता से फुल-फिडेलिटी सर्च में बदल जाता है। सही होने की कीमत कुछ स्पीडअप है — इसे चुकाएं। - सस्ता एक्सिस इस आधार पर चुनें कि वह बायस्ड है या नहीं, इस आधार पर नहीं कि वह सस्ता है या नहीं। छोटा इतिहास बायस्ड है — यह रिजीम-फिट पैरामीटर चुनता है और कोई भी सैंपल साइज़ इसे ठीक नहीं करता। पूरे कैलेंडर में फैले (इंटरलीव्ड, न कि लगातार) कम फोल्ड्स का इस्तेमाल करें या पूरे पीरियड पर मोटा रिज़ॉल्यूशन इस्तेमाल करें। और सस्ते एक्सिस को वहाँ खर्च करें जहाँ आपकी लागत असल में मौजूद है।
ड्रिल-डाउन बैकटेस्टिंग के सबसे अच्छे स्पीडअप्स में से एक है, और इसे खुद को और तेज़ी से मूर्ख बनाने के तरीके में बदलना सबसे आसान है। इन दोनों के बीच का फर्क एक अकेली संख्या है जिसे आप सर्च शुरू होने से पहले नाप सकते हैं। अगर आपका प्रॉक्सी यह साबित नहीं कर सकता कि वह सच्चाई की तरह रैंक करता है, तो वह कोई प्रॉक्सी नहीं है — वह एक प्रशंसनीय (plausible) कॉस्ट प्रोफाइल वाला एक रैंडम नंबर जनरेटर है।