Адаптивдүү Drill-Down: Мүнөттөн чийки сатылымдарга чейинки өзгөрмө деталдуулуктагы бэктест
Адаптивдүү дайындар деталдуулугу бэктесттерди кантип ылдамдатат жана сактагычты кантип үнөмдөйт: 1m'ден 1s, 100ms жана чийки сатылымдарга чейин drill-down баа олуттуу өзгөргөн же көлөм секирген жерде гана, бүткүл тарыхый катарда эмес.
Мүнөттүк шамдар бэктесттер үчүн стандарттуу деталдуулук болуп саналат. Бирок бир мүнөттүк шамдын ичинде баа ар кандай кыймылдашы мүмкүн: кээде 0.01%'га, кээде 2%'га. Стоп-лосс менен тейк-профит экөө тең бир мүнөттүк шамдын [low, high] диапазонуна туш келгенде, бэктест кайсынысы биринчи иштегенин билбейт. Бул — толтуруу белгисиздиги (fill ambiguity) көйгөйү.
Жөнөкөй чечим — бүткүл бэктест үчүн секунддук дайындарга өтүү. Бирок эки жылдын ичинде бул ~1 миллион мүнөттүк бардын ордуна ~63 миллион секунддук бар дегенди билдирет. Сактагыч 60 эсе өсөт, ылдамдык ошол пропорцияда төмөндөйт.
Адаптивдүү drill-down бул көйгөйдү чечет: майда деталдуулукту чын эле керек болгон жерде гана колдонуу.
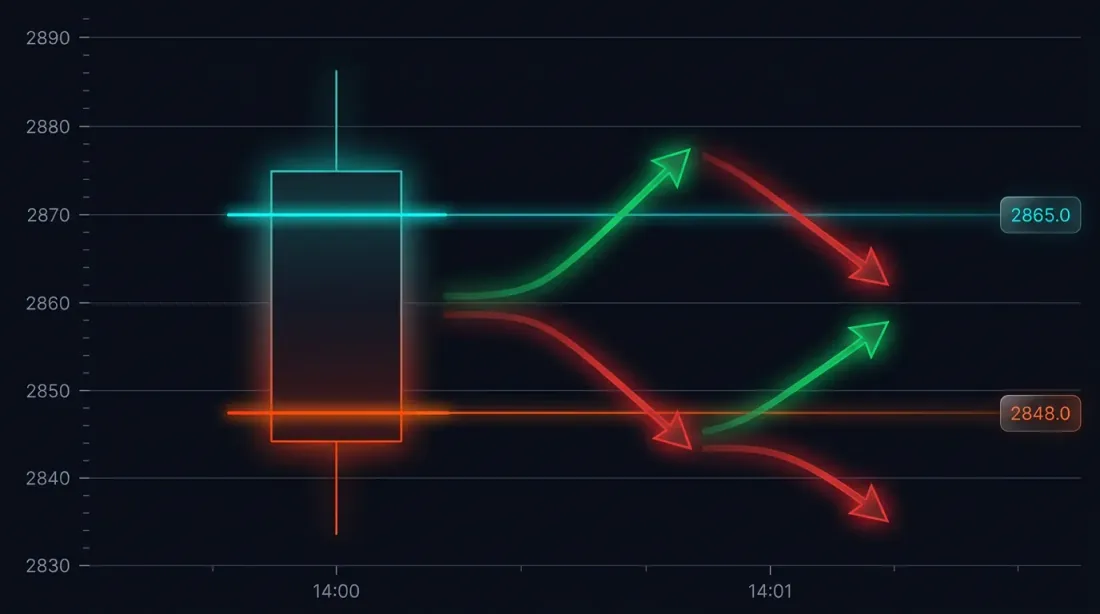
Көйгөй: Чоң шамдардагы толтуруу белгисиздиги
Так бир кырдаалды карап көрөлү. Стратегия 3000 USDT'де лонг ачты. Стоп-лосс: 2970 (-1%). Тейк-профит: 3060 (+2%).
14:37'дөгү мүнөттүк шам:
- Open: 3010
- High: 3065
- Low: 2965
- Close: 3050
SL (2970) да, TP (3060) да [2965, 3065] диапазонуна туш келет. Кайсынысы биринчи иштеди?
Мүмкүн болгон натыйжалар:
- Баа адегенде түштү -> SL иштеди -> -1% чыгым
- Баа адегенде көтөрүлдү -> TP иштеди -> +2% пайда
Бир соода ичиндеги айырма: 3 пайыздык пункт. 10x левередж менен — 30%. Жүздөгөн соодасы бар бэктест үчүн толтуруу белгисиздигин туура эмес чечүү натыйжаларды системалуу түрдө бурмалайт.
Фреймворктар муну демейки боюнча кантип иштетет
Бэктест кыймылдаткычтарынын көбү эки эвристиканын биринен пайдаланат:
- Оптимисттик: адегенде TP иштейт -> ашыкча көрсөтүлгөн натыйжалар
- Пессимисттик: адегенде SL иштейт -> төмөндөтүлгөн натыйжалар
Эки ыкма тең ойлоп табуу болуп саналат. Чыныгы дайындар секунддук же атүгүл миллисекунддук деңгээлде жеткиликтүү, ал көрүүгө мүмкүн болгондо ойлоп табуунун кереги жок.
Drill-Down: Төрт деңгээлдүү стратегия
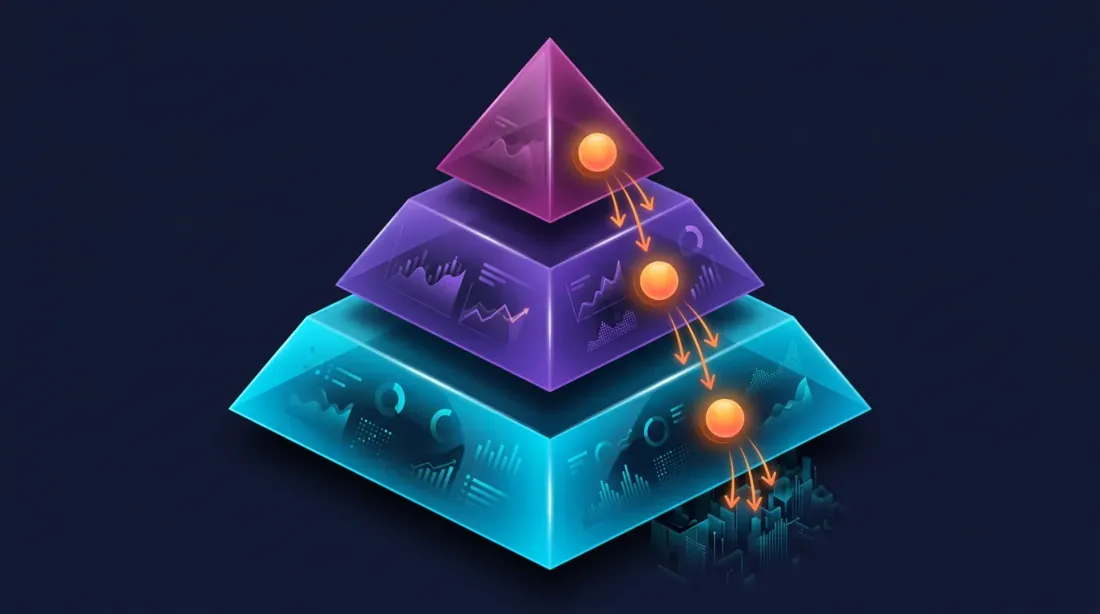
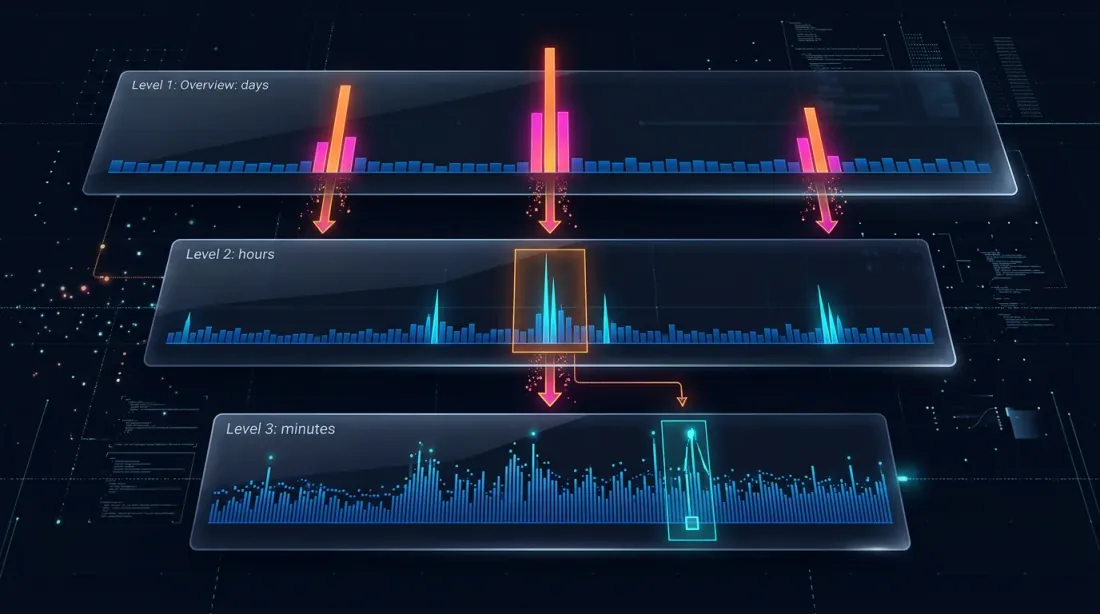
Drill-down идеясы: мүнөт деңгээлинен баштап, белгисиздик болгондо гана — баа кыймылынан же көлөм секирүүлөрүнөн улам — төмөнкү деңгээлге "бургулап түшүү".
Level 1: 1m (minute candles)
  -> If SL or TP is unambiguously outside the [low, high] range — resolve on the spot
  -> If both are within the range — drill down

Level 2: 1s (second candles)
  -> Load 60 second bars for this minute
  -> Walk through second by second: which triggered first?
  -> If a second bar is ambiguous, OR price_move >= min_pct, OR volume >= median_1s * vol_mult — drill down

Level 3: 100ms (millisecond candles)
  -> Load up to 10 bars of 100ms for this second
  -> Walk through 100ms by 100ms
  -> If a 100ms bar is ambiguous, OR price_move >= min_pct, OR volume >= median_100ms * vol_mult — drill down

Level 4: Raw trades
  -> Load individual trades for this 100ms bucket
  -> Resolve the fill at trade-by-trade level — maximum possible precision
Drill-Down керек болбогон учурлар
95% учурларда drill-down талап кылынбайт. Типтүү сценарийлер:
Бир мааниде SL: шамдын high'ы TP'ге жетпейт, low SL'ды бузат -> SL иштеди, drill-down керек эмес.
Бир мааниде TP: low SL'ге жетпейт, high TP'ни бузат -> TP иштеди, drill-down керек эмес.
Экөө тең иштебеди: эки деңгээл тең диапазондон тышкары -> позиция ачык калат.
Гэп аныктоо: кийинки шамдын ачылышы SL же TP аркылуу секирет -> ачылыш баасы боюнча аткаруу, drill-down жок.
Drill-down бары болжол менен ~5% бар үчүн гана керек — эки деңгээл тең бир шамдын диапазонуна туш келгенде.
class AdaptiveFillSimulator:
    """
    Four-level drill-down for determining fill order.
    """
    def __init__(self, data_loader):
        self.loader = data_loader
        self.cache_1s = {}  # Cache of second data by month

    def check_fill(self, timestamp, candle_1m, sl_price, tp_price, side):
        """
        Checks whether SL or TP triggered on the given minute candle.

        Returns: ('sl', fill_price) | ('tp', fill_price) | None
        """
        low, high = candle_1m['low'], candle_1m['high']

        # Gap detection: open breaks through level
        open_price = candle_1m['open']
        if side == 'long':
            if open_price <= sl_price:
                return ('sl', open_price)
            if open_price >= tp_price:
                return ('tp', open_price)
        else:
            if open_price >= sl_price:
                return ('sl', open_price)
            if open_price <= tp_price:
                return ('tp', open_price)

        sl_hit = self._level_hit(sl_price, low, high, side, 'sl')
        tp_hit = self._level_hit(tp_price, low, high, side, 'tp')

        if sl_hit and not tp_hit:
            return ('sl', sl_price)
        if tp_hit and not sl_hit:
            return ('tp', tp_price)
        if not sl_hit and not tp_hit:
            return None

        # Both within range — drill down to 1s
        return self._drill_down_1s(timestamp, sl_price, tp_price, side)

    def _drill_down_1s(self, minute_ts, sl_price, tp_price, side):
        """Level 2: second-by-second pass."""
        bars_1s = self.loader.load_1s_for_minute(minute_ts)

        if bars_1s is None or len(bars_1s) == 0:
            # No second data available — pessimistic fill
            return self._pessimistic_fill(side, sl_price, tp_price)

        for bar in bars_1s:
            sl_hit = self._level_hit(sl_price, bar['low'], bar['high'], side, 'sl')
            tp_hit = self._level_hit(tp_price, bar['low'], bar['high'], side, 'tp')

            if sl_hit and not tp_hit:
                return ('sl', sl_price)
            if tp_hit and not sl_hit:
                return ('tp', tp_price)
            if sl_hit and tp_hit:
                # Both within one second — drill down to 100ms
                result = self._drill_down_100ms(bar['timestamp'], sl_price, tp_price, side)
                if result:
                    return result

        # Could not resolve — pessimistic fill
        return self._pessimistic_fill(side, sl_price, tp_price)

    def _pessimistic_fill(self, side, sl_price, tp_price):
        """Pessimistic assumption: SL for longs, TP for shorts."""
        if side == 'long':
            return ('sl', sl_price)
        else:
            return ('sl', sl_price)
Иштиктүүлүк
| Режим | Бир толтуруу текшерүүсүнө убакыт | Качан колдонулат |
|---|---|---|
| 1m (drill-down жок) | ~0мс | учурлардын ~95% |
| 1s drill-down | ~5мс (айга биринчи кирүү) | учурлардын ~5% |
| 100ms drill-down | ~1мс | учурлардын <0.5% |
| Чийки сатылымдар drill-down | ~0.5мс | учурлардын <0.1% |
~400 соодасы бар 2 жылдык бэктестте drill-down болжол менен 20 шамда чакырылат. Жалпы жүктөм — бүткүл бэктест үчүн 1 секунддан аз.
Адаптивдүү дайындарды сактоо
Drill-down секунддук жана миллисекунддук дайындарды талап кылат. Бирок баарын максималдуу деталдуулукта сактоо практикалык эмес:
| Деталдуулук | 2 жылдагы барлар | Parquet өлчөмү |
|---|---|---|
| 1m | ~1.05М | ~15 МБ |
| 1s | ~63М | ~550 МБ/ай |
| 100ms | ~630М | ~5 ГБ/ай |
2 жылдагы толук 1s архиви болжол менен 13 ГБ түзөт. 100ms — 100 ГБдан ашат. Баарын сактоо мүмкүн, бирок ысырапчыл, себеби drill-down бул дайындардын 1%дан азын гана колдонот.
Hot-Second аныктоо
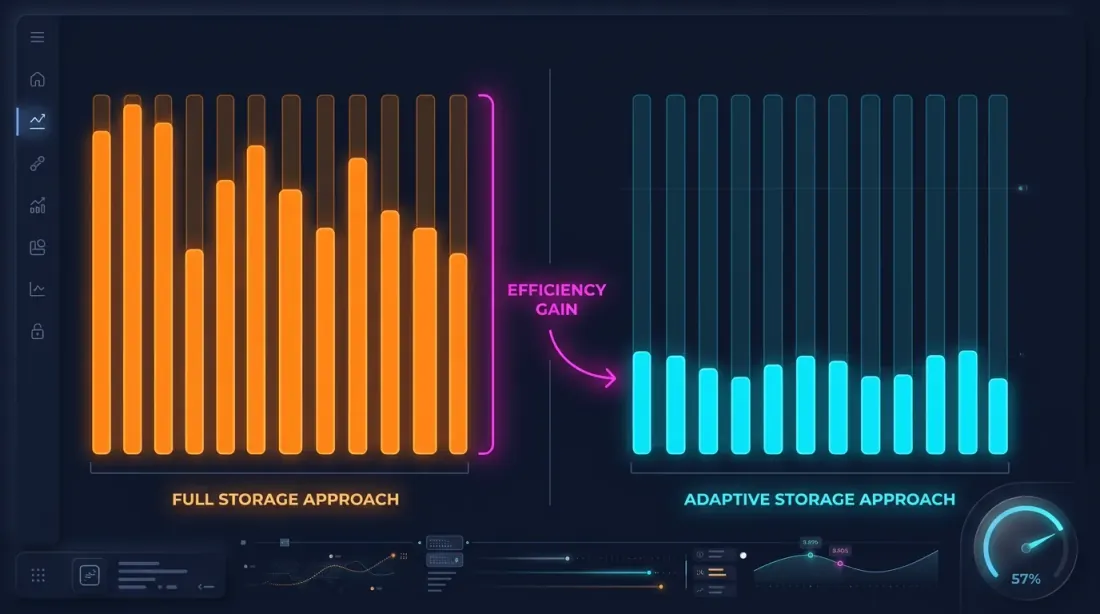
Негизги байкоо: баа олуттуу кыймылдаган секунддар кичине бөлүктү түзөт. Эгер баа секунддун ичинде 0.1%дан аз өзгөрсө — ошол секунд үчүн 100ms бөлүштүрүүнү сактоонун мааниси жок.
Hot-second аныктоо: дайындарды жүктөп алуу жана иштетүү учурунда биз ар бир секундду талдайбыз жана 100ms шамдарын "hot" секунддар үчүн гана — башкача айтканда баа кыймылы босогодон ашкан секунддар үчүн гана — түзөбүз.
def process_trades_adaptive(
    trades: pd.DataFrame,
    min_price_change_pct: float = 1.0,
) -> tuple[pd.DataFrame, pd.DataFrame]:
    """
    Processes raw trades into an adaptive structure:
    - 1s candles for all seconds
    - 100ms candles only for "hot" seconds

    Args:
        trades: DataFrame with columns [timestamp, price, quantity]
        min_price_change_pct: threshold for drill-down to 100ms

    Returns:
        (df_1s, df_100ms_hot) — second candles and 100ms for hot seconds
    """
    # Group by seconds
    trades['second'] = trades['timestamp'].dt.floor('1s')
    df_1s = trades.groupby('second').agg(
        open=('price', 'first'),
        high=('price', 'max'),
        low=('price', 'min'),
        close=('price', 'last'),
        volume=('quantity', 'sum'),
    )

    # Identify hot seconds
    df_1s['price_change_pct'] = (df_1s['high'] - df_1s['low']) / df_1s['open'] * 100
    hot_seconds = df_1s[df_1s['price_change_pct'] >= min_price_change_pct].index

    # Generate 100ms candles only for hot seconds
    hot_trades = trades[trades['second'].isin(hot_seconds)]
    hot_trades['bucket_100ms'] = hot_trades['timestamp'].dt.floor('100ms')

    df_100ms = hot_trades.groupby('bucket_100ms').agg(
        open=('price', 'first'),
        high=('price', 'max'),
        low=('price', 'min'),
        close=('price', 'last'),
        volume=('quantity', 'sum'),
    )

    return df_1s, df_100ms
Сактагычты үнөмдөө
Мисалы — ETHUSDT типтүү айдын ичинде:
| Ыкма | Өлчөмү | Деталдуулук |
|---|---|---|
| Жалгыз 1m | ~1 МБ | 1 мүнөт |
| Баары 1s | ~550 МБ | 1 секунд |
| Баары 100ms | ~5 ГБ | 100 мс |
| Адаптивдүү | ~600 МБ | 1s + 100ms hot секунддар үчүн гана |
min_price_change_pct = 1.0% босогосу менен hot секунддар бардык секунддардын 1%дан азын түзөт. Алар үчүн 100ms дайындары 550 МБ секунддук дайындарга ~50 МБ кошот — эске алынбаган жүктөм.
Эгер секунддук дайындар да адаптивдүү түрдө сакталса (мүнөттүн ичиндеги кыймыл 0.1%дан ашканда гана), көлөмдү дагы 3-5 эсе азайтууга болот.
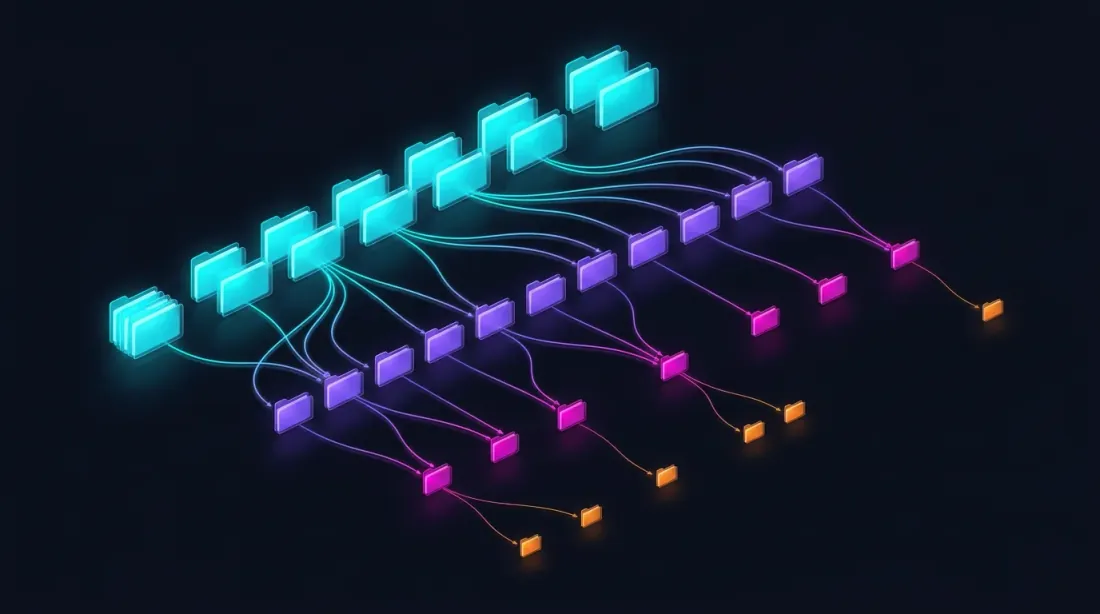
Parquet сактоо структурасы
data/{SYMBOL}/
├── source.json                # Exchange source: {"exchange": "binance"} or {"exchange": "bybit"}
├── stats.json                 # Precomputed median volumes: {"median_volume_1s": ..., "median_volume_100ms": ...}
├── klines_1m/
│   ├── 2024-01.parquet       # ~1 MB
│   ├── 2024-02.parquet
│   └── ...
├── klines_1s/
│   ├── 2024-01.parquet       # ~550 MB
│   └── ...
├── klines_100ms_hot/
│   ├── 2024-01.parquet       # ~50 MB (hot seconds only)
│   └── ...
├── trades_hot/
│   ├── 2024-01.parquet       # Raw trades for hot 100ms buckets
│   └── ...
└── states_1m.parquet          # Precomputed rolling state cache (~112 MB)
Ар бир файл дайындардын бир айын камтыйт. Секунддук, миллисекунддук жана соода дайындары жалкоо (lazy) жүктөлөт — drill-down аны сураганда гана. stats.json файлында көлөмгө негизделген drill-down триггерлери үчүн колдонулган алдын ала эсептелген медиана көлөмдөр бар.
Каржылык дайындар үчүн Parquet оптимизациясы
Каржылык дайындардын өзгөчө касиеттери бар: timestamp'тар монотондуу түрдө өсөт, баалар жылмакай өзгөрөт, көлөмдөр олуттуу өзгөрөт. Оптималдуу орнотуулар:
import pyarrow as pa
import pyarrow.parquet as pq

schema = pa.schema([
    pa.field("timestamp", pa.int32()),    # Seconds from epoch — int32 is sufficient
    pa.field("open",      pa.float32()),
    pa.field("high",      pa.float32()),
    pa.field("low",       pa.float32()),
    pa.field("close",     pa.float32()),
    pa.field("volume",    pa.float32()),
])

# Encoding by column type
column_encodings = {
    "timestamp": "DELTA_BINARY_PACKED",   # Monotonic int -> delta compression
    "open":      "BYTE_STREAM_SPLIT",     # Float -> byte-stream split
    "high":      "BYTE_STREAM_SPLIT",
    "low":       "BYTE_STREAM_SPLIT",
    "close":     "BYTE_STREAM_SPLIT",
    "volume":    "BYTE_STREAM_SPLIT",
}

def save_optimized_parquet(df, path):
    table = pa.Table.from_pandas(df, schema=schema)
    pq.write_table(
        table, path,
        compression="zstd",
        compression_level=9,
        use_dictionary=False,
        write_statistics=False,
        column_encoding=column_encodings,
    )
Бул орнотуулар эмне үчүн колдонулат:
- Timestamp'тар үчүн DELTA_BINARY_PACKED: удаалаш timestamp'тар туруктуу маанисине айырмаланат (1m үчүн 60, 1s үчүн 1). Дельта коддоо аларды нөлгө жакын деңгээлде кысат.
- Float үчүн BYTE_STREAM_SPLIT: float32 байттарын агымдарга бөлөт (бардык биринчи байттар бирге, бардык экинчи байттар бирге, ж.б.у.с.). Жылмакай өзгөргөн баалар үчүн бул стандарттуу коддоодон 2-3 эсе жакшы кысууга жетишет.
- ZSTD деңгээл 9: жагымдуу декомпрессия ылдамдыгы менен жакшы кысуу.
- float64нын ордуна float32: баалар жана көлөмдөр үчүн жетиштүү, эсте сактагычты 50%га үнөмдөйт.
Кэштөө менен жалкоо жүктөө
Drill-down белгилүү бир мүнөт үчүн секунддук дайындарды сурайт. Ар бир суроо-талап үчүн parquet файлын жүктөө жай. Чечим — ай боюнча LRU кэши менен жалкоо жүктөө.
from functools import lru_cache
import pyarrow.parquet as pq
import pandas as pd

class AdaptiveDataLoader:
    """
    Lazy loader with cache: loads second data by month,
    keeps the last N months in memory.
    """
    def __init__(self, symbol: str, data_dir: str = "data", cache_months: int = 2):
        self.symbol = symbol
        self.data_dir = data_dir
        self.cache_months = cache_months
        self._cache_1s: dict[str, pd.DataFrame] = {}

    def load_1s_for_minute(self, minute_ts: pd.Timestamp) -> pd.DataFrame | None:
        """Load 1s data for a specific minute."""
        month_key = minute_ts.strftime("%Y-%m")

        # Load month if not in cache
        if month_key not in self._cache_1s:
            self._load_month_1s(month_key)

        if month_key not in self._cache_1s:
            return None

        df = self._cache_1s[month_key]
        minute_start = minute_ts.floor('1min')
        minute_end = minute_start + pd.Timedelta(minutes=1)

        return df[(df.index >= minute_start) & (df.index < minute_end)]

    def load_100ms_for_second(self, second_ts: pd.Timestamp) -> pd.DataFrame | None:
        """Load 100ms data for a hot second."""
        month_key = second_ts.strftime("%Y-%m")
        path = f"{self.data_dir}/{self.symbol}/klines_100ms_hot/{month_key}.parquet"

        try:
            df = pd.read_parquet(path)
            second_start = second_ts.floor('1s')
            second_end = second_start + pd.Timedelta(seconds=1)
            return df[(df.index >= second_start) & (df.index < second_end)]
        except FileNotFoundError:
            return None

    def _load_month_1s(self, month_key: str):
        """Load a month of 1s data, evict old data from cache."""
        path = f"{self.data_dir}/{self.symbol}/klines_1s/{month_key}.parquet"
        try:
            df = pd.read_parquet(path)
            df.index = pd.to_datetime(df['timestamp'], unit='s')

            # Evict if cache is full
            if len(self._cache_1s) >= self.cache_months:
                oldest = min(self._cache_1s.keys())
                del self._cache_1s[oldest]

            self._cache_1s[month_key] = df
        except FileNotFoundError:
            pass
Drill-Down'ду бэктестингге колдонуу
Бэктест циклине интеграция:
def backtest_with_adaptive_fill(
    states: pd.DataFrame,
    strategy_params: dict,
    data_loader: AdaptiveDataLoader,
) -> list:
    """
    Backtest with adaptive drill-down for fill simulation.
    """
    fill_sim = AdaptiveFillSimulator(data_loader)
    trades = []
    position = None

    for i in range(len(states)):
        row = states.iloc[i]
        ts = states.index[i]

        candle_1m = {
            'open': row['open'], 'high': row['high'],
            'low': row['low'], 'close': row['close'],
            'timestamp': ts,
        }

        if position is not None:
            # Check fill — with drill-down if necessary
            fill = fill_sim.check_fill(
                ts, candle_1m,
                position['sl'], position['tp'],
                position['side'],
            )

            if fill is not None:
                fill_type, fill_price = fill
                trades.append({
                    'entry_time': position['entry_time'],
                    'exit_time': ts,
                    'side': position['side'],
                    'entry_price': position['entry_price'],
                    'exit_price': fill_price,
                    'exit_type': fill_type,
                    'drill_down': fill_sim.last_drill_depth,  # 0, 1, or 2
                })
                position = None
                continue

        # Check entry signal (using precomputed states)
        signal = check_entry_signal(row, strategy_params)
        if signal and position is None:
            position = {
                'side': signal['side'],
                'entry_price': row['close'],
                'entry_time': ts,
                'sl': signal['sl'],
                'tp': signal['tp'],
            }

    return trades
Rolling State Cache менен байланыш
Drill-down топтолгон parquet кэшти толуктайт — алар ар кандай көйгөйлөрдү чечет:
| Rolling state cache | Адаптивдүү drill-down | |
|---|---|---|
| Максат | Туура HTF индикатор маанилери | Так SL/TP аткаруу тартиби |
| Кайда иштейт | Ар бир 1m шамда | Толтуруу белгисиздиги учурунда гана (~5%) |
| Дайындар | Алдын ала эсептелген, туруктуу сакталган | Жалкоо жүктөлгөн, акыркы айлардын кэши |
| Эмнеге таасир этет | Кирүү/чыгуу сигналдары | Аткаруу баасы жана убактысы |
Эки ыкма тең күндүк шам деңгээлинде көрүнбөгөн, бирок чыныгы бэктестинг үчүн маанилүү каталарды жоёт.
Корутунду: Толтуруу симуляциясы ыкмаларын салыштыруу
| Ыкма | Тактык | Ылдамдык | Сактагыч |
|---|---|---|---|
| OHLC эвристикасы (оптимист/пессимист) | Төмөн | Дароо | Жалгыз 1m |
| Толук 1s бэктест | Жогору | Жай (x60) | ~550 МБ/ай |
| Толук 100ms бэктест | Абдан жогору | Абдан жай (x600) | ~5 ГБ/ай |
| Толук чийки сатылымдар бэктести | Максималдуу | Өтө жай | ~50 ГБ/ай |
| Адаптивдүү drill-down (4 деңгээл) | Максималдуу | ~Дароо | 1m + 1s + 100ms hot + сатылымдар hot |
Drill-down 1m бэктесттин ылдамдыгы менен толук 1s бэктесттин тактыгын камсыздайт. Негизги байкоо: жогорку деталдуулук бардык жерде керек эмес — чечим кабыл алуу пункттарында гана.
Көлөмгө негизделген Drill-Down
Баштапкы drill-down баа кыймылында гана иштейт — шамдын [low, high] диапазону толтуруу белгисиздигин жаратуу үчүн жетиштүү кенен болгондо. Бирок баа бардын ичинде кызыктуу бир нерсе болгонунун жападан жалгыз белгиси эмес.
Көлөм секирүүлөрү ошондой эле маанилүү триггер болуп саналат. Көлөмү медианадан 500 эсе жогору секунд, адатта, чоң рыноктук буйрукка, ликвидация каскадына же флэш-крэшке дал келет. Шамдын дене бөлүгү кичине болуп көрүнсө да, ошол секунддун ичиндеги чыныгы баа жолу катуу термелген болушу мүмкүн — OHLC көрүнүшү жашырган чектерге тийип өткөн болушу мүмкүн.
Drill-down шарты эми OR-негизделген: же олуттуу баа кыймылы, ЖЕ аномалдуу көлөм секирүүсү майда деталдуулукка түшүүнү иштетет.
def is_hot(bar, median_volume, min_pct=0.1, vol_mult=500):
    """
    Determines if a bar warrants drill-down to the next level.
    Two independent triggers (OR logic):
      - price moved >= min_pct within the bar
      - volume exceeded median * vol_mult
    """
    price_move = (bar['high'] - bar['low']) / bar['open'] * 100
    return price_move >= min_pct or bar['volume'] >= median_volume * vol_mult
Бул баа-гана аныктоого көрүнбөгөн сценарийлерди кармайт: open=3000, close=3001 болгон бар, бирок көлөмү норманын 50,000 эсе ашкан бар миллисекунддардын ичинде кыска убакытка 2950 менен 3050ге тийип өткөн болушу мүмкүн. Көлөмгө негизделген drill-down болбосо, бэктест бул секундду эч качан жакындан карабайт.
Чийки сатылымдар: төртүнчү деңгээл
Баштапкы үч деңгээлдүү иерархия (1m -> 1s -> 100ms) дагы деле бир боштукту калтырат: бир 100ms челегинин ичинде бир нече сатылым ар кандай баада аткарылышы мүмкүн. high=3060 жана low=2965 болгон челек үчүн биз дагы деле так тартипти билбейбиз.
Чечим: төртүнчү жана акыркы деңгээл катары чийки сатылымдарга чейин drill-down жасоо.
1m candles (base)
  └─> 1s candles    (when 1s shows price_move >= min_pct OR volume >= median_1s * vol_mult)
      └─> 100ms candles  (when hot second detected)
          └─> Raw trades     (when 100ms shows price_move >= min_pct OR volume >= median_100ms * vol_mult)
Чийки сатылымдар деңгээлинде белгисиздик жок — ар бир сатылымдын так баасы жана timestamp'и бар. Толтуруу түпкүлүктүү чечилет:
def resolve_from_trades(trades, sl_price, tp_price, side):
    """
    Walk through individual trades in chronological order.
    The first trade that crosses SL or TP determines the fill.
    """
    for trade in trades:
        price = trade['price']
        if side == 'long':
            if price <= sl_price:
                return ('sl', price)
            if price >= tp_price:
                return ('tp', price)
        else:  # short
            if price >= sl_price:
                return ('sl', price)
            if price <= tp_price:
                return ('tp', price)
    return None
Чийки сатылымдар деңгээли өтө сейрек чакырылат — бардык барлардын 0.1%дан аз — бирок чакырылганда, эч кандай шамга негизделген жакындатуу теңдеше албаган негизги чындыкты (ground truth) берет.
Ар бир өтмө үчүн өзүнчө босоголор
Ар кандай чечимдин өтмөлөрүнүн ар кандай мүнөздөмөлөрү бар. Секунддун ичиндеги 0.1% баа кыймылы маанилүү; 100ms челегинин ичиндеги ошол эле 0.1% чектен ашкан. Ошондой эле, көлөм таралуулары ар бир убакыт масштабында ар башка.
Ар бир деңгээл өтмөсүнүн эми өзүнүн min_pct жана vol_mult параметрлери бар:
1s → 100ms:   --min-pct-1s 0.1   --vol-mult-1s 500
100ms → trades: --min-pct-100ms 0.1 --vol-mult-100ms 500
Бул ар бир өтмөнүн сезгичтигин көз каранды эмес түрдө так тууралоого мүмкүнчүлүк берет. Иш жүзүндө 100ms'ден сатылымдарга өтүү катуураак босогону колдонушу мүмкүн, себеби бир 100ms челеги үчүн чийки сатылымдарды жүктөөнүн наркы минималдуу.
@dataclass
class DrillDownConfig:
    # 1s -> 100ms transition
    min_pct_1s: float = 0.1
    vol_mult_1s: float = 500
    # 100ms -> trades transition
    min_pct_100ms: float = 0.1
    vol_mult_100ms: float = 500
Туруктуу медиана статистикасы
Көлөмгө негизделген drill-down ар бир убакыт масштабындагы медиана көлөмүн билүүнү талап кылат. Ар бир бэктест үчүн медианаларды учурунда эсептөө иштиктүүлүк артыкчылыктарын жокко чыгарат. Чечим: медианаларды бир жолу алдын ала эсептеп, кэштөө.
Ар бир символ үчүн 1s жана 100ms деталдуулугундагы медиана көлөмдөр тарыхый дайындардан эсептелип, stats.json файлында сакталат:
{
  "ETHUSDT": {
    "median_volume_1s": 12.5,
    "median_volume_100ms": 1.8
  },
  "BTCUSDT": {
    "median_volume_1s": 0.45,
    "median_volume_100ms": 0.06
  }
}
Статистика дайындар биринчи жолу жүктөлгөндө символ боюнча бир жолу эсептелип, кийинки бардык бэктесттерде кайра колдонулат. Эгер дайындар жаңыртылса (жаңы айлар жүктөлсө), статистика бара-бара кайра эсептелет.
def compute_median_stats(symbol, data_dir):
    """Compute and cache median volume stats for a symbol."""
    stats_path = f"{data_dir}/{symbol}/stats.json"

    # Load all 1s data, compute median volume
    all_1s = load_all_months(f"{data_dir}/{symbol}/klines_1s/")
    median_1s = all_1s['volume'].median()

    # Load all 100ms hot data, compute median volume
    all_100ms = load_all_months(f"{data_dir}/{symbol}/klines_100ms_hot/")
    median_100ms = all_100ms['volume'].median()

    stats = {
        "median_volume_1s": float(median_1s),
        "median_volume_100ms": float(median_100ms),
    }

    with open(stats_path, 'w') as f:
        json.dump(stats, f, indent=2)

    return stats
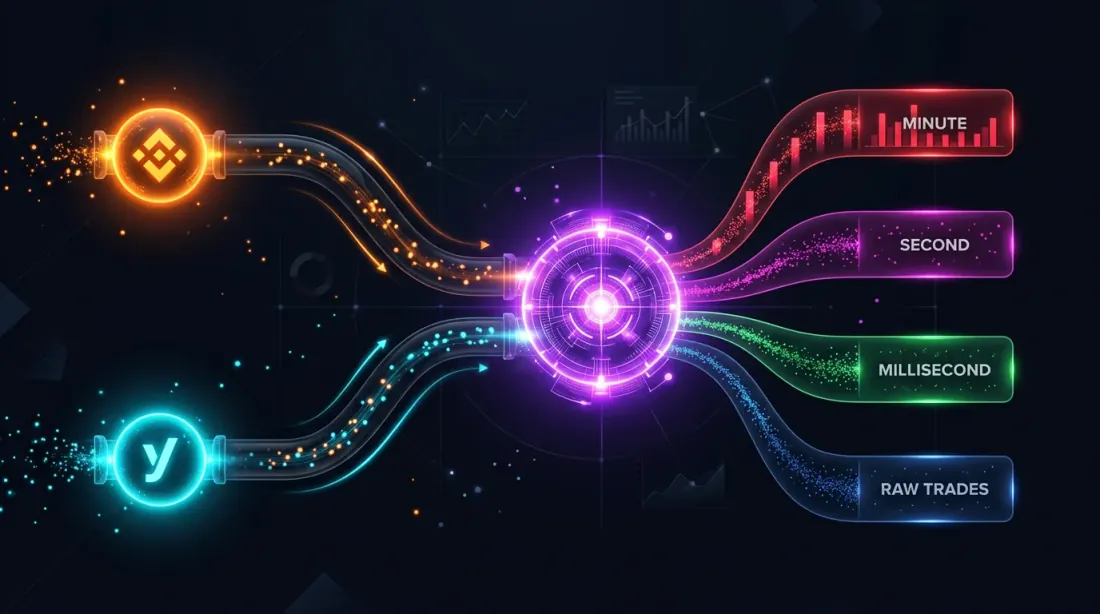
Көп-биржалык колдоо: Bybit
Бардык символдор Binance'та жеткиликтүү эмес. XAUTUSDT (алтын) сыяктуу активдер үчүн дайындар башка биржалардан келиши керек. Drill-down тутуму эми альтернативдүү дайындар булагы катары Bybit'ти колдойт.
Bybit символдору үчүн бардык шам деңгээлдери (1m, 1s, 100ms) жана чийки сатылымдар Bybit'тин чийки сатылым агымынан түзүлөт. Процесс бирдей — чийки сатылымдар ар бир убакыт масштабында шамдарга топтолот — бирок дайындар булагы башкача.
data/{SYMBOL}/
├── source.json              # {"exchange": "bybit"} or {"exchange": "binance"}
├── klines_1m/
│   └── ...
├── klines_1s/
│   └── ...
├── klines_100ms_hot/
│   └── ...
└── trades_hot/              # Raw trades for hot 100ms buckets
    └── ...
Дайындарды жүктөгүч source.json'ду текшерет жана тиешелүү жүктөө түтүгүн колдонот. Бэктест кыймылдаткычынын көз карашы боюнча, дайындардын форматы кайнар биржага карабастан бирдей — drill-down логикасы биржага көз каранды эмес (exchange-agnostic).
Бул өзгөчө биржа аралык стратегиялар же белгилүү бир платформаларда гана соода кылынган символдор үчүн маанилүү.
Корутунду
Адаптивдүү drill-down — жөнөкөй принциптин колдонулушу: эсептөө ресурстарын жана сактагычты дайындардын маанилүүлүгүнө пропорционалдуу түрдө сарптоо.
Төрт деталдуулук деңгээли:
- 1m — барлардын 95%ы үчүн негизги өтүү
- 1s — толтуруу белгисиздиги же көлөм секирүүлөрү учурундагы drill-down
- 100ms — чектен ашкан кыймыл же аномалдуу көлөмдүү hot секунддар үчүн drill-down
- Чийки сатылымдар — hot 100ms челектери үчүн drill-down, жеке сатылым деңгээлинде толтурууну чечүү
Төрт сактоо деңгээли:
- Бардык 1m — толук архив, 2 жылга ~15 МБ
- Бардык 1s — толук же адаптивдүү архив, ~550 МБ/ай
- Жалгыз hot 100ms — секунддардын <1%, ~50 МБ/ай
- Жалгыз hot сатылымдар — эң чектен ашкан 100ms челектери үчүн чийки сатылымдар
Эки drill-down триггери (OR логикасы):
- Баага негизделген: бардын баа диапазону
min_pctдан ашат - Көлөмгө негизделген: бардын көлөмү
median * vol_multдан ашат
Натыйжа: мүнөт деңгээлиндеги ылдамдык менен тик-симулятордун тактыгындагы бэктест. Экспоненциалдуу эмес, сызыктуу өсүүчү сактагыч. Жана биржага көз каранды эмес drill-down логикасы менен бир нече биржаларды — Binance жана Bybit — колдоо.
Мульти-таймфрейм стратегиялар үчүн алдын ала эсептелген кэш жөнүндө көбүрөөк маалымат үчүн Топтолгон Parquet Cache макаласын караңыз. Жогорку левередж учурундагы натыйжаларга фандинг ставкаларынын таасири жөнүндө — Фандинг ставкалары левереджиңизди өлтүрөт.
Пайдалуу шилтемелер
- Apache Parquet — дайындарды сактоо форматы
- Apache Arrow — BYTE_STREAM_SPLIT коддоо
- Zstandard — кысуу алгоритми
- Lopez de Prado — Advances in Financial Machine Learning
- Binance — тарыхый рынок дайындары
Цитата
@article{soloviov2026adaptivedrilldown,
  author = {Soloviov, Eugen},
  title = {Adaptive Drill-Down: Backtest with Variable Granularity from Minutes to Raw Trades},
  year = {2026},
  url = {https://marketmaker.cc/ru/blog/post/adaptive-resolution-drill-down-backtest},
  description = {How adaptive data granularity speeds up backtests and saves storage: drill-down from 1m to 1s, 100ms, and raw trades only where price moved significantly or volume spiked.}
}